



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une semaine après l'arrivée de GPT-6 Sol dans le catalogue, OpenAI a lancé son successeur. GPT-6.1 Sol est sorti le mardi 29 septembre et figure déjà dans le catalogue de modèles de la passerelle IA de TrueFoundry, avec ses tarifs, ses limites de contexte et ses capacités renseignés.
Vous pouvez l'appeler via le même point de terminaison compatible OpenAI que vous utilisez pour tout le reste. Pas de nouveau SDK, pas d'intégration séparée, pas d'attente liée à une mise à jour de la passerelle. Modifiez simplement la chaîne du modèle par gpt-6.1-sol sur votre compte OpenAI (openai/gpt-6.1-sol sur OpenRouter) et vous utilisez le nouveau modèle.
Essayez GPT-6.1 Sol sur la passerelle IA de TrueFoundry →
GPT-6.1 Sol remplace GPT-6 Sol au même prix catalogue, avec une mise en cache moins chère et les mêmes limites. Les chiffres importants pour un budget de production :
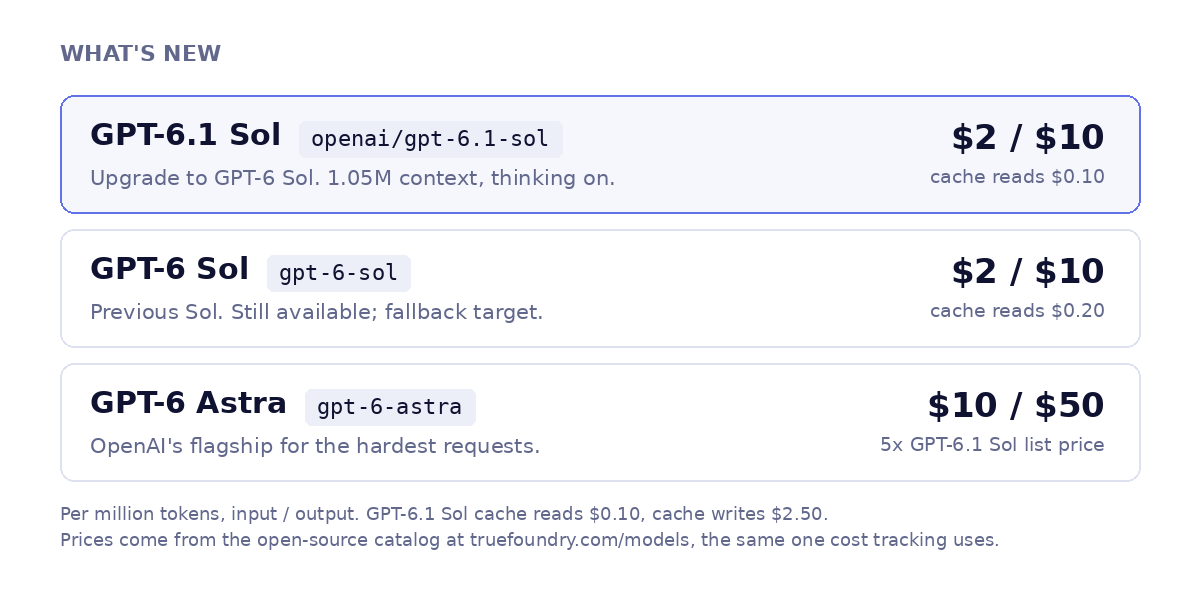
Le catalogue affiche GPT-6 Astra à 10 $ par million de jetons en entrée et 50 $ par million en sortie. GPT-6.1 Sol est listé à 2 $ et 10 $, soit exactement un cinquième sur les deux tableaux, et ses lectures de cache à 0,10 $ représentent un dixième du tarif d'Astra à 1 $.
Comparons les sorties du mois : GPT-6 Luna à 0,10 $ par million de jetons en entrée, GPT-6 Sol, GPT-6.1 Sol et Claude Sonnet 5.5 à 2 $, Claude Opus 5.5 à 4 $, GPT-6 Astra à 10 $. GPT-6.1 Sol occupe la place de GPT-6 Sol sur l'échelle au même prix, avec le taux de lecture de cache le plus bas de cette catégorie à 2 $.
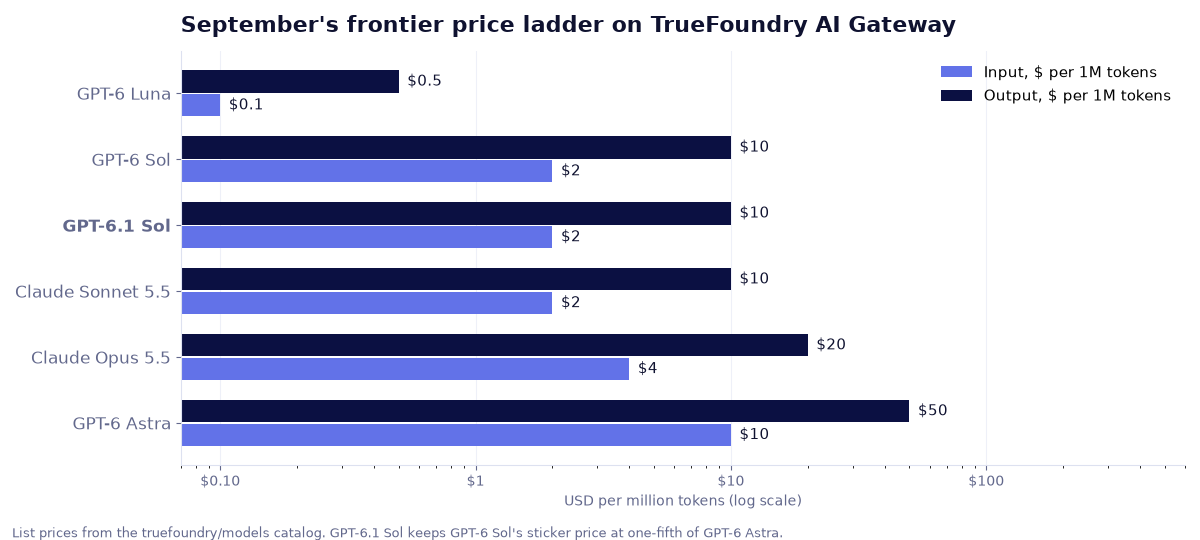
C'est tout l'intérêt de traiter le choix du modèle comme une configuration de passerelle plutôt que comme du code applicatif. La majeure partie du trafic de production se compose d'un grand nombre de requêtes simples et d'un petit nombre de requêtes complexes. Si la majorité des requêtes simples est traitée par Luna, les requêtes intermédiaires par GPT-6.1 Sol et seules les plus complexes par Astra, la facture globale ne ressemblera en rien à une facture basée uniquement sur Astra. Cela ne fonctionne que si le changement de modèle est une simple modification de configuration, ce à quoi sert la passerelle IA .
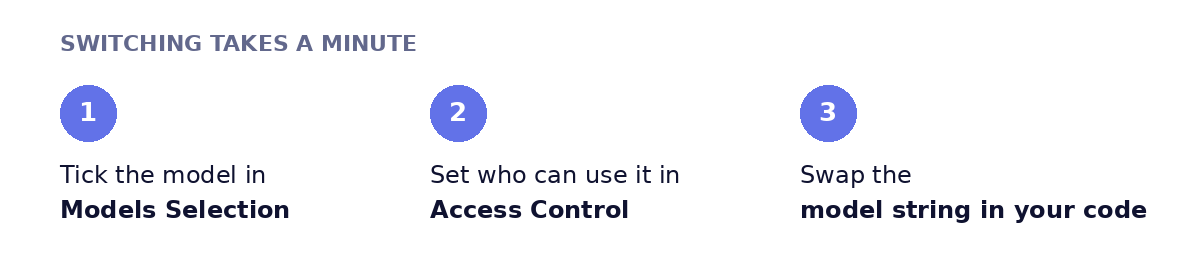
Étape 1 : Activez le modèle dans votre compte fournisseur. Dans la passerelle, ouvrez Modèles → votre compte OpenAI → Sélection des modèles, recherchez gpt-6.1-sol et cochez-la. La tarification s'affiche directement (2 $ en entrée / 10 $ en sortie par million de jetons) car elle provient directement du catalogue. Ensuite, configurez Contrôle d'accès afin que le modèle soit limité aux bonnes équipes et aux clés virtuelles dès le premier jour.
OpenAI direct et OpenRouter (openai/gpt-6.1-sol) sont tous deux disponibles dans le catalogue dès aujourd'hui ; les entrées Microsoft Foundry et AWS Bedrock arrivent bientôt.
Vous ne voyez pas le modèle dans votre liste ? + Ajouter un modèle en bas de la liste permet de l'ajouter manuellement.
Étape 2 : Appelez-le. Ouvrez le Playground, sélectionnez le modèle et copiez l'extrait généré dans le SDK de votre choix. La version Python pour OpenAI :
from openai import OpenAI

client = OpenAI(
    api_key="<your-truefoundry-api-key>",
    base_url="https://gateway.truefoundry.ai",  # or your self-hosted gateway URL
)

# Model IDs are <provider-account>/<model>. Swap the string, keep everything else.
r = client.chat.completions.create(
    model="openai-main/gpt-6.1-sol",
    messages=[{"role": "user", "content": "Summarise this incident in three bullets: ..."}],
    extra_headers={"X-TFY-METADATA": '{"team": "platform", "feature": "incident-summary"}'},
)
print(r.choices[0].message.content)
Les identifiants de modèle suivent la convention <votre-compte-fournisseur>/<modèle>, donc openai-main/gpt-6-sol et openai-main/gpt-6.1-sol peuvent être interchangés en une seule ligne. L'en-tête X-TFY-METADATA étiquette chaque appel afin que les dépenses apparaissent par équipe ou par fonctionnalité dans la vue des métriques.
Étape 3 (facultatif) : Placez-le derrière un modèle virtuel. Créez un modèle virtuel et sélectionnez Routage automatique. La passerelle classe chaque requête comme simple, moyenne ou complexe et l'envoie vers la cible que vous avez assignée à ce niveau. GPT-6 Luna pour les requêtes simples, GPT-6.1 Sol pour les moyennes, GPT-6 Astra pour les complexes, avec GPT-6 Sol en solution de secours pendant la stabilisation des limites de débit de la semaine de lancement, constitue une configuration de départ judicieuse. Selon nos benchmarks, ce type de routage a permis de réduire les coûts de 50 à 70 % pour un niveau de qualité d'environ 98 %. Votre application utilise un seul nom de modèle pour l'ensemble des appels.
GPT-6.1 Sol est le modèle à privilégier lorsqu'une requête nécessite plus de capacités que Luna, mais que le prix d'Astra est difficile à justifier, ou lorsque les agents renvoient un contexte long que le tarif de cache à 0,10 $ rend économique. L'utiliser via TrueFoundry signifie que la décision concernant le routage de ces requêtes se situe dans la configuration de la passerelle, où vous pouvez la modifier sans avoir à effectuer de déploiement.
Essayez GPT-6.1 Sol sur la passerelle IA de TrueFoundry →
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















