



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 9, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le moteur d'inférence détermine l'efficacité avec laquelle votre GPU traite les jetons. Un même modèle sur le même matériel peut offrir des performances très différentes en termes de débit, de latence et de coût, selon le moteur utilisé et la configuration de son traitement par lots et de sa mise en cache.
Il n'existe pas de solution universelle. vLLM, SGLang et TensorRT-LLM sont tous en développement actif et convergent vers de nombreuses techniques communes, notamment le traitement par lots continu (continuous batching), le cache KV paginé, la mise en cache des préfixes et la quantification. Le bon choix dépend de votre modèle, de votre GPU, de la longueur des séquences, de la taille des lots et de la concurrence.
vLLM repose sur PagedAttention, qui gère le cache des clés et valeurs (KV) d'attention dans des pages non contiguës, à la manière dont un système d'exploitation gère la mémoire virtuelle. Cela réduit la fragmentation de la mémoire et permet au serveur de traiter davantage de séquences simultanées sur un seul GPU.
C'est un choix robuste et polyvalent pour un service à haut débit, grâce au traitement par lots continu, à une large compatibilité avec les modèles et à un serveur facile à utiliser, compatible avec l'API OpenAI. Optez pour vLLM si vous recherchez une large prise en charge des modèles et un débit solide sans étape de compilation. Pour une analyse plus approfondie, consultez notre guide sur vLLM.
SGLang repose sur RadixAttention, qui réutilise le cache KV entre les requêtes partageant un préfixe grâce à un arbre de préfixes (radix tree). Cela profite aux charges de travail impliquant un partage important de prompts, comme le few-shot prompting, les longs prompts système partagés, les conversations multi-tours avec agents et le raisonnement par arbre de pensées (tree of thought).
Il permet également d'obtenir rapidement des sorties structurées fiables, notamment via JSON, regex et le décodage contraint par grammaire, ce qui facilite les pipelines de prompting complexes et l'appel d'outils. Privilégiez SGLang lorsque la réutilisation des préfixes et la génération contrainte dominent votre trafic.
TensorRT-LLM est la bibliothèque de NVIDIA qui compile les modèles en moteurs optimisés pour une cible GPU spécifique, en utilisant des noyaux fusionnés, une attention optimisée, la quantification sur le matériel compatible et le traitement par lots en cours d'exécution via Triton.
Il vise généralement la latence la plus faible et la meilleure efficacité par GPU sur les cartes NVIDIA, au prix d'une étape de compilation explicite et de moteurs liés au type et au nombre exacts de GPU pour lesquels ils ont été créés. Comme l'indique la documentation, étant donné que TRT-LLM optimise le modèle pour le type et le nombre de GPU cibles, il est important que ces paramètres correspondent lors du déploiement.
| Moteur | Concept clé | Idéal pour | Compromis |
| --- | --- | --- | --- |
| vLLM | Cache KV PagedAttention | Débit élevé général, large support de modèles | Excellent choix par défaut, pas toujours la latence la plus faible |
| SGLang | Réutilisation de préfixe RadixAttention | Prompts partagés, agentique, sorties structurées | Gains optimaux grâce à la réutilisation de préfixe |
| TensorRT-LLM | Moteurs NVIDIA compilés | Latence minimale sur GPU NVIDIA | Étape de build, moteur lié au GPU |
Les chiffres de performance dépendent de la charge de travail. Effectuez des benchmarks sur votre propre trafic avant tout engagement. TrueFoundry prend en charge ces trois solutions afin d'adapter le moteur à votre charge de travail.
Pour vLLM et SGLang, le catalogue de modèles est le point d'entrée. Comme l'indique la documentation, TrueFoundry simplifie le déploiement d'un LLM en déterminant automatiquement la méthode optimale et en configurant les GPU appropriés.
Vous pouvez choisir l'un des modèles du catalogue LLM ou coller une URL de modèle Hugging Face. TrueFoundry analyse les tags et les fichiers du modèle pour identifier le framework de déploiement et génère les manifestes associés. Vous conservez une flexibilité totale pour choisir le serveur de modèle le plus performant, garantissant ainsi une inférence plus rapide. La plateforme utilise également le streaming d'images et la mise en cache, permettant des temps de téléchargement 3 fois plus rapides pour les images vLLM et SGLang.
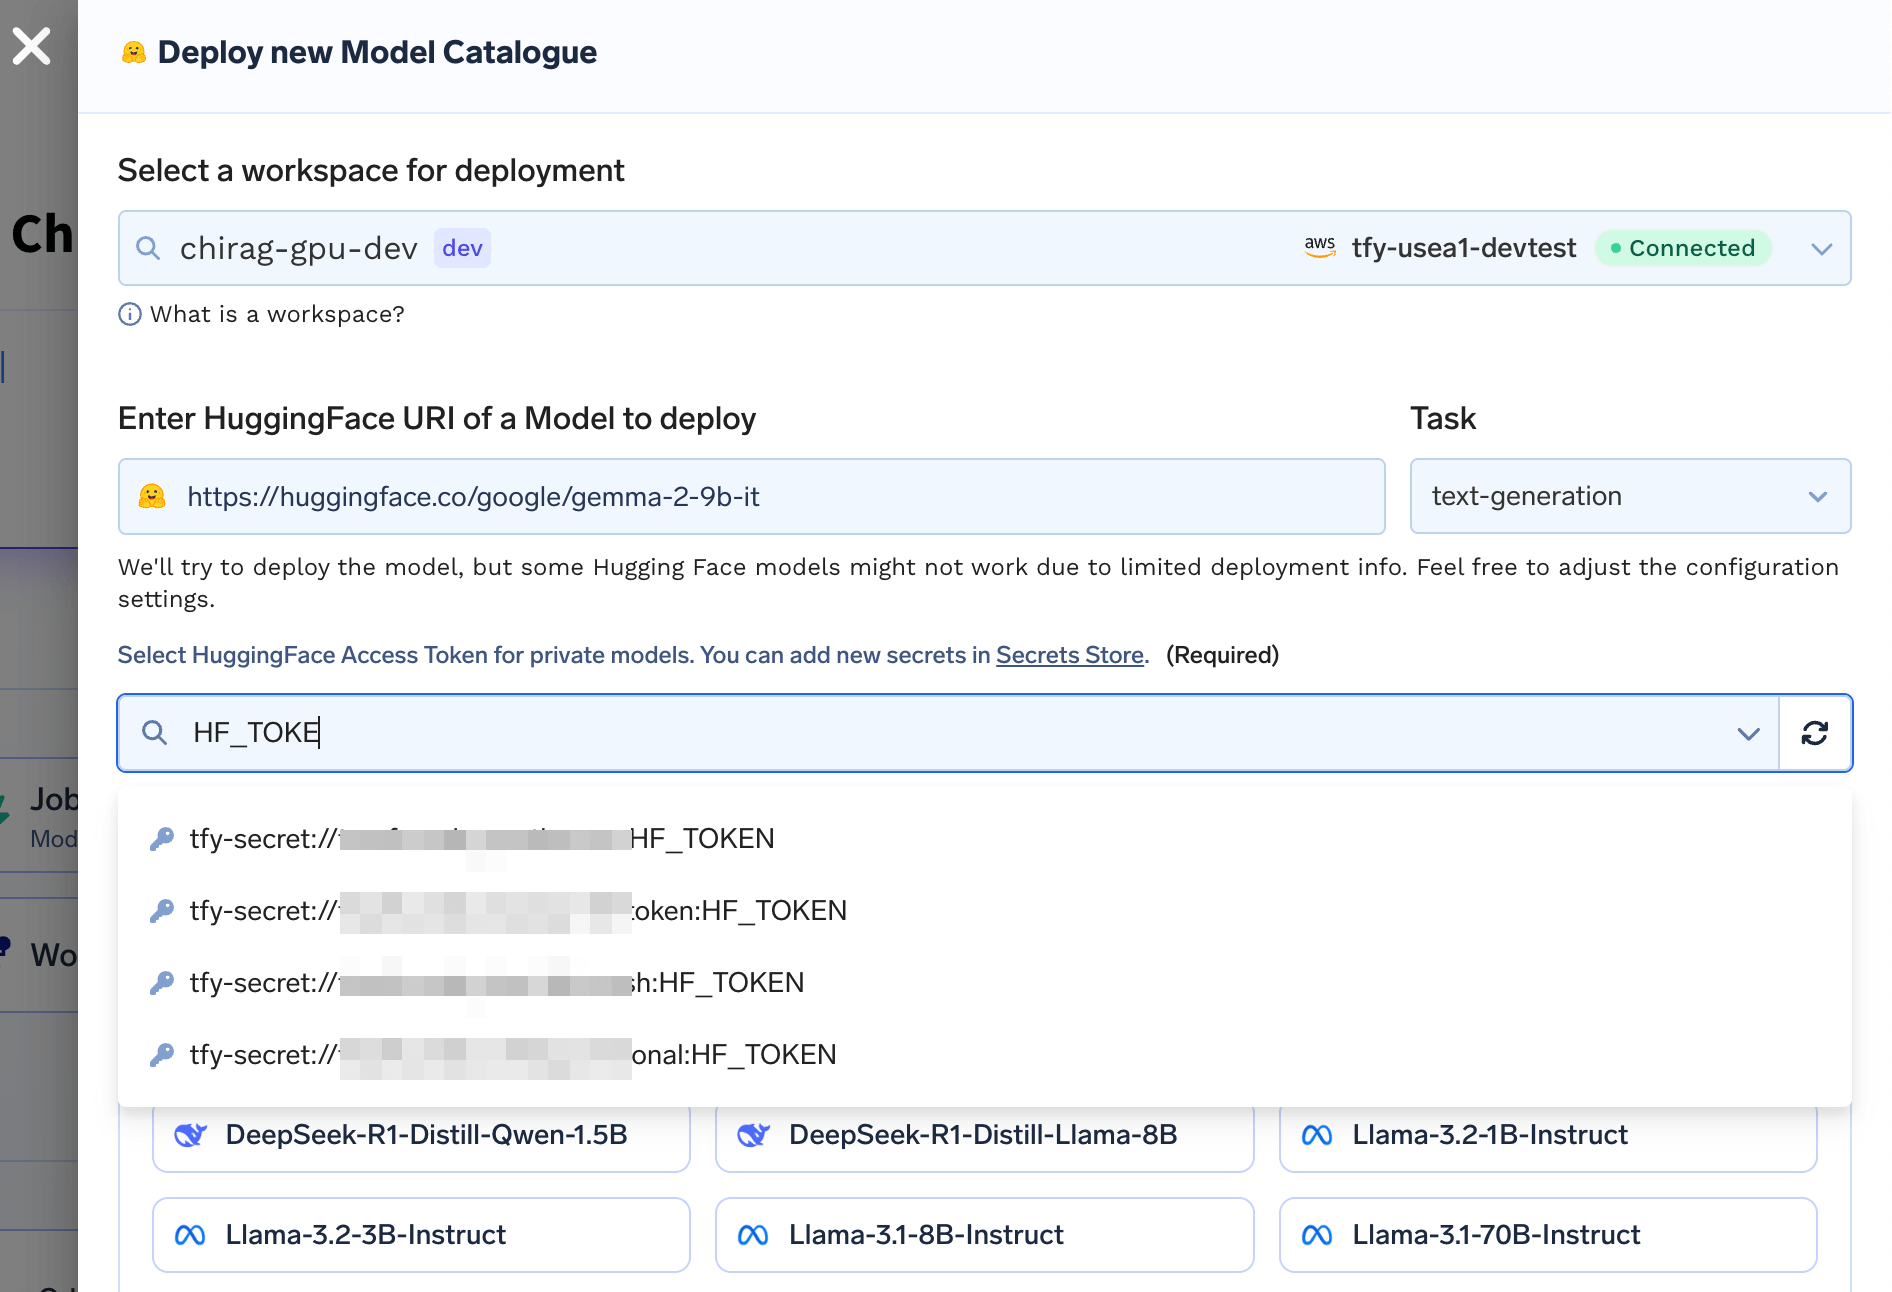
Pour les modèles restreints, ajoutez votre jeton Hugging Face en tant que secret dans le sélecteur de secrets.
TensorRT-LLM ne s'active pas en un clic, car les moteurs doivent être compilés pour le GPU cible. Le guide dédié utilise un flux de travail basé sur la compilation puis le déploiement.
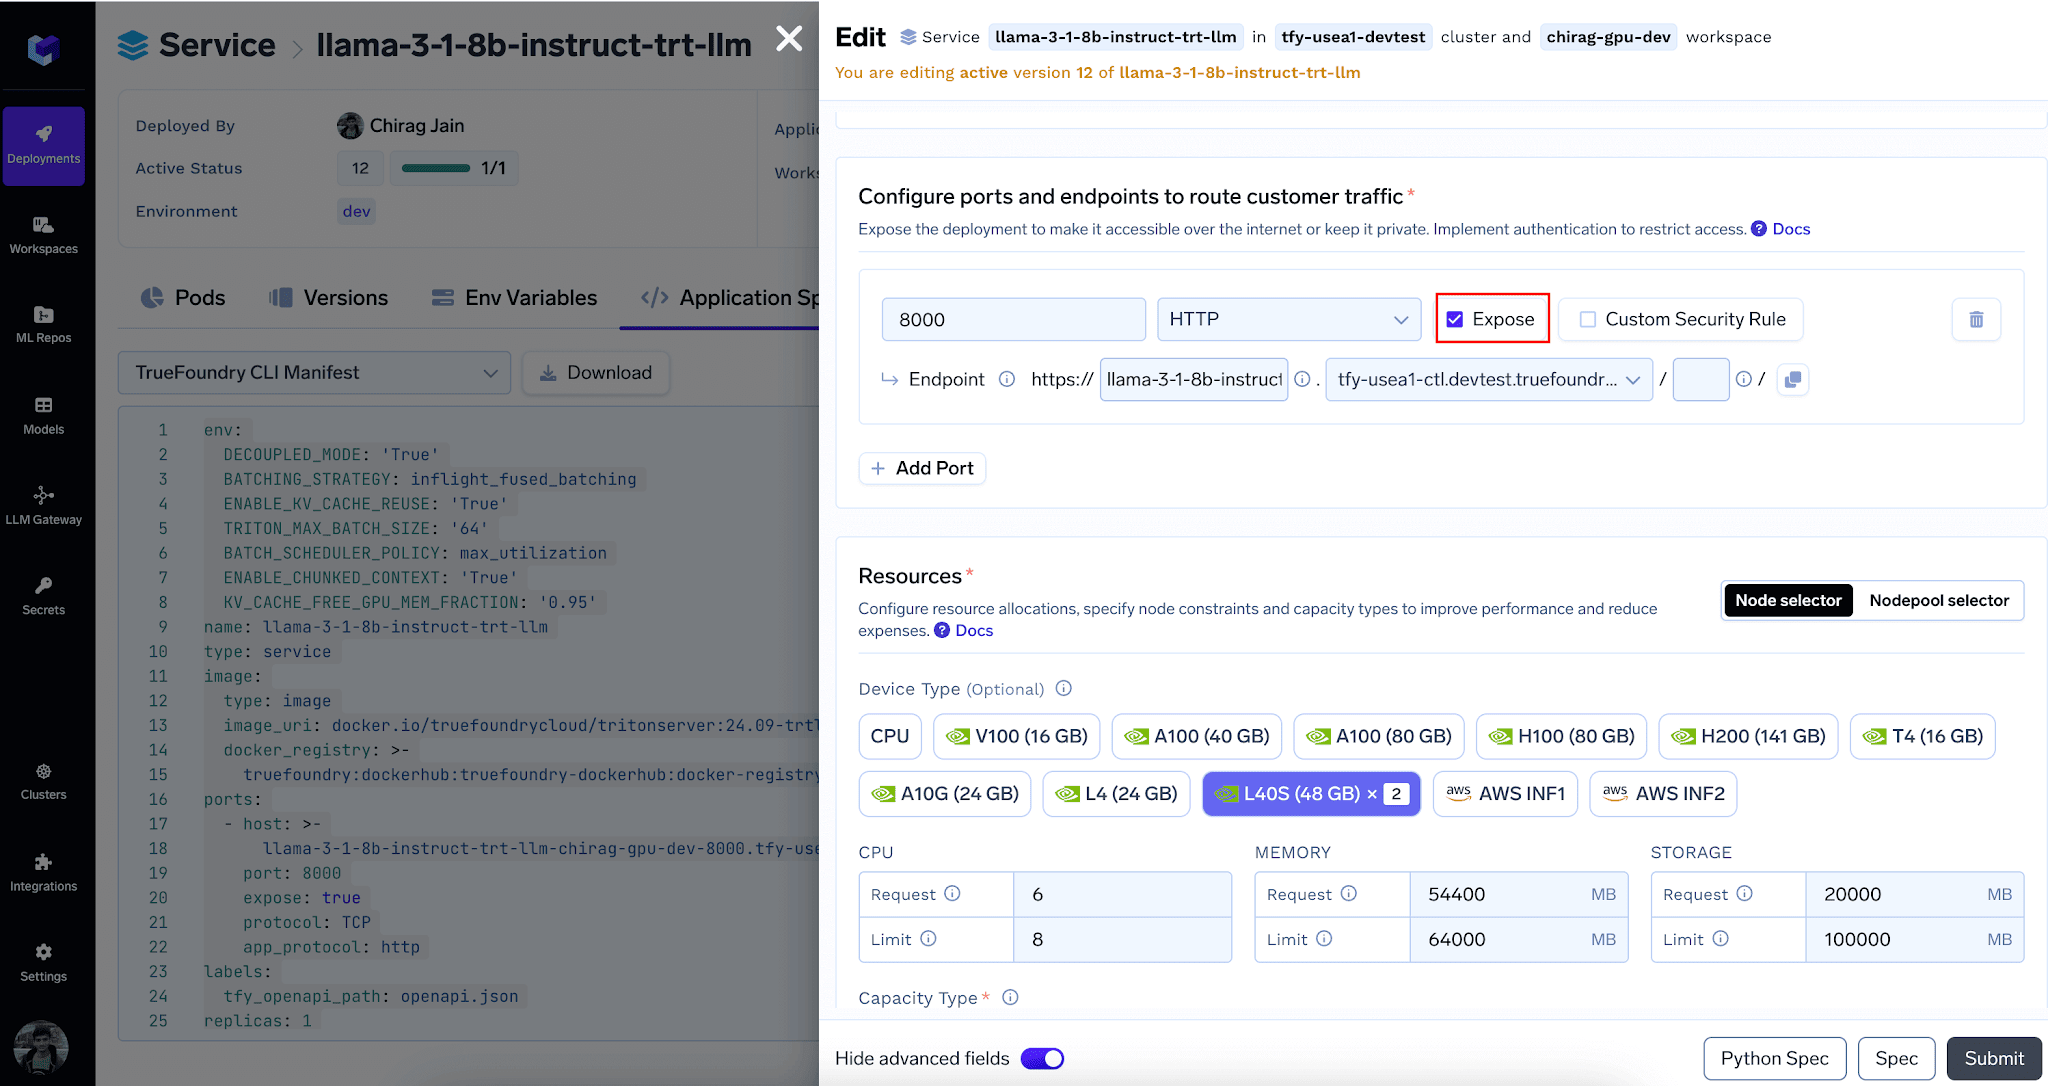
Exécution d'une inférence sur un moteur TensorRT-LLM déployé via le point de terminaison compatible OpenAI.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




It depends on the model, GPU, and workload. TensorRT-LLM often reaches lower latency on NVIDIA GPUs because it compiles a model specific engine, while vLLM offers excellent throughput and broader model coverage with no build step. Benchmark both on your own traffic.
Choose SGLang when your prompts share long prefixes, such as shared system prompts or agentic multi turn flows, or when you need fast, reliable structured outputs like JSON or grammar constrained decoding. Its RadixAttention is designed for prefix reuse.
Yes. TrueFoundry supports vLLM, SGLang, and TRT-LLM as model servers. vLLM and SGLang are selectable in the catalogue flow, and TensorRT-LLM has a dedicated build and serve guide. Any OpenAI compatible endpoint can be added to the AI Gateway.
Because TensorRT-LLM compiles the engine for a specific GPU type and count, the serving deployment must use the same GPU type and count as the builder job. This is what lets it reach its latency and efficiency targets.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















