



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le modèle est rarement l'aspect le plus complexe aujourd'hui. Les modèles de pointe sont suffisamment performants pour que, dans de nombreux cas d'utilisation, passer de l'un à l'autre soit aussi simple que de modifier un champ de configuration. Ce qui distingue un agent qui fonctionne lors d'une démonstration d'un agent fiable après trois mois de production, c'est tout ce qui entoure le modèle : la boucle, le contexte, les outils, le bac à sable, les validations et les garde-fous qui l'empêchent d'effectuer des actions irréversibles.
Cette couche constitue le harnais de l'agent, et les décisions que vous y prenez peuvent avoir un impact plus important sur la fiabilité et les coûts que le choix du modèle lui-même. C'est ce que nous avons appris en développant et en exploitant TrueForge, notre harnais d'agent open source. Voici les 10 bonnes pratiques pour les harnais d'agents que nous recommandons si vous développez des agents en production aujourd'hui.
Commençons par un chiffre, car il remet tout en perspective. Nous avons utilisé l'Enterprise-Bench de DevRev: 14 tâches intersystèmes de difficulté variable qui ressemblent à du travail opérationnel B2B réel. Pour répondre à chacune d'elles, un agent doit planifier, appeler des outils MCP sur trois systèmes (un CRM de type Salesforce, un outil de suivi de projet de type Jira et un espace de stockage de documents et de transcriptions d'appels de type Drive), combiner les résultats correctement et formuler la réponse avec le niveau de détail approprié.
La précision est pratiquement identique. Le modèle fixe le plafond ; le harnais ne rend pas le modèle sous-jacent plus intelligent.
Ce que le harnais détermine, c'est la quantité de travail nécessaire pour atteindre ce plafond.
Dans ce benchmark, TrueForge a résolu environ le même nombre de tâches que Claude Managed Agents tout en utilisant environ 62 % de jetons en moins et en coûtant environ 28 % de moins par exécution. Par rapport à deepagents, la différence de jetons était encore plus importante.
C'est l'aspect de l'infrastructure des agents qu'il est facile de négliger. Deux agents peuvent utiliser le même modèle, avoir accès aux mêmes outils et tenter de résoudre la même tâche, tout en générant des coûts d'exécution très différents.
La différence provient de ce qui se passe autour du modèle : la quantité de contexte qu'il transporte, les outils qu'il charge, la manière dont il gère les réponses volumineuses, le moment où il compresse l'état et l'efficacité avec laquelle il exécute la boucle.
Lire la méthodologie complète du benchmark →
La quasi-totalité de l'écart de coût dans ce benchmark est due aux quatre premières pratiques.

TrueForge est le harness d'agents open source et indépendant des fournisseurs de TrueFoundry, destiné aux équipes qui souhaitent un meilleur contrôle sur l'exécution de leurs agents en production. Au lieu de lier l'exécution à un seul fournisseur de modèles, TrueForge vous permet d'utiliser vos propres modèles, serveurs MCP et infrastructure, tout en gérant la boucle de l'agent, l'exécution des outils, la gestion du contexte, les approbations et le sandboxing.
Là où un agent auto-hébergé comme Hermes laisse une grande partie de l'infrastructure de production à la charge du développeur, TrueForge fournit le plan de contrôle nécessaire pour exploiter des agents à travers différentes équipes et environnements. Cela inclut l'accès centralisé aux MCP et aux identifiants, les approbations avec intervention humaine, l'exécution en sandbox, l'observabilité et la gouvernance.
Vous pouvez l'exécuter localement avec npx @truefoundry/trueforge ou le déployer pour une équipe avec Docker Compose ou Helm.
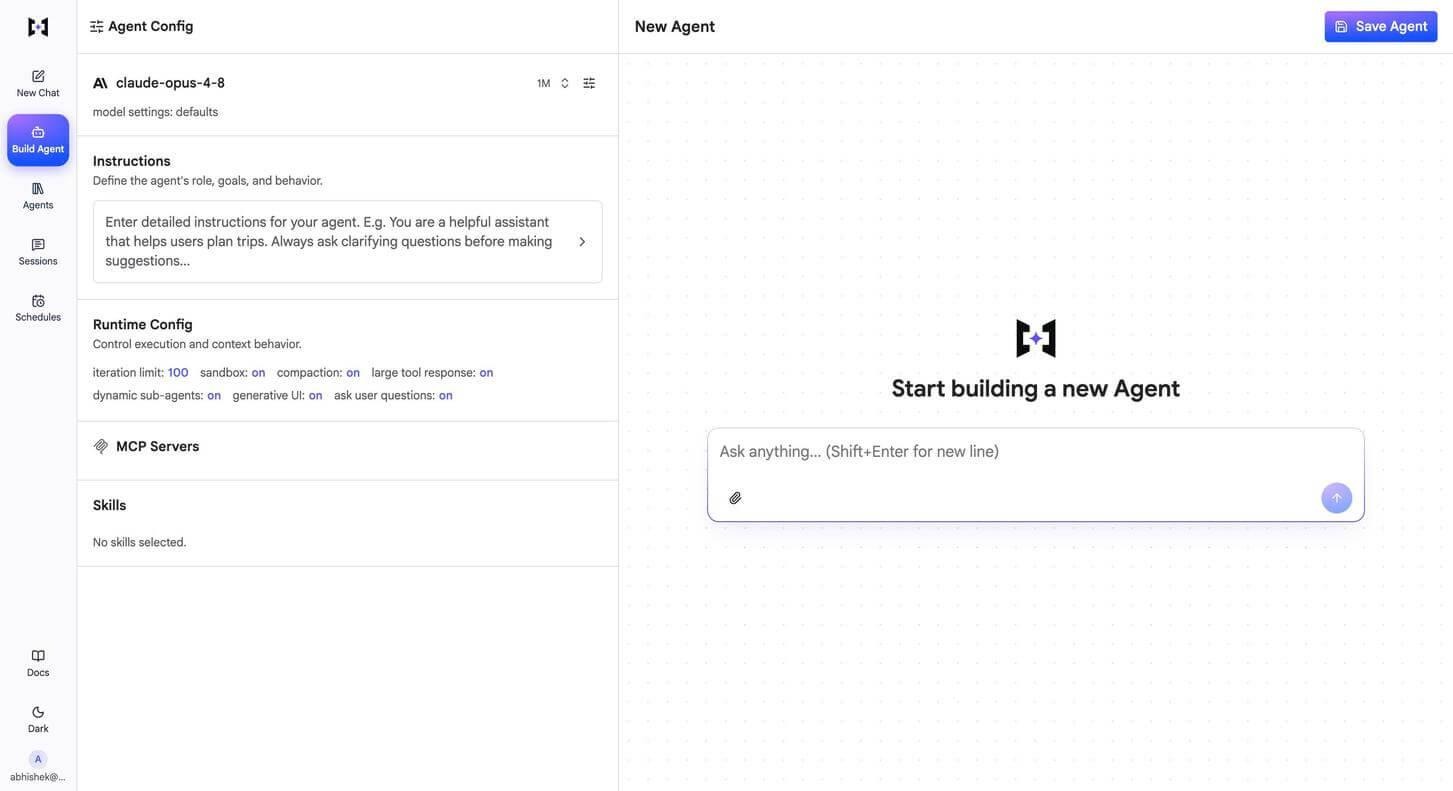
TrueForge sépare également l'exécution de l'agent de la couche modèle. Cela signifie que les équipes peuvent changer de modèle ou diriger les charges de travail vers différents fournisseurs sans avoir à reconstruire l'agent lui-même. Combiné à l'AI Gateway de TrueFoundry, les équipes peuvent également appliquer un routage de modèles et des contrôles de coûts pour éviter d'utiliser des modèles de pointe coûteux pour des tâches qui ne le nécessitent pas. Le résultat est un juste milieu entre une exécution entièrement gérée et la construction de toute l'infrastructure de l'agent par vous-même : un harness d'agents open source doté des contrôles opérationnels nécessaires pour exécuter des agents en production à grande échelle.
TrueFoundry fournit également un second levier pour réduire les coûts des modèles grâce à Passerelle IA de Routage automatique. Au lieu d'envoyer chaque requête à un modèle de pointe, le routage automatique classe les requêtes par complexité et les dirige vers différents niveaux de modèles. Dans le benchmark de TrueFoundry portant sur 550 prompts, le routage entre Haiku, Sonnet et Opus a permis de réduire les coûts de 69 % tout en conservant 98 % de la qualité de référence, et la latence moyenne est passée de 7,6 secondes à 4,0 secondes. Sur un trafic en conditions réelles, la réduction globale des coûts a atteint 80 %.
Ces deux couches traitent différents aspects de l'équation des coûts. TrueForge réduit la surcharge liée à l'exécution de l'agent lui-même, tandis que le routage de modèles vous permet d'éviter d'utiliser un modèle coûteux lorsque la tâche ne le nécessite pas. Pour les équipes qui déploient des agents à grande échelle, disposer de ces deux leviers peut s'avérer plus important que le prix du modèle seul.
TrueForge est open source et sous licence MIT, tandis que la passerelle IA de TrueFoundry ajoute la couche opérationnelle dont les équipes ont besoin lors du passage d'agents individuels à la production : accès centralisé aux modèles, budgets, garde-fous, gestion des identifiants et traces unifiées.
Si vous comparez les agents gérés de Claude avec une architecture plus configurable, TrueFoundry mérite d'être envisagé lorsque la flexibilité des modèles, le contrôle de l'infrastructure et l'optimisation des coûts des agents comptent autant que l'exécution de l'agent lui-même.
C'est là que se joue la rentabilité. L'ingénierie du contexte est la discipline consistant à décider ce que le modèle voit à chaque étape, et pour un agent fonctionnant sur le long terme, cela se cumule tour après tour.
Ce qui pose problème : Vous connectez cinq serveurs MCP, chaque schéma d'outil se charge au démarrage, et l'agent consomme des dizaines de milliers de jetons pour des définitions d'outils qu'il n'appellera jamais. Chaque tour suivant les transporte.
Que faire : Chargez les schémas d'outils à la demande plutôt qu'au démarrage. Une bonne gestion du contexte de l'agent commence avant le premier appel au modèle, pas une fois que la fenêtre est saturée.
Dans TrueForge : le chargement différé des outils fournit à l'agent un index léger et ne récupère le schéma complet que lorsqu'il sollicite cet outil.
Ce qui pose problème : la fenêtre se remplit, le système supprime le contenu le plus ancien, et l'agent oublie discrètement la contrainte que vous lui aviez donnée au troisième tour. Il ne génère pas d'erreur. Il devient simplement moins performant, et l'échec est difficile à détecter car le résultat semble toujours plausible.
Que faire : Résumez l'historique ancien dans un enregistrement structuré et conservez ce résumé. Définissez le seuil en dessous de la limite maximale pour que la compression se fasse selon vos conditions plutôt que sous la contrainte.
Dans TrueForge : la compression se déclenche à 80 % de la longueur de contexte du modèle et remplace l'historique ancien par un résumé structuré. La troncature convient à un agent de support rapide, mais elle est préjudiciable pour une tâche de longue haleine.
Une mise en garde importante : la compression comporte ses propres risques si les politiques et les contraintes ne résident que dans la conversation. Nous avons écrit sur la façon dont la compression érode la gouvernance et pourquoi l'application des règles doit se faire en dehors de la fenêtre de contexte.
Ce qui pose problème : un outil renvoie une charge utile JSON de 200 Ko, le tout atterrit dans la fenêtre de contexte, alors que l'agent n'avait besoin que de trois champs.
Que faire : écrivez la charge utile dans un emplacement accessible par l'agent et fournissez-lui une référence plutôt que le contenu lui-même.
Dans TrueForge : déchargement des réponses volumineuses des outils écrit la réponse dans un fichier sandbox et la remplace par un chemin d'accès et un aperçu. Le mode Code va plus loin en permettant à l'agent d'enchaîner plusieurs appels d'outils au sein d'un même script sandbox, de sorte que seul le résultat imprimé soit intégré au contexte. Cinq allers-retours se transforment en un seul résumé.
Ce qui pose problème : un sous-agent hérite de l'intégralité du fil de discussion parent, effectue son travail et renvoie tout son historique de raisonnement dans le contexte parent. Vous payez alors deux fois pour le même historique et polluez le fil de discussion principal.
Que faire : la délégation doit réduire le contexte du parent, et non l'alourdir.
Dans TrueForge : les sous-agents s'exécutent avec leur propre contexte épuré et ne renvoient que le résultat.
Essayez : npx @truefoundry/trueforge exécute un environnement de test intégrant ces quatre points par défaut, localement, en une minute environ. Mettez une étoile sur GitHub.
Le problème : le système encapsule chaque session dans un conteneur, que l'agent exécute du code ou non. Vous payez pour du temps de conteneur pour des conversations qui n'étaient que textuelles, et un serveur peut gérer beaucoup moins d'agents simultanés.
La solution : provisionnez le bac à sable uniquement lorsque l'agent a réellement besoin d'exécuter quelque chose. Le sandboxing d'agent sert à limiter le rayon d'action, et vous obtenez la même isolation sans avoir à payer pour cela à chaque étape.
Dans TrueForge : le bac à sable est un outil, démarré uniquement lorsque l'agent doit exécuter du code. Ainsi, un seul serveur gère de nombreux agents et les échanges qui ne nécessitent pas de code restent peu coûteux. Les fournisseurs de bacs à sable sont au choix.
L'argument plus approfondi sur le fait de laisser les modèles exécuter sans les laisser vagabonder mérite d'être lu si vous concevez cela à partir de zéro.
Le problème : les équipes tombent souvent dans l'un des deux extrêmes. Soit rien n'est contrôlé et un agent finit par supprimer quelque chose, soit tout est contrôlé et un humain clique sur « approuver » quarante fois par heure jusqu'à ce qu'il ne lise même plus ce qu'il valide.
La solution : basez le contrôle sur l'irréversibilité. Envoyer un e-mail, écrire en production, dépenser de l'argent, supprimer quoi que ce soit. Les lectures et les brouillons doivent rester libres. Et ne tentez pas d'appliquer une exigence de conformité en la décrivant simplement dans le prompt système, car un prompt n'est qu'une suggestion, alors que des garde-fous inspectant chaque appel d'outil constituent un véritable contrôle.
Dans TrueForge : le serveur central suspend l'exécution et attend une approbation pour les actions sensibles avant que l'appel ne soit émis, plutôt qu'après.
L'emplacement de ce point de contrôle est tout aussi important que son existence, un sujet que nous avons abordé dans la conception des approbations d'outils MCP à la limite de la passerelle.
Ce qui pose problème : un ordinateur portable se met en veille, un équilibreur de charge réinitialise une connexion, et quarante minutes de travail de l'agent sont perdues. Pour des tâches qui durent une heure, ce n'est plus un cas marginal.
Ce qu'il faut faire : persistez l'état de la session afin qu'une connexion interrompue reprenne là où elle en était plutôt que de redémarrer.
Dans TrueForge : les sessions persistent malgré les reconnexions et les redémarrages. La capacité de reprise est l'une de ces propriétés que personne ne demande lors de la revue de conception, mais dont tout le monde a besoin dès la deuxième semaine.
Ce qui pose problème : vous disposez du nombre de jetons et de la latence par appel de modèle, mais vous n'avez aucune idée de l'étape qui a échoué dans une exécution de 60 étapes. Le débogage devient un travail d'archéologue.
Ce qu'il faut faire : émettez des événements structurés pour chaque étape, afin qu'une exécution se lise comme une chronologie plutôt que comme un mur de journaux. Assurez-vous que la boucle elle-même est observable avant d'avoir à la déboguer dans l'urgence.
Dans TrueForge : chaque étape est diffusée en temps réel, et le contrat d'exécution des événements de l'agent est publié afin que vos propres outils puissent l'exploiter.
L'approche de la conception de boucles est utile ici : la boucle est le middleware, traitez-la donc comme une infrastructure.
Ce qui pose problème : l'agent est développé en fonction du SDK et des spécificités d'un fournisseur unique. Lorsqu'un modèle moins coûteux ou plus performant sort, le changer implique une réécriture, alors vous ne changez pas.
Ce qu'il faut faire : communiquez avec les modèles via des interfaces compatibles OpenAI et gardez les spécificités des fournisseurs hors de la logique de votre agent.
Dans TrueForge : les modèles, les serveurs MCP et les fournisseurs de bacs à sable sont tous intégrables via des interfaces ouvertes. Ce n'est pas une valeur théorique. Lors du même test de référence, l'exécution de TrueForge sur GLM-5.2 au lieu d'Opus 4.8 a permis de résoudre les mêmes ~11 tâches sur 14 pour 2,90 $ par exécution contre 8,50 $. Cette économie n'est possible que si le changement de modèle se résume à une modification de configuration.
Ce qui pose problème : chaque équipe détient ses propres clés de modèle et identifiants MCP. Personne ne peut plafonner les dépenses, le masquage des données personnelles (PII) est incohérent, et répondre à un audit nécessite de compiler des journaux provenant de neuf services différents.
Ce qu'il faut faire : placez une passerelle entre vos agents et tout ce qu'ils appellent.
Dans TrueForge : ce n'est délibérément pas le rôle du harnais. En auto-hébergé, vous utilisez vos propres clés et les gérez vous-même, ce qui fonctionne jusqu'à ce que vous exploitiez un grand nombre d'agents. À ce stade, pointez-le vers AI Gateway de TrueFoundry, qui regroupe plus de 1 000 LLM derrière une API compatible OpenAI, avec une latence ajoutée d'environ 3 à 4 ms et plus de 350 requêtes par seconde sur un seul vCPU, incluant RBAC, gestion budgétaire, garde-fous, rotation des identifiants et traces OpenTelemetry vers Grafana, Datadog ou Prometheus.
Vous gérez plus de quelques agents ? Découvrez comment l'AI Gateway les centralise, ou réservez une démonstration si vous souhaitez une présentation adaptée à votre configuration.
Neuf sur dix sont intégrés au framework. Le dixième ne l'est volontairement pas, car un framework qui cherche également à servir de plan de contrôle finit souvent par être médiocre dans les deux domaines.
Réinventer une boucle qui existe déjà. Si vous développez une logique de planification-action-observation à partir de zéro, vérifiez d'abord si un framework ne propose pas déjà cette fonctionnalité. La conception d'un framework d'agents ne vaut la peine que si votre problème est réellement atypique.
Tenter de contrôler par le prompt. Les étapes de conformité, les plafonds de dépenses et les processus d'approbation doivent être gérés par le code ou via une passerelle. Un modèle qui peut être convaincu par la politesse peut tout aussi bien être détourné.
Tout isoler dans des bacs à sable. L'isolation à chaque étape coûte cher et n'apporte rien lorsque le code n'est pas exécuté.
Mesurer le modèle plutôt que l'exécution. Le nombre de jetons par appel semble correct, alors que le coût total par tâche terminée triple discrètement. Mesurez l'exécution.
Q : Quelles sont les meilleures pratiques pour un environnement d'exécution d'agents ?
R : Les plus importantes concernent la gestion du contexte : chargez les schémas d'outils à la demande, compactez l'historique plutôt que de le tronquer, déportez les réponses volumineuses des outils vers des fichiers et séparez le contexte du sous-agent de celui du parent. Ensuite, ne provisionnez des bacs à sable que lors de l'exécution du code, sécurisez les actions irréversibles, maintenez les sessions actives lors des reconnexions et émettez des événements structurés à chaque étape. Dans nos tests, ces décisions ont permis de réduire par quatre le nombre de jetons par exécution pour des tâches identiques.
Q : Comment éviter qu'un agent ne manque de contexte lors d'une tâche longue ?
R : Privilégiez le compactage à la troncature. Résumez l'historique ancien dans un enregistrement structuré dès qu'un seuil est atteint, environ 80 % de la longueur de contexte du modèle, afin que l'agent conserve le fil de la discussion au lieu de le perdre silencieusement. Associez cela à un chargement différé des outils et au déport des réponses pour que la fenêtre de contexte se remplisse moins rapidement.
Q : Faut-il isoler chaque session d'agent dans un bac à sable ?
R : Non. Isolez l'exécution du code, pas la session. Maintenir un conteneur ouvert pour toute une conversation coûte cher à chaque tour qui n'exécute pas de code, et cela limite le nombre d'agents qu'un serveur peut gérer. Le provisionnement à la demande offre la même isolation pour une fraction du coût.
Q : Puis-je exécuter un environnement d'exécution d'agents dans mon propre VPC ou sur site ?
R : Oui, avec n'importe quelle option auto-hébergée. TrueForge s'exécute localement via une simple commande npx , ou via Docker Compose et Helm pour un déploiement en équipe avec Postgres, Redis, des réplicas et une authentification OIDC. La plateforme gérée de TrueFoundry peut également être déployée sur site, en environnement isolé (air-gapped) ou hybride, garantissant qu'aucune donnée ne quitte votre domaine.
Q : TrueFoundry prend-il en charge MCP et les agents issus d'autres frameworks ?
R : Oui. La plateforme inclut une passerelle MCP, une passerelle d'agents et un registre avec contrôle d'accès au niveau des outils. Les agents créés avec LangGraph, CrewAI, AutoGen ou un framework personnalisé peuvent être gouvernés via la même couche, ce qui vous évite de devoir adopter une pile technologique unique.
Les bonnes pratiques pour les harnais d'agents se résument à une habitude : décider délibérément de ce que le modèle voit et de ce qu'il est autorisé à faire, puis mesurer l'exécution globale plutôt que chaque appel individuel. Les équipes qui adoptent cette approche obtiennent des agents quatre fois moins coûteux et dont les échecs sont facilement identifiables.
Ne nous croyez pas sur parole pour les chiffres. TrueForge est sous licence MIT et la méthodologie de benchmark est publiée, vous pouvez donc l'exécuter sur vos propres tâches.
npx @truefoundry/trueforge pour l'essayer en une minute environ, consultez la documentation, ou réservez une démonstration si vous préférez voir comment cela s'applique à votre stack.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















