



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Il s'agit dans les deux cas de plateformes GPU serverless, qui passent par défaut à zéro et gèrent le trafic de production pour des entreprises renommées. C'est une concurrence loyale, mais leurs approches diffèrent. Baseten a conçu une plateforme dédiée au déploiement de modèles qu'elle a ensuite étendue. Modal a construit une plateforme de calcul généraliste où l'inférence n'est qu'un produit parmi six. Cela se reflète dans le SDK, dans les éléments pris en compte par la grille tarifaire et dans la possibilité d'exécuter les services sur votre propre compte.
L'élément le plus utile ci-dessous concerne la méthodologie de tarification, car les tarifs horaires GPU publiés sont incomparables entre ces deux solutions, et l'écart est suffisamment important pour influencer une décision. Chiffres vérifiés le 25 septembre 2026.
Baseten propose l'inférence en production pour les modèles open source, personnalisés et affinés, via des déploiements dédiés, des API de modèles au jeton et l'entraînement (tarification).
Fondée en 2019 par Tuhin Srivastava (PDG), Amir Haghighat (CTO), Phil Howes et Pankaj Gupta. Le financement a suivi les séries B, C, D et une série E de 300 millions de dollars pour une valorisation de 5 milliards, jusqu'à une série F de 1,5 milliard de dollars pour une valorisation de 13 milliards de dollars le 22 juin 2026 (annonce) ; le total levé dépasse les 2 milliards de dollars. Le chiffre d'affaires aurait été multiplié par 20 d'une année sur l'autre ; le revenu annuel récurrent (ARR) n'est pas public [À VÉRIFIER]. Parmi les clients, on compte Cursor, Notion, Harvey, HubSpot, OpenEvidence et Vercel.
Concernant un chiffre que vous avez peut-être vu : les rapports de presse de fin septembre 2026 (Axios le 22 sept., Bloomberg le 23 sept.) décrivent discussions autour d'un tour de table bien plus important, avoisinant les 26 milliards de dollars. Baseten n'a rien publié à ce sujet. 13 milliards de dollars est le dernier chiffre confirmé et celui que nous utilisons.
[CAPTURE D'ÉCRAN : Baseten — le tableau de bord Dedicated Deployments affichant les états des réplicas, la configuration de l'autoscaling et les percentiles de latence pour un modèle en production]
Baseten a également acquis Blaxel, une entreprise spécialisée dans les bacs à sable pour agents et l'infrastructure microVM, annoncé le 10 septembre 2026, conditions non divulguées (annonce) — une incursion directe sur le terrain des Sandboxes de Modal, vieux de deux semaines et sans rien de concret à évaluer pour le moment.
Vraiment meilleur pour : les acheteurs soumis à des réglementations ayant besoin d'une inférence dans leur propre VPC, là où Modal n'a aucun équivalent ; toute personne traitant des données de santé (PHI), puisque la conformité HIPAA est incluse dans l'offre gratuite ; les équipes souhaitant une optimisation de type TensorRT-LLM sans avoir à la développer ; et les charges de travail limitées à une région ou nécessitant de petits GPU.
Modal se définit comme « un cloud conçu pour l'IA. Pas un cloud GPU à usage unique, mais une plateforme dotée des primitives adaptées » (article sur la série C). Produits : Inférence, Sandboxes, Entraînement, Notebooks, Batch, Plateforme principale. Cette liste constitue l'argument : l'inférence n'est qu'un élément parmi d'autres.
Fondée en 2021 par Erik Bernhardsson et Akshat Bubna ; l'année de création provient de TechCrunch, et non d'une page Modal [À VÉRIFIER]. L'équipe a développé son propre système de fichiers, son runtime de conteneur, son ordonnanceur et son générateur d'images, ce qui se reflète dans les temps de démarrage à froid. Le financement a suivi les étapes d'amorçage, de série A et une série B de 87 M$ pour une valorisation de 1,1 Md$, jusqu'à une série C de 355 M$ pour une valorisation de 4,65 Md$ après financement le 21 mai 2026; soit un total de « plus de 466 M$ ». Modal publie ce que Baseten ne communique pas : « dépassant les 300 millions de dollars de revenus annualisés », et ce « Les Sandboxes génèrent déjà plus d'un tiers de nos revenus ». Parmi ses clients figurent Cognition, DoorDash, Suno et Ramp.
[CAPTURE D'ÉCRAN : Modal — le tableau de bord de l'application affichant le nombre de conteneurs, l'utilisation des GPU et le temps de démarrage à froid pour une fonction déployée]
[CAPTURE D'ÉCRAN : Modal — la page de tarification montrant le tableau des GPU aux côtés des postes distincts pour le CPU et la mémoire]
Vraiment meilleur pour : tout ce qui n'est pas un serveur de modèle — environnements isolés (sandboxes), code non approuvé, environnements RL, traitement par lots, notebooks. Ergonomie Python. Charges de travail avec GPU puissants, non épinglées et irrégulières. Large éventail de GPU, car les L40S, A100 40 Go et B300 n'ont pas d'équivalent chez Baseten. Et les démarrages à froid intensifs en initialisation, dominés par le JIT et les importations plutôt que par le chargement des poids.
La vérité sur les démarrages à froid : ils résolvent deux aspects différents du même problème. Baseten s'attaque à la livraison des poids et exclut le transfert de la facturation. Modal s'attaque à l'état du processus avec la restauration d'instantanés, ce qui n'aide explicitement pas au chargement des poids. Si votre démarrage à froid implique 140 Go de poids, l'approche de Baseten est la plus pertinente ; s'il s'agit d'importations, de JIT et de capture de graphes CUDA, celle de Modal est préférable.
Méthodologie. Baseten publie des tarifs à la minute pour des instances tout compris — le GPU est fourni avec un nombre fixe de vCPU et de RAM. Modal publie des tarifs à la seconde pour le GPU uniquement, le CPU et la mémoire étant facturés séparément. Pour comparer ce qui est comparable, convertissez les deux en tarifs horaires (Baseten x60, Modal x3600), puis ajoutez au tarif GPU de Modal le coût du CPU et de la mémoire inclus dans les offres Baseten, aux tarifs de Modal : 0,04716 $ par heure et par cœur physique (un cœur = deux vCPU) et 0,007992 $ par heure et par Gio. Le pinning et les multiplicateurs pour les instances non préemptibles sont exclus ; les ajouter rendrait Modal encore plus onéreux. Sources : baseten.co/pricing, docs.baseten.co/deployment/resources, modal.com/pricing.
Les modèles L40S et A100 40 Go ne disposent pas d'équivalent SKU chez Baseten pour effectuer un ajustement.
Ce qu'il faut retenir : « Modal est 40 % moins cher sur H100 » tombe à environ 19 % une fois que vous achetez un CPU et une mémoire comparables, se situe à quasi parité sur A100 80 Go, et s'inverse sur les petits GPU, où Baseten est 9 à 22 % moins cher. Ajoutez le pinning ou le multiplicateur 3x pour les instances non préemptibles, et Baseten l'emporte haut la main sur toute charge de travail garantie.
Un piège pour les benchmarks : le gpu="A100" de base de Modal peut être mis à niveau silencieusement vers 80 Go, et gpu="H100" peut atterrir sur un H200. Fixez-le avec gpu="H100!".
1. La grille tarifaire n'est pas la facture. Les équipes définissent un budget à partir d'un coût horaire par GPU, puis doivent gérer le CPU, la mémoire, les volumes, les multiplicateurs de région et un tarif sandbox 3x. Le regroupement de Baseten est plus facile à prévoir ; la tarification détaillée de Modal est plus fidèle à la consommation réelle. Aucune des deux n'est comparable sans le calcul ci-dessus.
2. Le choix de la région n'est pas la résidence des données. Modal fixera un conteneur sur eu-west tout en stockant vos logs, votre stockage durable et toute charge utile supérieure à 2 Mio aux États-Unis. Si un régulateur pose la question, la région du conteneur n'est pas la réponse.
3. Le serveur de modèle n'est qu'une partie du système. Vous avez également besoin d'API de modèles commerciaux, d'authentification, d'attribution des coûts, de limites de débit, de garde-fous et d'une piste d'audit. Aucune des deux plateformes ne couvre cette couche, et adopter l'une ou l'autre vous laisse cette responsabilité.
Une réponse directe plutôt qu'une course à trois fabriquée. Baseten et Modal sont des clouds d'inférence hébergés. TrueFoundry s'exécute dans votre propre compte cloud. Acheteur différent, problème différent.
Ils répondent à « comment servir ce modèle sans gérer de GPU ». TrueFoundry répond à « nous avons déjà de la capacité GPU, des engagements de dépenses ou un régulateur, et nous avons besoin d'une plateforme sur notre propre infrastructure ». Si la première question est la vôtre, achetez l'un d'eux — le mode auto-hébergé de Baseten est ce qui s'en rapproche le plus.
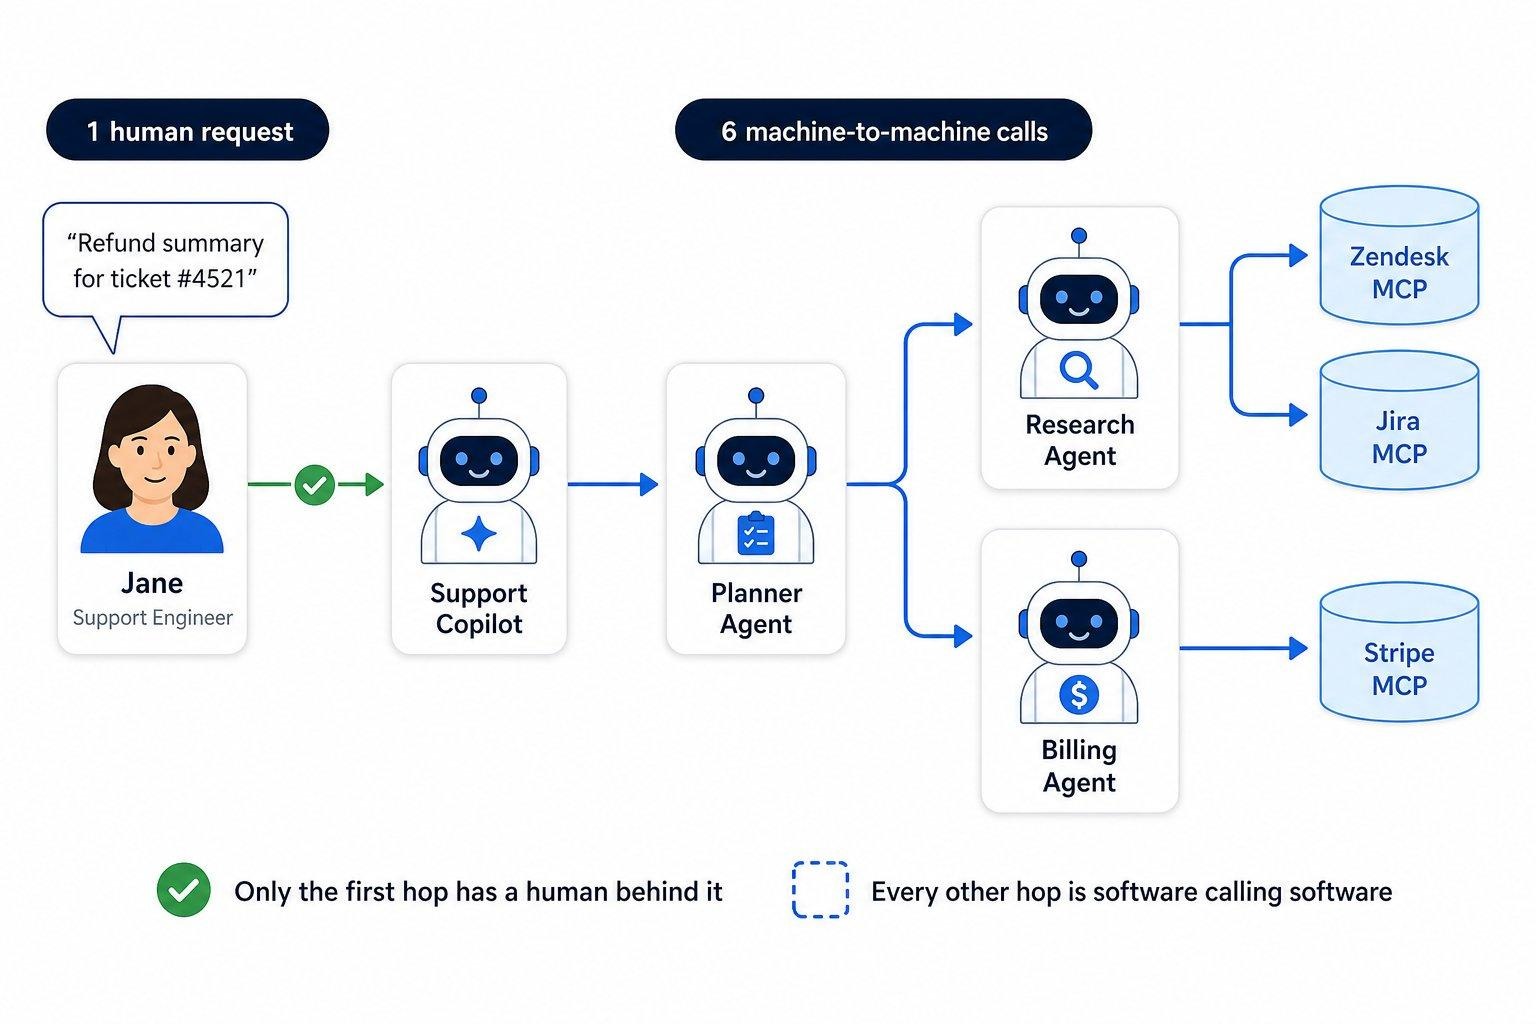
TrueFoundry se déploie en mode SaaS dans plus de 12 régions sur trois clouds, ou en auto-hébergement dans votre VPC via Helm et OpenTofu/Terraform, ou encore sur site, y compris en environnement isolé (air-gapped). En auto-hébergement, tout le trafic LLM reste au sein de votre infrastructure et TrueFoundry n'est pas sur le chemin critique. Le service couvre vLLM, SGLang, Triton, TorchServe, MLflow et LitServe, et inclut un registre de modèles, l'autoscaling sur CPU, RPS ou cron, ainsi que le partitionnement de GPU via time-slicing et MIG — ce qui est essentiel lorsque vous possédez le matériel et qu'allouer un H100 complet à un petit modèle serait un gaspillage.
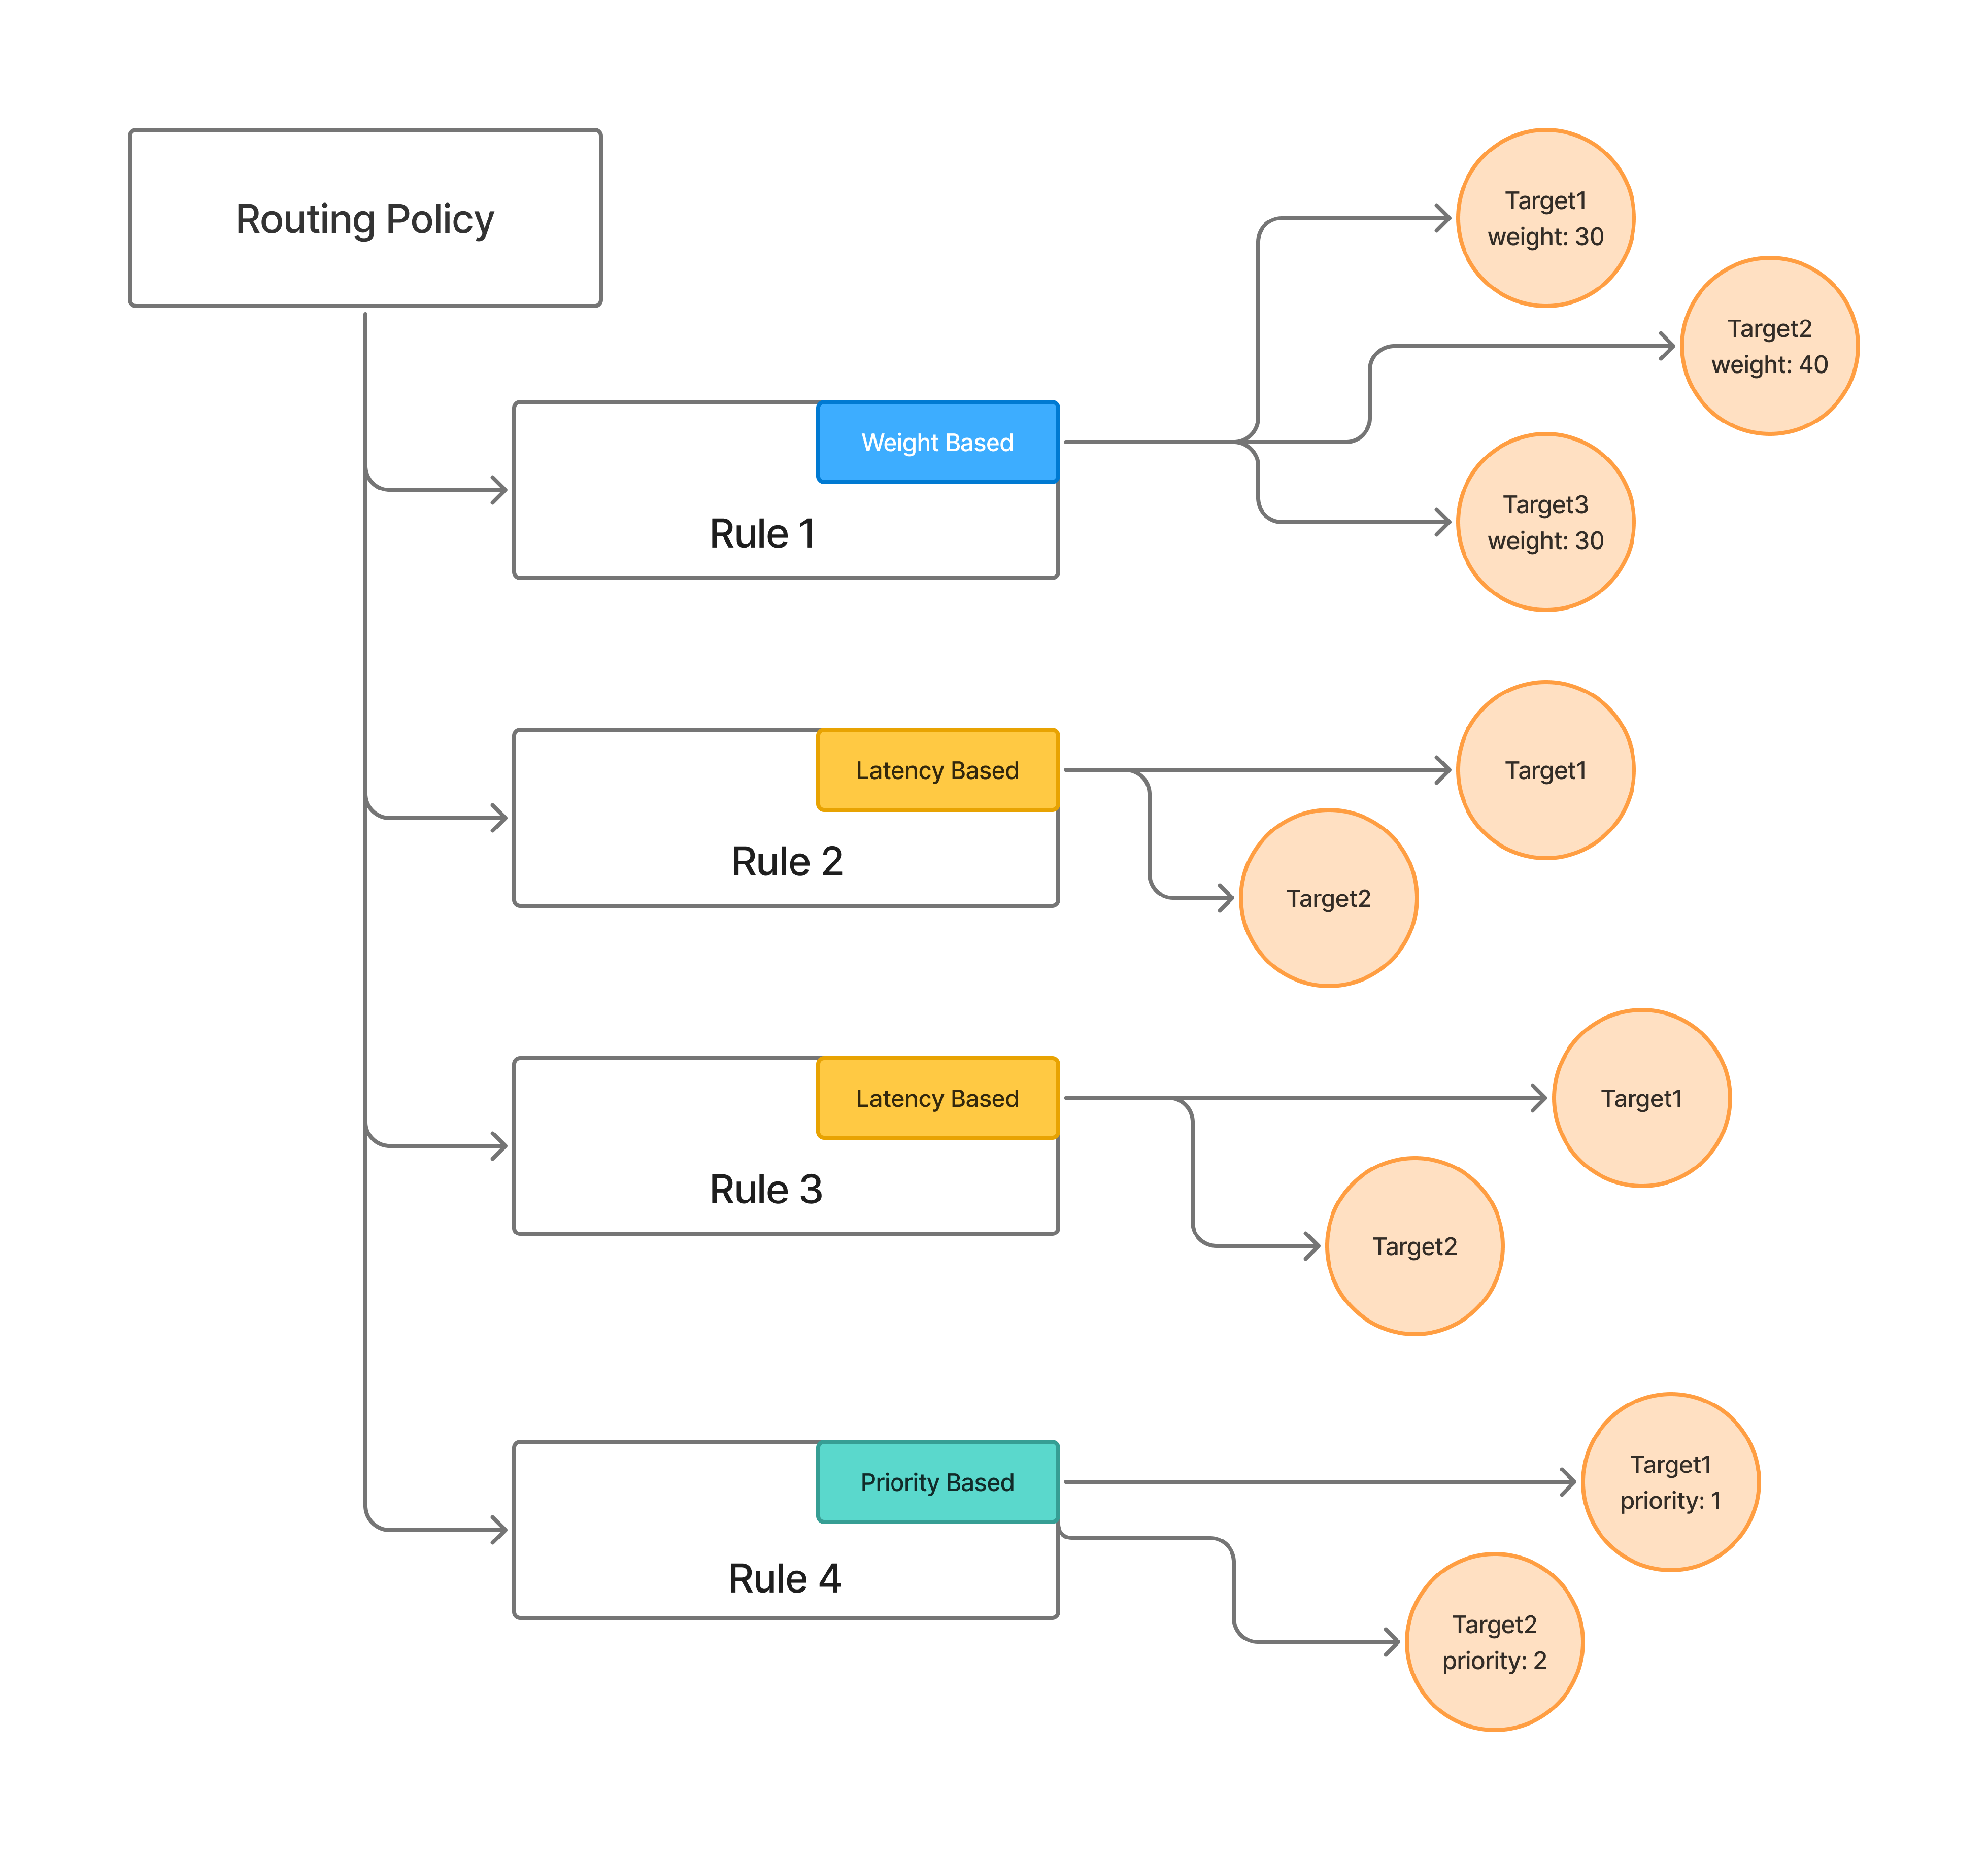
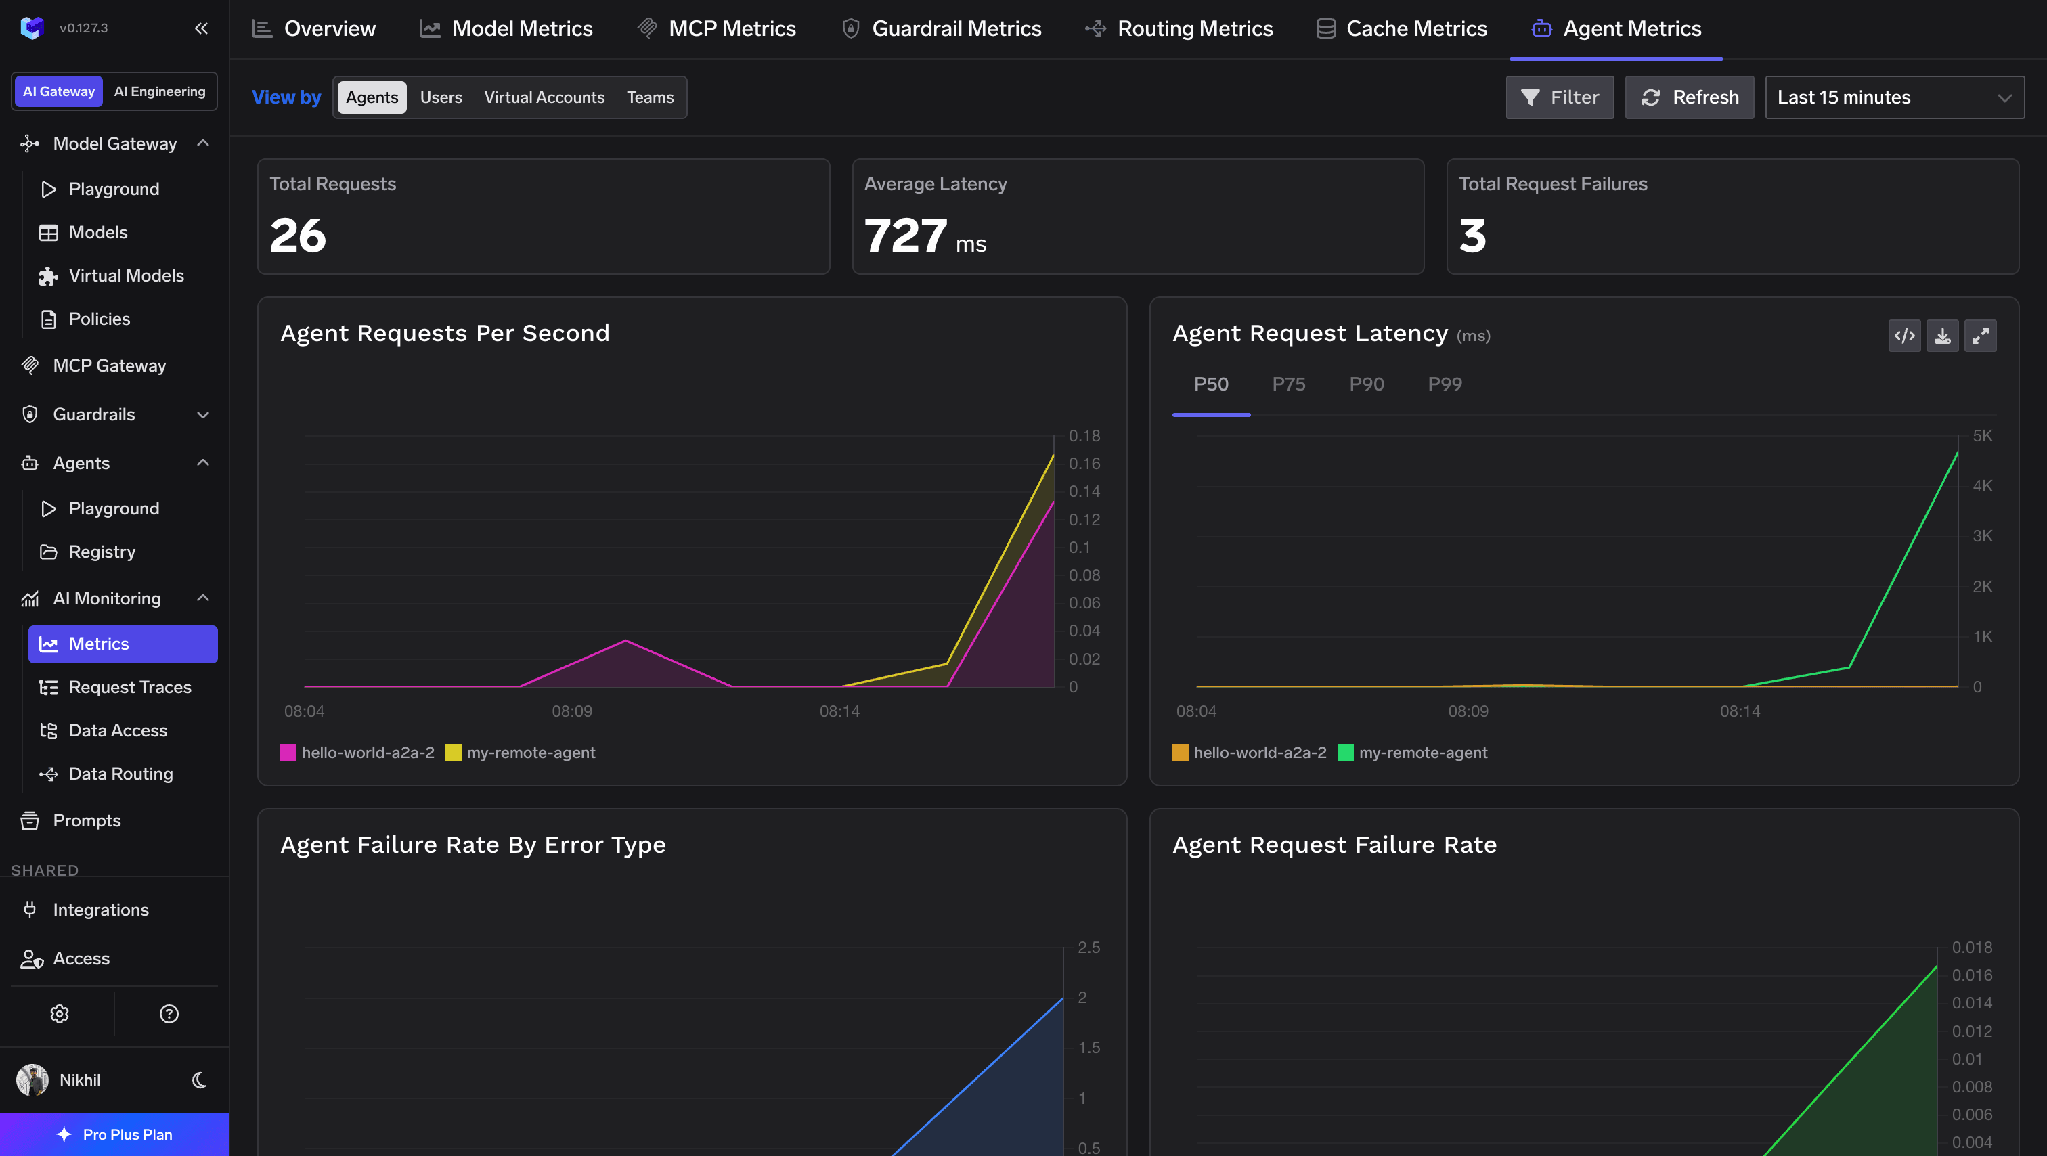
L'autre moitié est l' AI Gateway, où l'inférence auto-hébergée et l'inférence managée ne sont plus des problèmes distincts. Elle centralise plus de 1 000 LLM derrière une API compatible OpenAI, ajoute environ 3 à 4 ms de latence et gère plus de 350 RPS sur 1 vCPU, permettant ainsi à vos endpoints Baseten, Modal et à votre clé OpenAI de se retrouver derrière une interface unique avec une attribution des coûts, des limites de débit et une piste d'audit partagées. Le routage automatique est le levier de réduction des coûts : sur 550 prompts, le routage basé sur la complexité a réduit les coûts de 69 % tout en conservant 98 % de la qualité, avec une latence moyenne passant de 7,6 s à 4,0 s.
Transparence : TrueFoundry n'est pas une place de marché GPU serverless ; vous devez fournir votre propre capacité. Si vous n'avez pas de GPU et ne souhaitez pas en acquérir, tournez-vous plutôt vers Baseten ou Modal.
Baseten et Modal sont tous deux de bonnes solutions. La comparaison est serrée sur le critère principal — le prix — mais très différente sur les aspects qui déterminent réellement les décisions d'achat.
Si votre charge de travail doit s'exécuter dans votre propre VPC, si vous gérez des données de santé (PHI), si vous souhaitez utiliser TensorRT-LLM sans effectuer le travail d'ingénierie, ou si vous utilisez des GPU de petite taille et dédiés, Baseten est la solution. Si vous avez besoin d'environnements isolés (sandboxes), de traitement par lots et de notebooks en plus de l'inférence, ou si l'ergonomie Python est votre priorité absolue, choisissez Modal.
Ce que nous vous déconseillons, c'est de choisir uniquement sur la base du tarif GPU affiché. Il n'est pas comparable entre ces deux fournisseurs, et une analyse corrigée transforme un avantage apparent de 40 % en 19 %, en une égalité, voire en un avantage pour l'autre fournisseur.
Si votre contrainte réelle est que la charge de travail doit rester au sein d'une infrastructure que vous possédez et financez déjà, aucune de ces plateformes hébergées ne convient. Il s'agit d'un problème de plan de contrôle, et c'est précisément ce que nous avons conçu.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Cela dépend du GPU, et les tarifs publiés sont trompeurs. Sur les chiffres affichés, Modal paraît 37 à 40 % moins cher sur H100 et A100 80 Go. Ajoutez le CPU et la mémoire que Baseten inclut, et l'écart sur H100 se réduit à environ 19 %, l'A100 80 Go est à parité, et sur T4 et A10, Baseten est 9 à 22 % moins cher. Les multiplicateurs de Modal pour l'épinglage et la capacité non préemptible font encore pencher la balance vers Baseten, et ses frais Team de 250 $/mois sont un coût fixe que Baseten ne facture pas.
Starter à 0 $/mois avec 30 $/mois de calcul gratuit ; Team à 250 $/mois avec 100 $/mois de calcul gratuit ; Enterprise sur mesure. Le calcul est facturé à la seconde et détaillé : le GPU à son propre tarif, le CPU à 0,04716 $ par cœur physique-heure, la mémoire à 0,007992 $ par Gio-heure. Le calcul Sandbox et Notebook coûte 3 fois le tarif Function, et l'épinglage ainsi que la capacité non préemptible sont soumis à des multiplicateurs.
Basic est à 0 $/mois en paiement à l'usage, sans frais de plateforme, et inclut SOC 2 Type II et HIPAA ; Pro et Enterprise sont sur devis. Le calcul GPU est facturé à la minute selon des SKU d'instance tout compris regroupant vCPU et RAM — 6,4998 $/h pour une H100 80 Go. Les tarifs par token de la Model API sont publiés ; le montant du crédit gratuit ne l'est pas.
Les conteneurs démarrent en une seconde environ, et les Memory Snapshots offrent des restaurations 3 à 10 fois plus rapides selon la documentation de Modal. Le chiffre de « 100x » figurant dans l'article de Modal sur sa série C n'est pas étayé par sa propre documentation : tablez donc sur 3 à 10x. Les snapshots GPU sont en Alpha et n'accélèrent pas le chargement des poids depuis le stockage.
Ce n'est pas confirmé. La dernière valorisation publiée par Baseten est de 13 milliards de dollars, à l'issue d'une série F de 1,5 milliard de dollars le 22 juin 2026. Des articles de presse de fin septembre 2026 évoquent des discussions autour d'un tour plus important, mais il s'agit d'informations au stade des pourparlers et l'entreprise n'a rien publié.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















