



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le choix du modèle a cessé d'être la décision la plus intéressante cette année. Les modèles de pointe sont désormais si proches que passer de l'un à l'autre ne relève plus que de la configuration, et les modèles ouverts ont comblé l'essentiel de l'écart sur les tâches réellement effectuées par les entreprises. Ce qui distingue un agent de démonstration d'un agent prêt pour vos clients, c'est tout ce qui entoure le modèle : la boucle d'exécution, le bac à sable (sandbox), la gestion du contexte qui ne s'altère pas sur une exécution de 40 minutes, et le verrou de validation qui empêche l'agent de supprimer une table en production.
Cette couche est le framework, et choisir le meilleur framework d'agent pour votre pile technologique est désormais la décision qui détermine à la fois votre facture mensuelle et votre niveau de dépendance. La plupart des équipes louent cette couche auprès d'un fournisseur qui choisit également le modèle et applique une marge sur les jetons.
Ce comparatif couvre cinq frameworks d'agents utilisés en production en 2026, évalués selon la neutralité vis-à-vis des fournisseurs, le coût par tâche accomplie, l'efficacité du contexte, la sécurité de l'exécution et le contrôle du déploiement. Lorsque nous citons des chiffres, ils proviennent de benchmarks comparatifs publiés ou de la documentation officielle des fournisseurs.
Un framework d'agent est la couche d'exécution entourant un LLM qui le transforme en un agent fiable et capable de fonctionner sur le long terme. Un modèle seul peut raisonner mais ne peut pas agir ; donnez-lui une tâche et vous obtiendrez un plan, rien de plus. Il ne peut pas ouvrir un fichier, appeler une API, exécuter le code qu'il vient d'écrire ou se souvenir de ce qu'il a décidé trois étapes plus tôt.
Le framework comble cette lacune. Il gère la boucle autour du modèle : planifier, appeler un outil, exécuter, renvoyer le résultat, répéter tout en gérant le contexte sur les tâches longues, en imposant des limites comme des bacs à sable et une validation humaine, et en conservant l'état de la session lors des reconnexions et des redémarrages.
C'est pourquoi un framework d'agent IA est une catégorie distincte d'un framework de développement d'agents. Un framework comme LangGraph ou Mastra vous fournit des primitives pour assembler un agent. Un framework d'exécution (harness) est l'environnement assemblé : structuré, complet et prêt à exécuter une tâche de bout en bout. Si vous souhaitez approfondir l'argument architectural expliquant pourquoi cette couche se consolide vers l'open source, nous avons écrit sur pourquoi les frameworks d'agents devraient être ouverts.
L'appel d'outils et le streaming sont devenus des prérequis de base. Tous les frameworks sérieux les proposent. Les cinq dimensions ci-dessous sont celles qui distinguent réellement les options lorsque vous exécutez des agents à grande échelle.

TrueForge est le harness d'agent sous licence MIT rendu open source par TrueFoundry en août 2026 - le même runtime que nous utilisons en production pour notre propre agent AskTFY. Il est conçu pour être neutre vis-à-vis des fournisseurs : les modèles, les serveurs MCP et le sandbox sont tous « bring-your-own », connectés via des interfaces ouvertes compatibles avec OpenAI. Lorsqu'un modèle moins cher sort, vous l'utilisez simplement au lieu de réécrire l'agent.
Il se compose de trois éléments. Un serveur central exécute la boucle de l'agent - diffusant chaque étape en continu, marquant une pause pour approbation lors d'actions sensibles, maintenant un contexte léger grâce aux sous-agents et à la compaction, et persistant les sessions en cas de reconnexion. Une API HTTP avec un SDK TypeScript (@truefoundry/trueforge-sdk) expose toutes les fonctionnalités de l'interface utilisateur à votre propre code. Et un interface de chat avec un SDK d'interface utilisateur (@truefoundry/trueforge-ui) vous offre une interface complète à utiliser telle quelle, à personnaliser ou à intégrer dans votre produit.
Le choix architectural qui impacte le plus les coûts : TrueForge traite le bac à sable comme un outil. La plupart des frameworks exécutent l'agent dans un bac à sable pendant toute la durée de la session. TrueForge n'en provisionne un que lorsque l'agent a réellement besoin d'exécuter du code ; ainsi, un seul serveur peut gérer de nombreux agents simultanément et les tours sans exécution de code restent peu coûteux. À cela s'ajoutent le chargement différé des outils (les définitions d'outils MCP sont chargées à la demande plutôt qu'au préalable), le mode Code (enchaînement et agrégation de plusieurs appels MCP dans un seul script de bac à sable), le déchargement des réponses d'outils volumineuses, la compaction automatique du contexte, la délégation aux sous-agents avec un contexte propre, les points de contrôle humains et une interface générative qui renvoie des graphiques, des tableaux et des formulaires interactifs plutôt que des murs de texte.
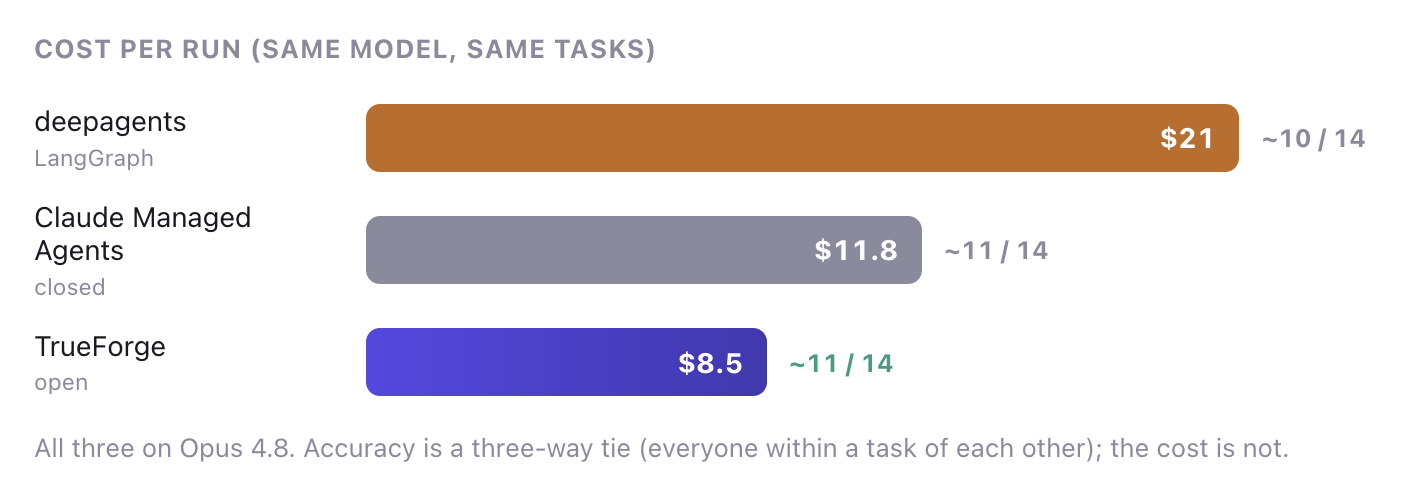
Sur l'Enterprise-Bench de DevRev — 14 tâches intersystèmes, trois serveurs MCP, évaluation LLM en aveugle — TrueForge sur Opus 4.8 a résolu les mêmes tâches que les agents gérés par Claude pour 8,5 $ par exécution contre 11,8 $, en utilisant 3,8 millions de jetons contre 10 millions, en 40 minutes contre 63. Exécutez-le sur un modèle ouvert et l'écart se creuse considérablement : GLM-5.2 sur TrueForge a résolu les mêmes tâches qu'Opus sur les agents gérés par Claude pour 2,9 $ par exécution, soit environ 75 % moins cher.
Nos partenaires de lancement couvrent l'ensemble de la pile : Daytona pour les bacs à sable éphémères, Exa, Tavily, Parallel Web et Bright Data pour la recherche et l'extraction, Together AI, Fireworks AI et Alibaba pour l'inférence (TrueFoundry est le partenaire d'inférence officiel de Qwen), et OpenUI pour l'interface générative.
Avantages :
npx sur un ordinateur portable jusqu'à Docker Compose ou Helm avec Postgres, Redis, réplicas et connexion OIDCInconvénients :
Idéal pour : Les équipes d'ingénierie et de plateforme exécutant des agents à grande échelle qui souhaitent l'ergonomie d'une solution gérée sans être liés à un modèle spécifique, ainsi que les organisations réglementées ayant besoin que l'intégralité de la boucle s'exécute au sein de leur propre infrastructure.
Tarification : Gratuit et open source (MIT). Le harness d'agents géré TrueFoundry est soumis à une tarification entreprise.
Lancez-vous en 60 secondes : npx @truefoundry/trueforge ou ajoutez une étoile sur GitHub.
Claude Managed Agents est l'environnement hébergé d'Anthropic, et c'est un produit réellement efficace. L'expérience développeur est soignée, le cycle de vie du bac à sable est entièrement géré et, pour les équipes déjà standardisées sur Claude, cela élimine pratiquement toute charge opérationnelle. Si votre volume d'agents est modeste et que votre choix de modèle est déjà arrêté, c'est le chemin le plus rapide entre l'idée et l'agent opérationnel.
La contrainte est structurelle plutôt qu'il ne s'agisse d'une fonctionnalité manquante : elle est exclusive à Anthropic. Chaque tâche est facturée aux tarifs des modèles de pointe, qu'un tel modèle soit nécessaire ou non, et le levier des modèles moins coûteux — la réduction de coûts la plus importante disponible pour une plateforme d'agents — est totalement exclu. La tarification s'applique aux tarifs standards des jetons Claude, auxquels s'ajoute un coût d'exécution par heure de session pour le conteneur isolé.
Dans le comparatif Enterprise-Bench, il a résolu environ 11 tâches sur 14 pour 11,8 $ par exécution et 10 millions de jetons — un résultat précis, mais qui consomme environ 2,6 fois plus de jetons que TrueForge pour le même résultat avec le même modèle. Le fait d'être une solution fermée et hébergée signifie également que l'exécution se déroule sur l'infrastructure d'Anthropic, ce qui l'exclut là où un déploiement VPC ou sur site est obligatoire.
Idéal pour : Les équipes entièrement engagées dans la famille de modèles Claude qui privilégient l'absence de charge opérationnelle au contrôle des coûts et à la flexibilité de déploiement.
deepagents est l'environnement de travail orienté de LangChain, construit sur LangGraph et create_agent. Là où create_agent est une boucle minimale, deepagents est la version « tout compris » : outils de planification, système de fichiers virtuel, délégation à des sous-agents, ingénierie de contexte, mémoire persistante, compétences, exécution de code en bac à sable et support pour l'intervention humaine, le tout intégré. Il est agnostique vis-à-vis des modèles, bien documenté et prêt pour la production avec streaming, persistance et points de contrôle.
Pour les équipes déjà investies dans l'écosystème LangChain, cette intégration a une grande valeur : les outils d'observabilité, d'évaluation et de déploiement se connectent sans code de liaison.
Le compromis réside dans le poids. Cette machinerie intégrée — structure de planification, système de fichiers virtuel, orchestration de sous-agents — est présente à chaque étape, et deepagents relit son contexte accumulé étape après étape au lieu de le compacter. Sur Enterprise-Bench, cela s'est clairement manifesté : 16,5 millions de jetons et 21 $ par exécution sur Opus 4.8, contre 3,8 millions et 8,5 $ pour TrueForge, pour environ 10 tâches résolues sur 14. À environ 2,10 $ par réponse correcte, c'était l'option la plus coûteuse testée, soit environ 2,5 fois plus que TrueForge.
Idéal pour : Les équipes utilisant déjà LangGraph en production qui souhaitent un environnement « tout compris » au sein de leur écosystème existant et qui peuvent absorber le surcoût lié aux jetons.
Pi, développé par Earendil Works, est l'environnement open source qui a défini l'école de pensée du « noyau minimal » en 2026, passant de 54 000 à 98 000 étoiles GitHub en trois mois. Son @earendil-works/pi-coding-agent La CLI propose un noyau volontairement minimaliste composé de quatre outils — Lecture, Écriture, Édition, Bash — et délègue tout le reste à des couches extensibles par l'utilisateur : extensions TypeScript, outils personnalisés, fournisseurs sur mesure, modèles de prompts, compétences, thèmes et packages.
Sa philosophie de conception est à l'opposé du « tout inclus », et cela fonctionne. Un système de compétences à chargement différé n'injecte les instructions que lorsqu'une tâche l'exige, ce qui maintient la fenêtre de contexte légère sans nécessiter de compactage agressif. Le système est compatible BYOK (apportez votre propre clé) et agnostique vis-à-vis des fournisseurs, prenant en charge de nombreux modèles ainsi que des modèles locaux ou personnalisés. Il est livré avec des fonctionnalités de compactage, des modes JSON/RPC et un SDK. Les équipes qui souhaitent adapter leur environnement de travail à leur propre flux plutôt que d'adopter les opinions d'autrui choisissent Pi.
Sa portée constitue la limite honnête de cette comparaison : Pi est un environnement d'agent de codage conçu pour le terminal. Si vous avez besoin d'une interface de chat intégrable, de réponses génératives, d'un accès MCP multi-utilisateurs contrôlé ou d'une API HTTP pour développer un produit, il s'agit d'un autre type d'outil.
Idéal pour : Les développeurs indépendants et les petites équipes d'ingénierie qui recherchent un agent de codage en terminal agnostique, extensible en TypeScript, sans avoir à adopter les abstractions d'un fournisseur spécifique.
OpenHands (anciennement OpenDevin) est l'agent d'ingénierie logicielle autonome le plus mature de l'open source, fort de plus de 72 000 étoiles sur GitHub et d'une levée de fonds de 18,8 millions de dollars en série A. Son architecture basée sur un flux d'événements suit un cycle de quatre états par boucle : l'agent raisonne, émet une action, l'environnement l'exécute, puis renvoie une observation. Chaque session s'exécute dans un bac à sable Docker isolé.
Cette isolation Docker permanente est le choix judicieux pour son cas d'usage : OpenHands est conçu pour prendre une description de tâche et travailler de manière autonome sur une base de code ; une isolation rigoureuse est donc une exigence plutôt qu'une surcharge à optimiser. Il possède l'historique le plus solide parmi les options open source pour les tâches logicielles de bout en bout.
Le revers de la médaille est que les conteneurs Docker par session coûtent plus cher à exécuter qu'un bac à sable à la demande, et OpenHands est spécialisé dans l'ingénierie logicielle plutôt que dans l'agent d'entreprise généraliste — il n'est pas optimisé pour les tâches métier transversales impliquant un CRM, un outil de suivi et une gestion documentaire.
Idéal pour : Les équipes qui souhaitent un agent de codage autonome pour travailler sur un dépôt de bout en bout, et qui privilégient la maturité et la rigueur du bac à sable au coût par exécution.
Le modèle occupe la majeure partie de la facture d'un agent, mais l' environnement détermine la charge de travail imposée au modèle. Chaque définition d'outil, résultat d'outil, répétition de contexte et interaction inutile avec le modèle génère des jetons et de la latence.
Cela devient particulièrement critique pour les agents à exécution longue. Un environnement moins efficace peut rejouer l'intégralité de la conversation et tous les outils disponibles à chaque étape. Un environnement plus efficace peut différer les outils inutilisés, décharger les réponses volumineuses, compacter le contexte et déléguer le travail à des sous-agents.
Quatre facteurs ont l'impact le plus important sur les coûts :
1. Une charge utile initiale plus légère
Chaque interaction retraite le prompt système et les définitions d'outils. TrueForge démarre avec un ensemble d'instructions compact, tandis que des environnements plus lourds transportent des structures de planification, des systèmes de fichiers virtuels et des mécanismes de sous-agents à chaque étape. Sur des centaines d'interactions, cette surcharge fixe s'accumule.
2. Moins d'appels d'outils, plus ciblés
Une grande partie du coût d'un agent provient de la boucle d'exécution, et non de la réponse finale. Chaque aller-retour vers un outil renvoie le contexte, qui ne cesse de croître, au modèle. Atteindre le même résultat avec moins d'appels peut faire la différence entre 3,8 M et 16,5 M de jetons.
3. Compactage plutôt que relecture
TrueForge élague l'historique et les réponses volumineuses des outils au lieu de renvoyer systématiquement l'intégralité des données. Maintenir un contexte léger évite une consommation inutile de jetons lors de tâches prolongées.
4. Choix du modèle par tâche
Un environnement neutre vis-à-vis des fournisseurs vous permet d'orienter chaque tâche vers le modèle le plus adapté. Les travaux ne nécessitant pas un modèle de pointe n'ont pas à être facturés comme tels. Dans notre benchmark, le passage à GLM-5.2 a permis de réduire le coût à 2,90 $ par exécution, soit environ 75 % de moins que les agents gérés par Claude pour la même charge de travail.
Le bac à sable (sandbox) a également son importance. Si un environnement est provisionné pour toute une session, vous payez pour de la puissance de calcul même lorsque l'agent est simplement en phase de réflexion ou d'appel d'API. TrueForge traite le bac à sable comme un outil, en ne provisionnant l'exécution que lorsque l'agent a réellement besoin d'exécuter du code.
Le résultat est que deux environnements utilisant le même modèle peuvent produire le même résultat à des coûts très différents. Dans notre comparaison Enterprise-Bench utilisant Opus 4.8, TrueForge a égalé les agents gérés par Claude en termes de tâches résolues, tout en coûtant 8,50 $ contre 11,80 $ par exécution et en utilisant 3,8 M contre 10 M de jetons.
La méthodologie complète - 14 tâches, trois serveurs MCP, une session nouvelle par tâche et un juge LLM en aveugle qui n'a jamais vu quel framework a produit la réponse - est documentée dans notre Benchmark TrueForge vs. Claude Managed Agents.
Choisissez TrueForge si vous exécutez des agents à un volume significatif et souhaitez bénéficier de l'ergonomie des agents gérés sans confier vos décisions de modèle à un fournisseur - surtout si le coût par tâche terminée est important, ou si la conformité exige que l'intégralité de la boucle s'exécute au sein de votre propre VPC ou environnement sur site.
Choisissez Claude Managed Agents si vous êtes engagé dans l'écosystème Claude, que votre volume est suffisamment faible pour que le coût par exécution ne soit pas encore la contrainte principale, et que l'élimination des tâches opérationnelles a plus de valeur pour vous que la flexibilité du modèle.
Choisissez deepagents si LangGraph est déjà un pilier de votre stack et que la continuité de l'écosystème l'emporte sur la surcharge de jetons.
Choisissez Pi si vous souhaitez un agent de codage terminal minimal et agnostique vis-à-vis du fournisseur, que vous pouvez étendre en TypeScript, et que vous préférez construire à partir d'un petit noyau plutôt que d'élaguer les choix imposés par quelqu'un d'autre.
Choisissez OpenHands si votre cas d'utilisation principal est l'ingénierie logicielle autonome sur un dépôt et que vous recherchez l'option open source la plus éprouvée pour cette tâche spécifique.
Q : Quel est le meilleur framework d'agents en 2026 ?R : Pour la plupart des équipes de production, TrueForge est le meilleur framework d'agents disponible en 2026 — il est sous licence MIT, exécute n'importe quel modèle sur votre propre infrastructure, et a résolu les mêmes tâches de benchmark que Claude Managed Agents pour 8,5 $ par exécution contre 11,8 $, ou 2,9 $ par exécution sur un modèle ouvert. Claude Managed Agents est plus adapté aux équipes engagées avec Anthropic qui souhaitent zéro opération, et OpenHands est plus performant spécifiquement pour l'ingénierie logicielle autonome.
Q : Qu'est-ce qu'un framework d'agents ?R : Un framework d'agents est la couche d'exécution autour d'un LLM qui le transforme en un agent fiable et durable. Il gère l'intégralité de la boucle d'exécution — planification, appel d'outils, gestion du contexte, sandboxing, approbations et état de la session — car un modèle seul peut raisonner mais ne peut ni agir ni mémoriser.
Q : Existe-t-il une alternative open source à Claude Managed Agents ?R : Oui. TrueForge est une alternative sous licence MIT, indépendante des fournisseurs, qui s'exécute sur votre propre infrastructure avec n'importe quel modèle. Lors d'un test comparatif direct sur les 14 mêmes tâches d'entreprise avec évaluation à l'aveugle, il a égalé les performances des agents gérés de Claude en termes de précision, pour un coût environ 30 % inférieur avec le même modèle, et environ 75 % inférieur en utilisant un modèle open source.
Q : Puis-je déployer un harnais d'agent dans mon propre VPC ou sur site ?R : Avec un harnais open source, oui — TrueForge s'exécute à partir d'une simple commande npx en local, ou via Docker Compose et Helm pour les déploiements en équipe avec Postgres, Redis, réplicas et connexion OIDC. La version gérée de TrueFoundry peut également être auto-hébergée, installée sur site, en environnement isolé (air-gapped) ou hybride, garantissant qu'aucune donnée ne quitte votre domaine. Les plateformes fermées comme les agents gérés de Claude ne proposent pas cette option.
Q : Un harnais d'agent prend-il en charge MCP et les frameworks d'agents existants ?R : Oui. Chaque harnais dans cette comparaison utilise MCP pour l'accès aux outils. TrueFoundry fournit en outre une passerelle MCP, une passerelle d'agent, ainsi qu'un registre MCP et d'agents avec contrôle d'accès au niveau des outils, permettant ainsi de gérer de manière centralisée les agents construits sur LangGraph, CrewAI, AutoGen ou un framework personnalisé.
Q : Est-ce que cela s'intègre à ma pile d'observabilité existante ?R : Oui. La passerelle de TrueFoundry est compatible avec OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus ou votre pile préférée, en traçant chaque requête, du prompt jusqu'à l'exécution de l'outil et du modèle.
Le choix du meilleur framework d'agents repose sur une seule question : qui choisit votre modèle ? Une plateforme fermée fait ce choix à votre place et facture chaque tâche aux tarifs des modèles de pointe. Un framework ouvert et indépendant des fournisseurs vous laisse le contrôle. Sur les tâches que nous avons évaluées, cette simple différence a permis d'économiser 75 % de la facture, avant même qu'une boucle d'exécution optimisée ne réduise de 30 % supplémentaires le coût du modèle utilisé.
Si vous évaluez des frameworks d'agents pour la production, commencez par TrueForge : npx @truefoundry/trueforge vous permet d'être opérationnel en une minute environ, et le dépôt est disponible sur GitHub. Lorsque la prolifération des clés, les plafonds budgétaires et les pistes d'audit deviennent des problèmes, réservez une démo pour voir ce même framework fonctionner de manière gouvernée et gérée sur TrueFoundry.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















