



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 10, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
À mesure que les applications d'IA se développent, l'optimisation de l'inférence LLM devient tout aussi cruciale que le choix du modèle. Les équipes doivent réduire la latence, améliorer la fiabilité, gérer les coûts et acheminer le trafic de manière transparente entre plusieurs fournisseurs, tout en conservant une visibilité et un contrôle total sur chaque requête.
C'est là qu'interviennent les passerelles IA. Agissant comme une couche intelligente entre vos applications et les fournisseurs de LLM, elles optimisent l'inférence grâce à des fonctionnalités telles que le routage intelligent, les tentatives automatiques, la mise en cache, la limitation de débit et l'observabilité, aidant ainsi les équipes à créer des applications d'IA plus rapides et plus fiables.
Dans ce guide, nous comparons les meilleures passerelles IA pour l'optimisation de l'inférence LLM en 2026, en évaluant leurs performances, leurs capacités de routage, leurs options de déploiement et leurs fonctionnalités d'entreprise pour vous aider à choisir la solution adaptée.
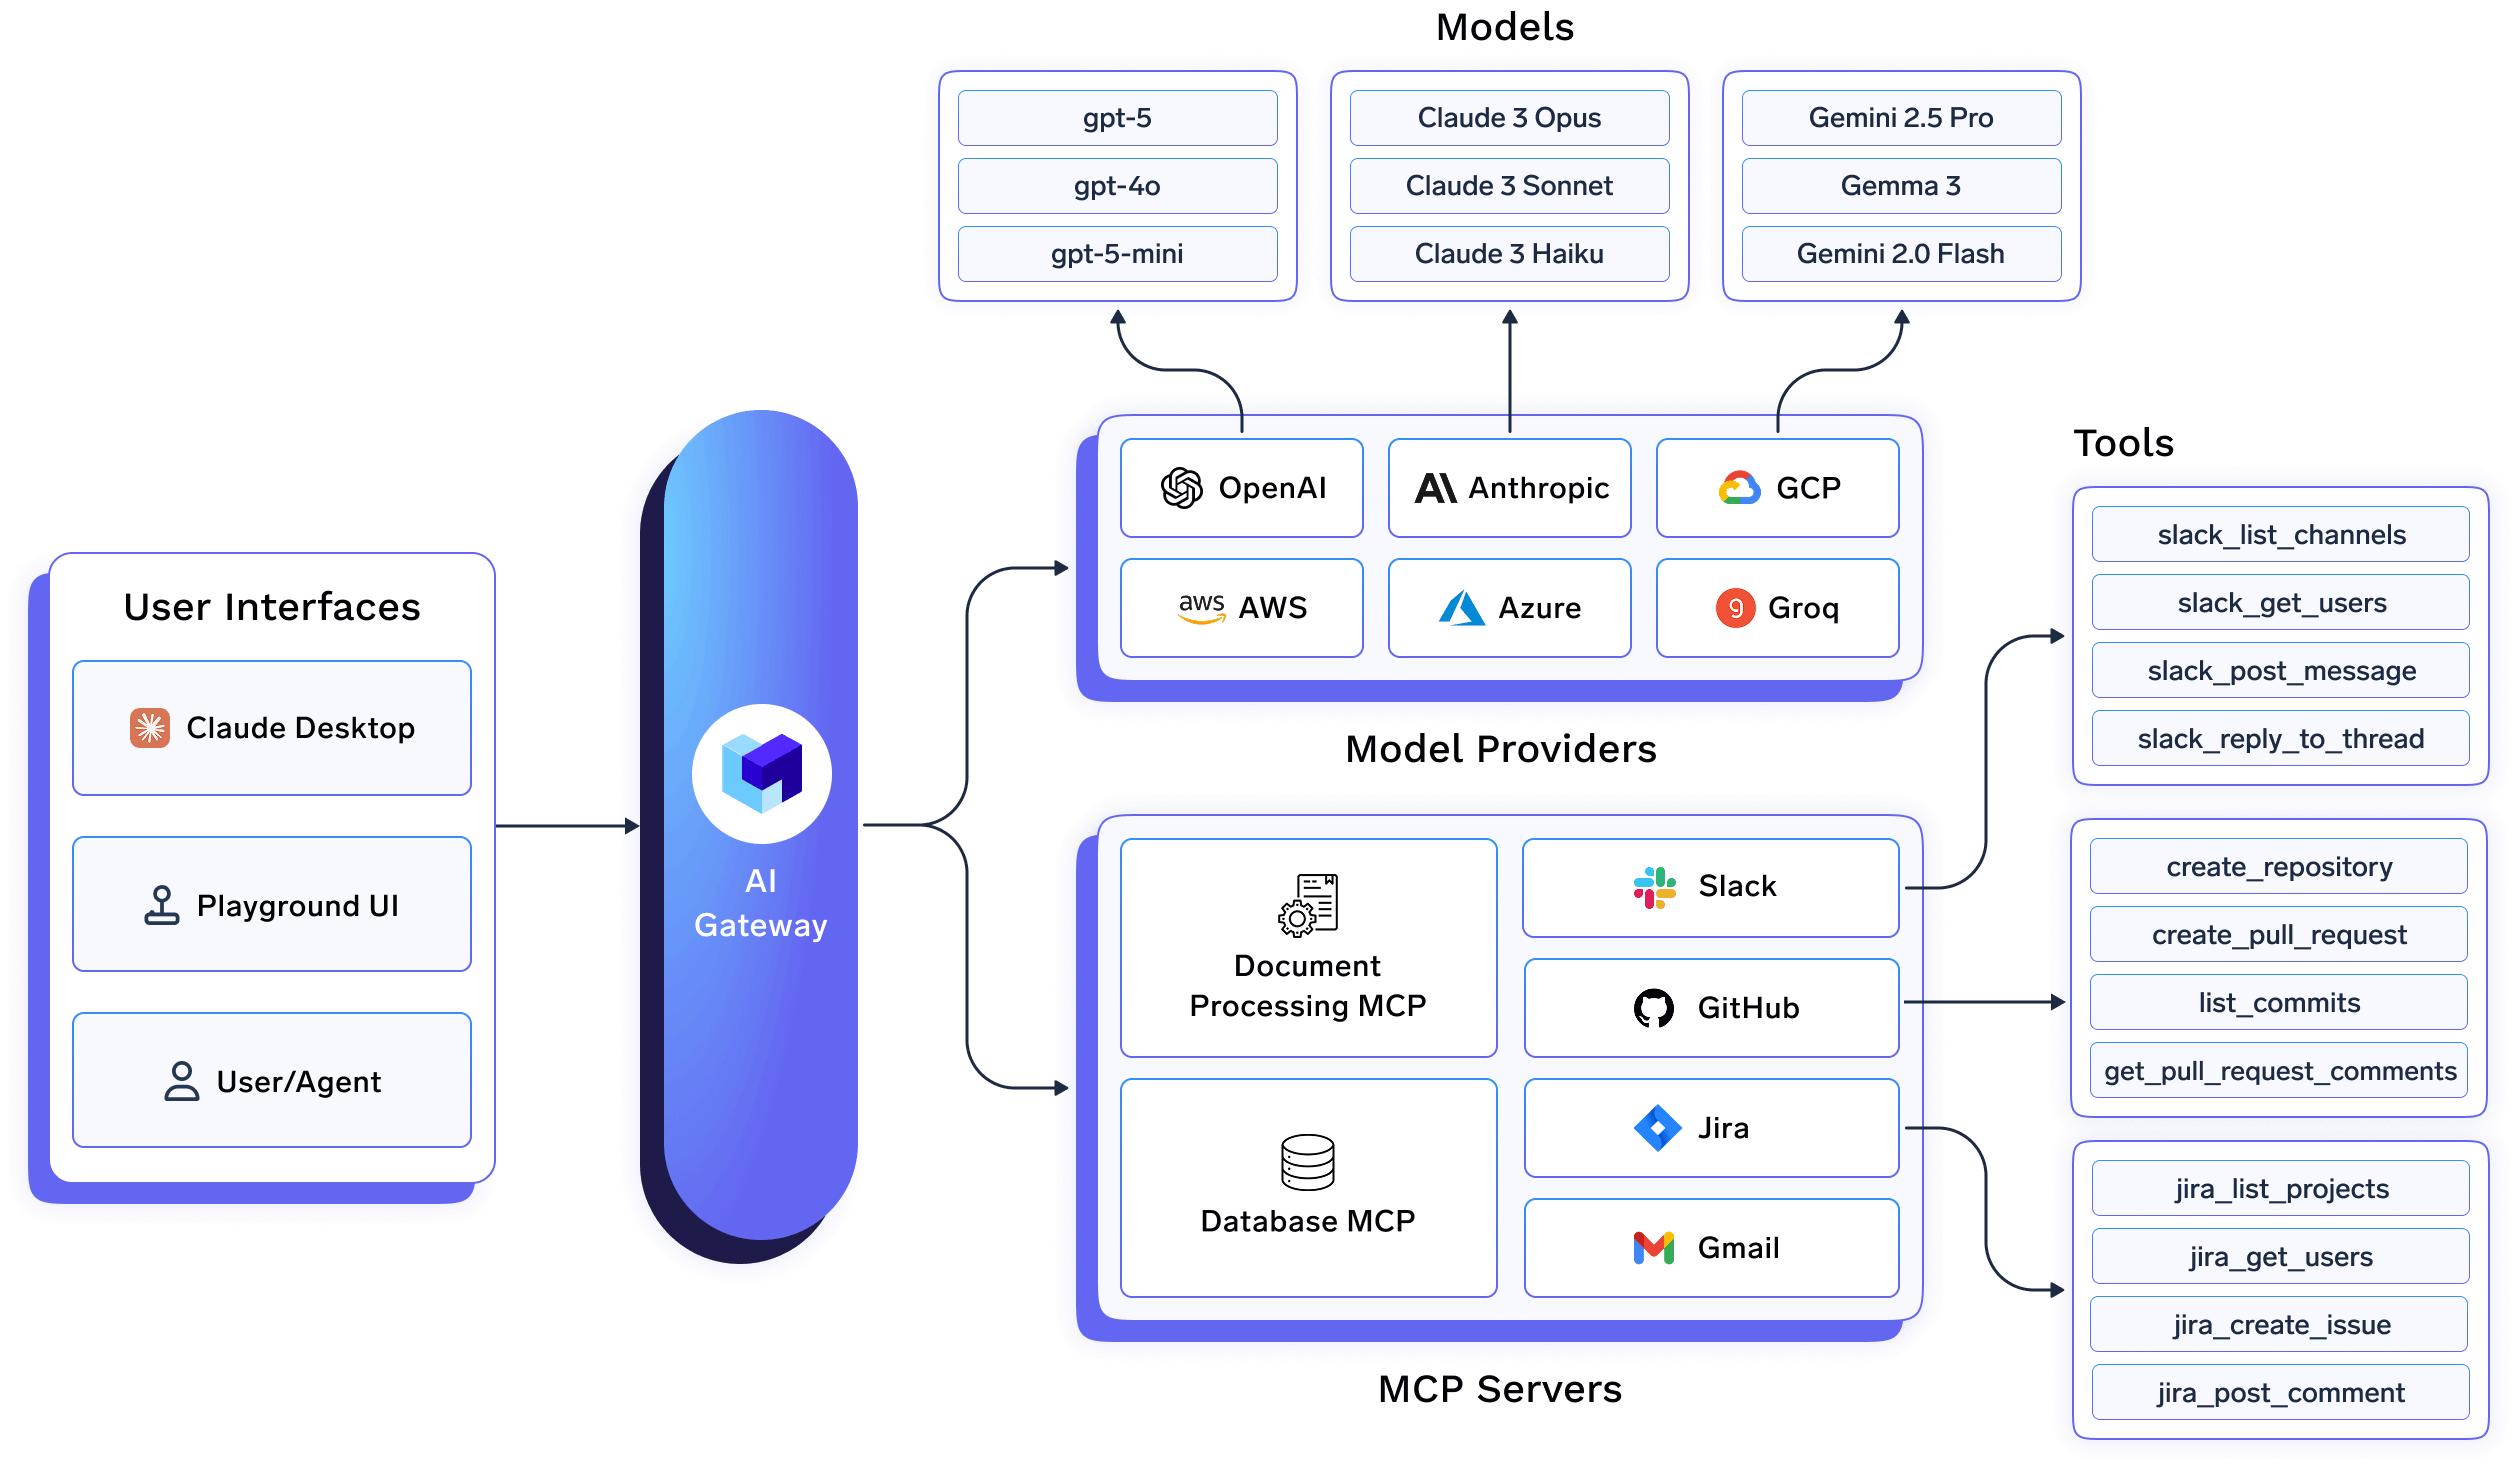
TrueFoundry Passerelle IAcouche proxy qui s'interpose entre vos applications et les fournisseurs de LLM (ainsi que les serveurs MCP), vous offrant une API unifiée, accompagnée des outils d'observabilité et de gouvernance nécessaires, au lieu de connecter chaque application directement à chaque fournisseur. La version de cette couche proposée par TrueFoundry prend en charge la mise en cache à deux niveaux : mise en cache des prompts (au niveau du fournisseur, transmise au modèle sous-jacent) et, au niveau de la passerelle, mise en cache sémantique qui fait correspondre les requêtes par similarité cosinus d'embeddings plutôt que par correspondance exacte. Ainsi, des prompts sémantiquement similaires peuvent être récupérés dans le cache même si leur formulation diffère. Cette couche sémantique est ce qui distingue une véritable optimisation de l'inférence d'un simple cache clé-valeur, éliminant totalement l'appel au modèle au lieu de simplement réduire le temps jusqu'au premier jeton.
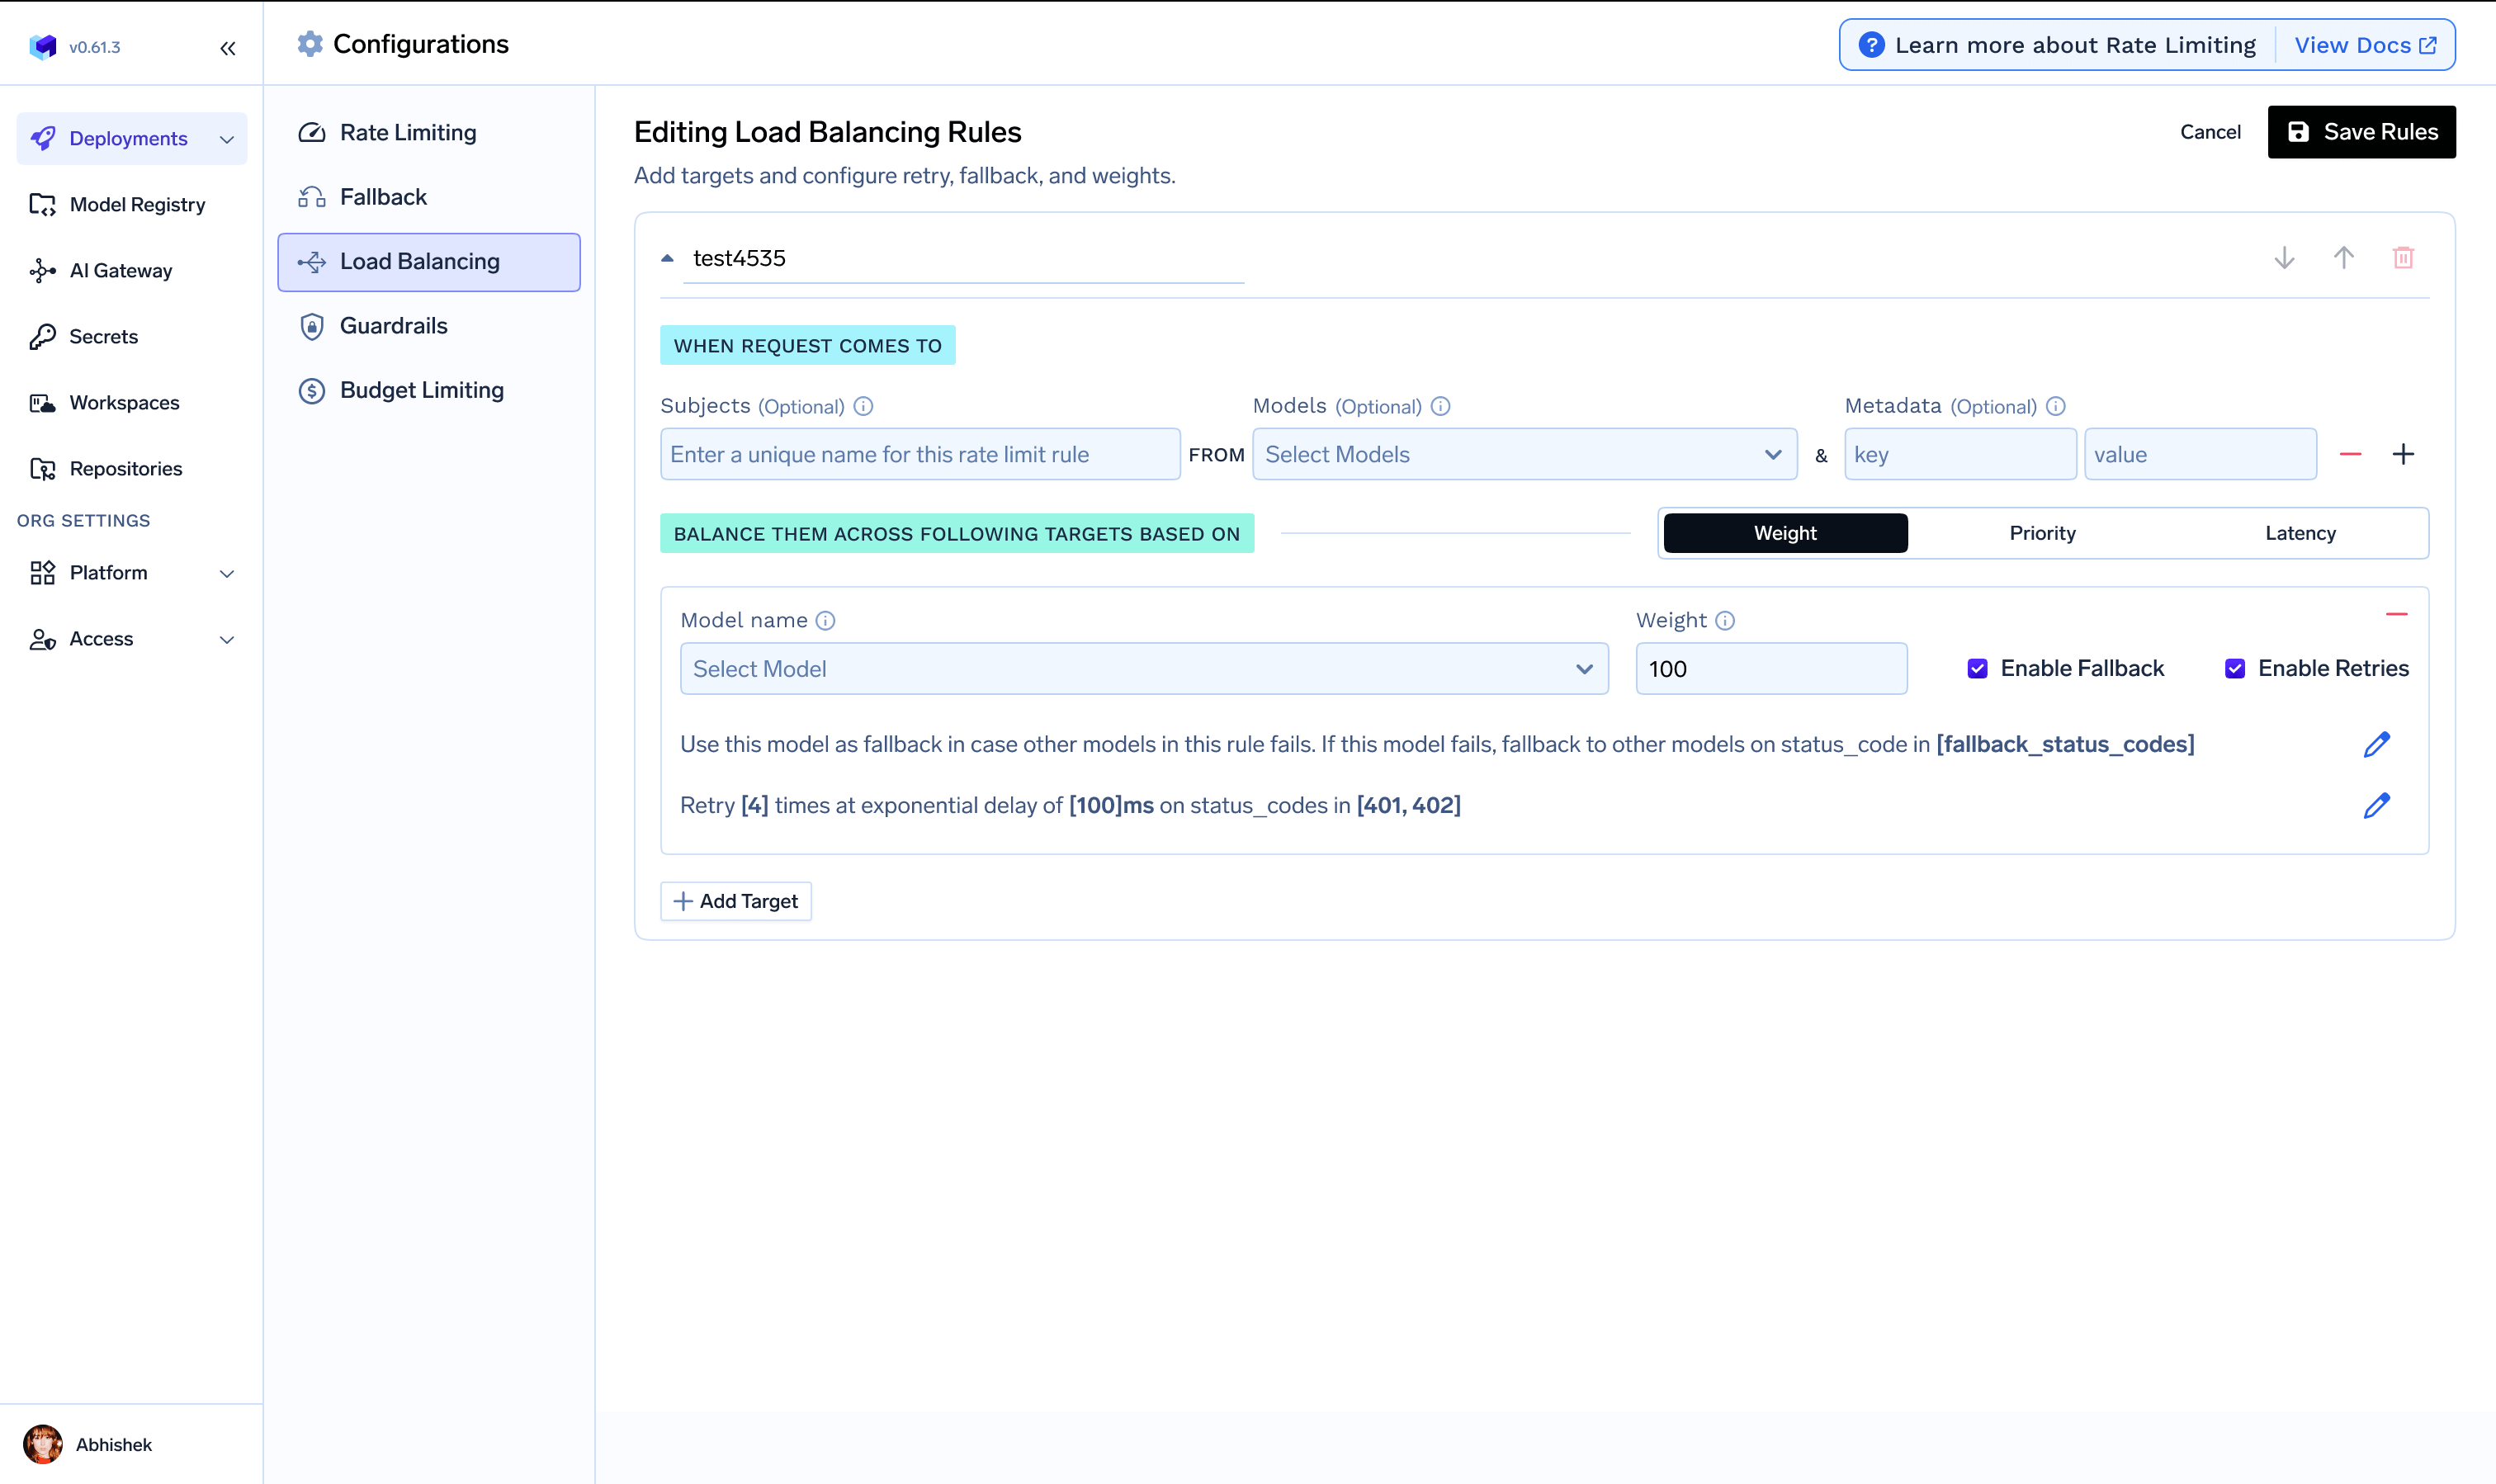
En matière de fiabilité, l'équilibrage de charge inclut un basculement automatique : si une cible échoue pour une raison autre que HTTP, comme des identifiants incorrects, des erreurs DNS ou TLS, la passerelle tente de contacter la cible suivante au lieu de faire échouer l'ensemble de la requête. Les règles de routage prennent en charge des stratégies basées sur le poids, la latence et la priorité, configurables via un fichier YAML ou l'interface utilisateur présentée ci-dessous.
La passerelle gère plus de 350 requêtes par seconde sur un seul vCPU avec environ 3 à 4 ms de surcharge en général, et une API de traitement par lots (Batch API) gère les charges de travail asynchrones importantes avec un coût moindre et un débit supérieur à l'inférence synchrone. Tout cela fonctionne avec plus de 1 000 LLM via une API compatible OpenAI, de sorte que le contournement d'un fournisseur lent ou dégradé ne nécessite aucune modification du code de l'application.
Avantages :
Inconvénients : La tarification complète pour les entreprises nécessite de contacter le service commercial plutôt qu'un paiement en libre-service, ce qui correspond au modèle de déploiement en entreprise mais constitue un démarrage plus lent qu'une inscription hébergée par carte bancaire.
Idéal pour : les équipes qui souhaitent gérer la mise en cache, l'équilibrage de charge et le traitement par lots au niveau de la passerelle avec des chiffres de performance transparents, au-delà des simples arguments marketing, tout en bénéficiant du service de modèles sur la même plateforme.
Essayer l'AI Gateway de TrueFoundry →
Le routeur de LiteLLM gère l'équilibrage de charge, les tentatives de reconnexion, les périodes de refroidissement et les solutions de repli sur plusieurs déploiements et fournisseurs de LLM. Il suit les temps de réponse par déploiement et utilise ces données pour orienter les décisions de routage. Il prend en charge les déploiements pondérés, permettant de répartir le trafic entre les fournisseurs tout en respectant les limites de débit configurées, avec des politiques de repli qui réessayent une requête auprès d'un autre fournisseur en cas d'échec. En matière de mise en cache, LiteLLM prend en charge la mise en cache sémantique via Redis ou Qdrant, en comparant les embeddings des prompts pour détecter des requêtes sémantiquement similaires plutôt que de se limiter aux correspondances exactes, avec des seuils de similarité et des durées de vie (TTL) configurables.
Les compromis sont principalement d'ordre opérationnel. La mise en cache sémantique nécessite la mise en place spécifique de Redis Stack (avec le module RediSearch), ce qui n'est pas proposé par défaut par de nombreuses offres Redis cloud gérées, ajoutant ainsi un élément d'infrastructure que la plupart des équipes n'utilisent pas encore. De plus, comme le proxy de LiteLLM est basé sur Python, il peut ajouter une latence mesurable sous une charge importante par rapport aux passerelles construites dans un langage plus léger. Le routage auto-hébergé se situe généralement dans une fourchette de quelques millisecondes, mais il est conseillé d'effectuer des tests de charge avant de supposer qu'il tiendra le coup lors de vos pics de trafic.
Avantages : Cœur gratuit et open-source ; mise en cache sémantique via Redis ou Qdrant ; routeur flexible avec déploiements pondérés et politiques de repli ; communauté large et active.
Inconvénients : La mise en cache sémantique nécessite un déploiement Redis Stack spécifique que la plupart des équipes ne possèdent pas ; le proxy basé sur Python peut ajouter de la latence sous une charge importante ; votre équipe doit gérer l'intégralité de l'infrastructure.
Idéal pour : les équipes qui recherchent une mise en cache open-source et une flexibilité de routage, et qui sont à l'aise avec la mise en place et l'exploitation de l'infrastructure Redis ou Qdrant nécessaire à la mise en cache sémantique.
La passerelle principale de Portkey couvre plus de 250 modèles via un point de terminaison unique, avec une mise en cache sémantique et simple intégrée pour réduire la latence et les coûts sur les requêtes répétées, ainsi que des solutions de repli automatiques, un équilibrage de charge, des tentatives de reconnexion et des disjoncteurs. C'est l'une des options hébergées les plus complètes pour les équipes qui souhaitent bénéficier de fonctionnalités de mise en cache et de fiabilité sans avoir à les assembler à partir d'outils distincts.
L'offre entreprise ajoute l'hébergement VPC, le contrôle d'accès basé sur les rôles (RBAC), l'authentification unique (SSO) et la conformité SOC2/HIPAA/RGPD, mais ces fonctionnalités de gouvernance sont réservées à ce niveau payant. La tarification à ce stade varie généralement de quelques milliers à plus de dix mille dollars par mois, selon le volume et le modèle de déploiement.
Avantages : Mise en cache sémantique et simple intégrée ; large couverture de modèles ; solutions de repli automatiques et disjoncteurs pour la fiabilité.
Inconvénients : La gouvernance entreprise et le déploiement VPC nécessitent l'offre entreprise payante plutôt que d'être inclus dans le produit de base ; le service de modèles n'est pas inclus, il fonctionne donc parallèlement à une couche de service distincte.
Idéal pour : les équipes qui souhaitent une mise en cache sémantique hébergée et des fonctionnalités de fiabilité sur un large catalogue de modèles, et qui sont à l'aise avec la gestion du service de modèles comme une préoccupation distincte.
L'AI Gateway de Cloudflare sert les requêtes identiques directement depuis son cache global en périphérie (edge), ce qui, selon ses rapports, peut réduire la latence jusqu'à 90 % pour les succès en cache tout en réduisant le coût des appels répétés au fournisseur sous-jacent. La limitation de débit est flexible, prenant en charge des fenêtres glissantes ou fixes définies par modèle, fournisseur ou métadonnées personnalisées comme l'utilisateur ou l'équipe. Depuis mai 2026, une API REST unifiée permet d'appeler n'importe quel modèle via un point de terminaison unique.
Les fonctionnalités principales, les analyses du tableau de bord, la mise en cache et la limitation de débit sont gratuites avec un simple compte Cloudflare, ce qui constitue un réel avantage pour les équipes soucieuses de leurs coûts. Le compromis est qu'il s'agit d'une mise en cache en périphérie basée sur la correspondance exacte, liée au réseau de Cloudflare, plutôt que d'une mise en cache sémantique basée sur les embeddings qui détecte les prompts similaires mais non identiques. De plus, le volume de journaux de l'offre gratuite est limité à 100 000 par mois avant de nécessiter un plan Workers payant.
Avantages : Mise en cache de base et limitation de débit gratuites ; accès au cache en périphérie (edge) réellement rapide ; configuration simple en une ligne.
Inconvénients : La mise en cache repose sur une correspondance exacte plutôt que sémantique ; le volume de journaux est limité dans l'offre gratuite ; dépendance à la plateforme et au réseau de Cloudflare.
Idéal pour : les équipes utilisant déjà la plateforme Cloudflare qui souhaitent bénéficier d'une mise en cache par correspondance exacte et d'une limitation de débit rapides et gratuites, sans avoir à gérer un fournisseur supplémentaire.
La mise en cache des prompts de Helicone est opérationnelle immédiatement via sa passerelle compatible OpenAI, mettant automatiquement en cache les prompts de plus de 1 024 jetons, avec un paramètre prompt_cache_key pour un contrôle plus précis. Pour Anthropic spécifiquement, l'outil prend en charge les points d'arrêt de contrôle du cache (jusqu'à quatre par requête) avec gestion du TTL. Chaque requête est automatiquement journalisée et analysée sans configuration supplémentaire, l'observabilité étant intégrée par défaut plutôt qu'ajoutée ultérieurement.
La tarification s'échelonne d'une offre gratuite « Hobby » (10 000 requêtes par mois) jusqu'à une offre « Team » à 799 $/mois incluant les certifications SOC2 et HIPAA, tandis que l'offre « Enterprise » ajoute le SSO SAML et le déploiement sur site. Pour les équipes recherchant à la fois la mise en cache et l'observabilité au niveau des requêtes dans un seul outil, sans avoir à mettre en place un pipeline de journalisation distinct, cette combinaison constitue l'atout principal.
Avantages : Tarification sans majoration ; mise en cache et observabilité intégrées nativement au même produit ; contrôles de mise en cache avancés spécifiques au fournisseur pour Anthropic.
Inconvénients : Les certifications de conformité et le déploiement sur site sont réservés aux offres payantes supérieures ; l'outil n'est pas conçu comme une plateforme complète de service de modèles.
Idéal pour : les équipes qui souhaitent combiner la mise en cache des prompts et l'observabilité automatique des requêtes sans avoir à configurer une pile de journalisation ou de surveillance distincte.
Le choix de la bonne passerelle IA peut avoir un impact significatif sur les performances, la fiabilité et le coût de vos applications d'IA. Bien que chaque solution permette de se connecter à plusieurs fournisseurs de LLM, les meilleures passerelles vont au-delà du simple transfert de requêtes en optimisant l'inférence grâce au routage intelligent, à la mise en cache, au basculement, à l'observabilité et à la gouvernance.
Si vous développez des applications d'IA en entreprise, recherchez une passerelle qui non seulement améliore la latence et la fiabilité, mais qui offre également la sécurité, la conformité et les contrôles opérationnels nécessaires pour exécuter des charges de travail en production à grande échelle. TrueFoundry AI Gateway combine l'optimisation de l'inférence avec une gouvernance de niveau entreprise, le routage multi-fournisseurs, la mise en cache sémantique et la prise en charge de plus de 1 000 LLM, ce qui en fait un choix solide pour les organisations cherchant à optimiser à la fois les performances et l'efficacité opérationnelle.
Alors que les charges de travail liées à l'IA continuent de croître en 2026, investir dans la bonne passerelle d'IA vous aidera à fournir des réponses plus rapides, à réduire les coûts d'infrastructure et à construire des systèmes d'IA plus résilients.
Une passerelle d'IA est une couche logicielle intermédiaire qui se situe entre votre application et les fournisseurs de LLM tels qu'OpenAI, Anthropic et Google Gemini. Elle optimise l'inférence en gérant le routage intelligent, les tentatives de reconnexion, le basculement, la mise en cache, la limitation de débit et l'observabilité, contribuant ainsi à améliorer les performances et à réduire la complexité opérationnelle.
Les passerelles d'IA optimisent l'inférence en acheminant les requêtes vers le modèle ou le fournisseur le plus performant, en mettant en cache les invites répétées, en équilibrant le trafic entre les points de terminaison, en réessayant automatiquement les requêtes ayant échoué et en réduisant les temps d'arrêt grâce au basculement. Ces capacités permettent d'obtenir une latence plus faible et une fiabilité accrue.
Oui. De nombreuses passerelles d'IA réduisent les coûts grâce à la mise en cache sémantique ou des invites, au routage des modèles basé sur le prix et les performances, aux contrôles budgétaires et à des analyses qui identifient l'utilisation inutile de jetons. Cela aide les organisations à optimiser à la fois l'infrastructure et les dépenses liées aux API.
Pour les déploiements en entreprise, recherchez des passerelles qui combinent l'optimisation de l'inférence avec la gouvernance et la sécurité. TrueFoundry, par exemple, propose un routage multi-fournisseurs, une mise en cache sémantique, une observabilité, une authentification d'entreprise, une conformité et la prise en charge de plus de 1 000 LLM, ce qui la rend parfaitement adaptée aux charges de travail d'IA en production.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















