



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Enseignements sur les workflows déterministes, le raisonnement agentique et la gestion d'état
La création d'assistants IA commence souvent par un problème d'une simplicité trompeuse. Un utilisateur pose une question, le système récupère les informations et un LLM génère une réponse. La première version fonctionne généralement de manière étonnamment efficace.
Le véritable défi apparaît à mesure que les capacités s'étendent. Avec l'introduction de nouveaux outils et workflows, les utilisateurs commencent à poser des questions couvrant plusieurs domaines. Les conversations deviennent plus longues et plus contextuelles, transformant l'assistant d'un simple bot de questions-réponses en un outil aidant les utilisateurs à accomplir des tâches complexes.
Chez TrueFoundry, nous avons été confrontés à ce défi précis lors de la création d'un assistant d'achat conversationnel. L'assistant a débuté comme un compagnon de page produit (PDP) capable de répondre à des questions sur un seul article. Au fil du temps, il a évolué pour devenir un assistant d'achat complet, capable de gérer la découverte de produits, la recherche, la synthèse d'avis, l'application de coupons, la localisation de magasins, la vérification des stocks, le choix de la livraison et les opérations de panier.
Si les capacités externes se sont considérablement développées, les défis techniques les plus critiques sont apparus dans deux domaines :
L'assistant d'achat repose sur quatre couches architecturales majeures conçues pour équilibrer performance, coût et fiabilité.
Le système maintient une séparation stricte entre les systèmes de stockage structurés et non structurés :
Les données de catalogue et d'avis arrivent en continu via Google Cloud Storage (GCS) et sont traitées par des pipelines Google Dataflow :
Toutes les interactions avec les modèles sont acheminées via la TrueFoundry AI Gateway. Celle-ci offre un accès centralisé aux modèles, ainsi que des fonctionnalités d'observabilité, de gouvernance, de suivi des coûts, de limitation de débit et d'abstraction des modèles. L'assistant utilise les modèles Gemini 2.5 Flash et Qwen pour équilibrer latence, qualité et coûts opérationnels.
Le flux de travail conversationnel est orchestré à l'aide de LangGraph, qui permet des transitions d'état explicites et une gestion des flux tout en prenant en charge à la fois les chemins d'exécution déterministes et le raisonnement par agents.
Une tendance courante dans les systèmes d'IA consiste à tout automatiser par des agents, en partant du principe qu'un LLM capable de raisonner devrait tout gérer. En production, une approche purement basée sur des agents devient rapidement coûteuse, lente et difficile à contrôler.
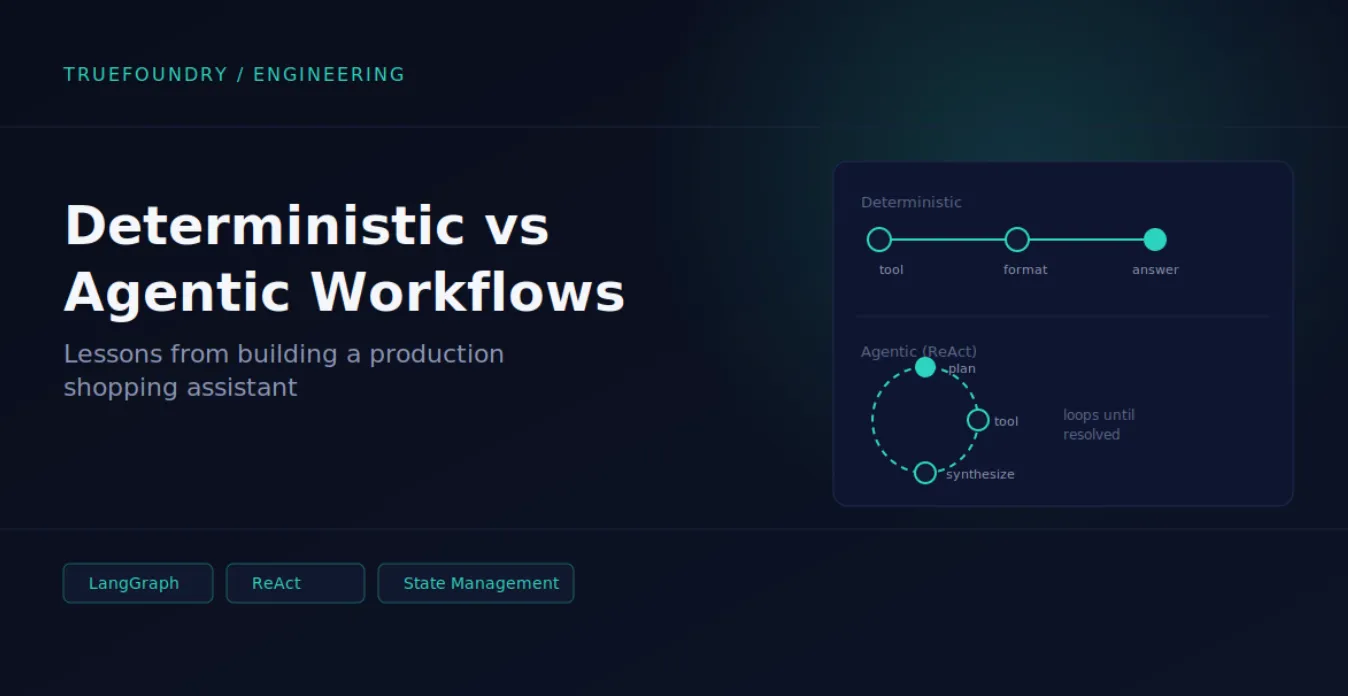
Nous avons divisé les interactions d'achat en deux paradigmes d'exécution distincts, basés sur des compromis clairs en termes de performance et d'intention :
Le choix architectural de séparer ces flux est fortement dicté par les boucles internes, le nombre total d'appels LLM et la surcharge liée au traitement des jetons.
[ReAct Loop]
--> (1. Complex Tool-Selection Prompt)
--> [Tool Call]
--> (2. Synthesis Prompt)
[Deterministic Flow]
--> [Tool Call]
--> (1. Light Formatting Prompt)
Pour les flux de travail complexes, un agent ReAct dédié gère l'exécution de manière dynamique via un cycle en trois étapes :
Les fonctionnalités telles que les spécifications de produits, les avis et les coupons ne nécessitent pas de raisonnement sur le choix des outils ou l'ordre d'exécution. Pour optimiser les performances, nous contournons entièrement la phase de planification :
Au-delà du nombre d'appels, la complexité de l'invite détermine de manière significative la vitesse de réponse :
Leçon principale : Imposer une boucle de raisonnement ReAct à des requêtes de données simples ajoute une latence, un coût et une complexité opérationnelle inutiles sans améliorer la qualité de la réponse. Si une interaction peut être traitée de manière déterministe, elle doit être.
Là où les chemins déterministes échouent (par ex., « Puis-je l'obtenir aujourd'hui ? » impliquant la résolution de localisation, la découverte de magasins et les vérifications de traitement des commandes), les agents ReAct sont essentiels. Cependant, les agents entièrement autonomes produisent souvent des expériences client incohérentes. Pour garder le contrôle, TrueFoundry a mis en place des étapes de flux de travail structurées au sein des agents dynamiques :
Passer d'un assistant de page produit unique à un compagnon d'achat couvrant tout le catalogue est fondamentalement un problème de gestion d'état.
Pour évoluer sans fragiliser le système, l'architecture d'état a été entièrement repensée selon quatre principes de conception clés :
Mélanger les données utilisateur avec des données produit transitoires crée des systèmes fragiles. L'état a été refactorisé en limites distinctes :
Nous sommes passés d'un contexte produit implicite à un contexte explicite en introduisant current_product_id comme variable d'état de premier ordre. Lorsqu'un utilisateur change d'article, la mise à jour de cet identifiant unique vide et actualise automatiquement les données du catalogue, les avis, les coupons et les variables d'inventaire en aval.
Le maintien d'un tableau unique et plat conversation_history = [] générait un bruit de jetons massif et dégradait les performances du modèle. Les conversations de recherche nécessitent des fenêtres de contexte totalement différentes de celles des opérations de paiement final. La mémoire a été directement intégrée dans des threads d'agents isolés (Recherche, Inventaire, Achat, Produit) afin de minimiser la pollution inter-contexte.
La classification de l'intention seule est insuffisante lorsqu'on traite un catalogue mondial. Lorsqu'un utilisateur demande « Est-ce disponible près de chez moi ? », le système s'appuie sur une couche de résolution de référence produit nouvellement introduite pour déduire mathématiquement à quel article « ce » fait référence, évaluer si la requête est ambiguë et décider si une demande de clarification est nécessaire.
Enseignement architectural clé : L'état doit représenter les flux de travail (Recherche, Inventaire, Achat) plutôt que les domaines de données (Avis, Coupons, Produits). Concevoir l'état autour de l'intention de l'utilisateur et de la progression du flux de travail simplifie considérablement l'orchestration et réduit la complexité du suivi multi-agents.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Utilisez des workflows déterministes lorsque l'intention est claire, l'outil est connu et le résultat est prévisible, par exemple pour récupérer les spécifications de produits, retrouver des coupons ou résumer des avis. Réservez les agents ReAct pour les objectifs en plusieurs étapes où le chemin d'exécution dépend des résultats intermédiaires.
Une boucle ReAct nécessite deux appels LLM par cycle, un pour la planification et la sélection d'outils, un pour la synthèse, plus des cycles supplémentaires si l'agent doit réévaluer. Un flux déterministe ignore entièrement l'appel de planification, le réduisant à une seule invite de synthèse légère.
Un module de résolution de référence de produit évalue l'état actuel, le contexte de la conversation et la variable current_product_id pour déduire l'article auquel l'utilisateur fait référence. Si la référence est ambiguë, le système déclenche une invite de clarification au lieu de deviner.
Une seule historique de conversation linéaire accumule un contexte non pertinent à travers des flux de travail sans rapport, augmentant la charge de jetons et dégradant la concentration du modèle. Limiter la mémoire aux fils d'agents spécifiques (Recherche, Inventaire, Achat) maintient chaque fenêtre contextuelle concise et pertinente, améliorant à la fois la vitesse et la qualité des réponses.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















