



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
DeepSeek-V4-Pro est entré en phase de prévisualisation le 24 avril 2026 et a été rendu disponible au public le 13 août 2026, soit un peu moins de quatre mois plus tard. Le nom du modèle API n'a jamais changé : vous appelez toujours deepseek-v4-pro, et la version GA a simplement remplacé la version de prévisualisation.
Les spécifications, issues de la page Modèles et tarifs et de la fiche technique du modèle GA, en date de septembre 2026 :
Deux détails importent plus que le nombre de paramètres.
Premièrement, les poids sont réellement ouverts. Le point de contrôle GA est publié sous deepseek-ai/DeepSeek-V4-Pro-0813 avec une licence MIT — et non une licence communautaire sur mesure avec un plafond de revenus ou des restrictions d'utilisation. La licence MIT est ce qui se fait de plus permissif. C'est le fait unique qui justifie l'écriture de cet article.
Deuxièmement, le travail sur l'efficacité est au cœur de l'architecture. La fiche technique du modèle de prévisualisation décrit une conception d'attention hybride combinant l'attention creuse compressée et l'attention fortement compressée, et indique qu'avec un contexte de 1M de jetons, V4-Pro nécessite environ 27 % des FLOPs d'inférence par jeton et 10 % du cache KV de DeepSeek-V3.2. Le contexte long est peu coûteux à servir ici, contrairement à la génération V3, ce qui rend précisément les calculs d'auto-hébergement intéressants.
[CAPTURE D'ÉCRAN : Chat DeepSeek — le sélecteur de mode Expert qui redirige vers V4-Pro sur l'application et le web]
DeepSeek est inhabituellement direct à ce sujet. La fiche technique du modèle GA indique que le « V4-Pro-0813 est construit sur la structure du modèle DeepSeek-V4-Pro (Preview), avec un module de décodage spéculatif DSpark intégré » — le modèle de base est identique, mais le post-entraînement et le chemin de décodage diffèrent.
Les deltas publiés, de la version preview à la version GA :
Source : Fiche technique du modèle DeepSeek-V4-Pro-0813, septembre 2026.
Une mise en garde concernant l'interprétation de ces données. DeepSeek précise que les scores des agents de code ont été obtenus en utilisant son propre outil, DeepSeek Harness, en mode minimal avec un effort de raisonnement maximal, une température de 1,0 et un top_p de 0,95. Le bond de près de cinq fois sur DeepSWE est un résultat de post-entraînement mesuré avec le propre outil du fournisseur, et non une reproduction indépendante. La tendance est réelle, mais l'ampleur mérite votre propre évaluation.
Parallèlement au modèle, la version GA a apporté une prise en charge native de l'API OpenAI Responses avec une configuration Codex en un clic, ainsi qu'un contrôle de reasoning_effort à trois niveaux qui remplace le bouton binaire de réflexion.
La fiche technique du modèle GA publie un tableau comparatif face à des concurrents ouverts et fermés. Voici la partie que tout le monde reproduit, suivie de celle que la plupart des publications omettent.
Source : Fiche technique du modèle DeepSeek-V4-Pro-0813, septembre 2026.
Là où le V4-Pro domine. Le travail d'agent de type terminal et le codage axé sur la sécurité. Il surpasse Opus-4.8 sur Terminal Bench 2.1, DeepSWE, Cybergym et AutomationBench. Pour un modèle téléchargeable, c'est un résultat authentique.
Là où les modèles fermés conservent l'avantage. Les connaissances brutes et le travail complexe sur les dépôts. Opus-4.8 devance le V4-Pro de plus de huit points sur NL2Repo, ainsi que sur DSBench-Hard, Toolathlon-Verified et HLE sans outils. Fable-5 avec repli domine sur la plupart de ces mêmes points. Si votre charge de travail est dominée par des modifications complexes sur plusieurs fichiers ou par des questions nécessitant une grande étendue de connaissances, les modèles fermés de pointe restent la meilleure solution, et aucun enthousiasme pour les licences open source n'y changera rien.
Où se situent les autres modèles ouverts. Kimi K3 devance légèrement le V4-Pro sur Terminal Bench 2.1 et DeepSWE. Le titre de « meilleur modèle à poids ouverts » est contesté, pas encore tranché. L'affirmation intéressante est plus nuancée et durable : un modèle téléchargeable est désormais suffisamment proche de la pointe pour que la question du déploiement se pose réellement.
DeepSeek a introduit une facturation en période de pointe et hors pointe avec la version GA, effective depuis le 16 août 2026 à 16h00 UTC. Les tarifs hors pointe représentent exactement la moitié des tarifs de pointe. Les heures de pointe sont de 01h00 à 04h00 et de 06h00 à 10h00 UTC, du lundi au vendredi, hors jours fériés chinois ; tout le reste, week-ends inclus, est considéré comme hors pointe.
Source : Modèles et tarification DeepSeek, septembre 2026.
Trois points à noter. Le prix en cas de succès de cache est 30 fois inférieur à celui en cas d'échec, la structure du prompt est donc cruciale pour tout système utilisant un prompt stable. La distinction pointe/hors pointe est un levier de planification, pas une remise — les tâches par lots déplacées hors pointe voient leur coût divisé par deux. Enfin, DeepSeek a augmenté ses prix lors du passage en GA par rapport à la version preview, bien que les tarifs publiés de la preview soient à [VÉRIFIER] — ils ne figurent plus sur la page de tarification et nous ne les reprendrons pas à partir de sources secondaires.
Une note opérationnelle : la limite de concurrence de l'API pour deepseek-v4-pro est de 500. DeepSeek a également confirmé le 10 septembre 2026 qu'il continuerait à assurer le service de l'API V4 Pro au-delà du 14 septembre 2026 sans changement de facturation (changement journal).
[CAPTURE D'ÉCRAN : Plateforme DeepSeek — tableau de bord d'utilisation montrant la consommation de jetons en période de pointe par rapport aux heures creuses]
Quatre modes de défaillance reviennent régulièrement avec les modèles de pointe à poids ouverts, et le V4-Pro présente les quatre.
La facture de l'auto-hébergement concerne un nœud, pas un GPU. La commande de service de référence de DeepSeek dans la fiche du modèle cible une configuration unique à 4 nœuds GB300 via vLLM, avec cache KV FP8, parallélisme d'experts et décodage spéculatif DSpark activés. Un MoE de 1,7 billion de paramètres n'est pas quelque chose que l'on lance sur un A100 disponible par hasard. Les poids ouverts vous donnent l' option d'auto-hébergement ; le fait que le calcul soit plus rentable que 1,98 $ par million de jetons de sortie dépend entièrement de votre taux d'utilisation. En dessous d'une charge de régime permanent assez élevée, l'API est plus avantageuse.
Il n'y a pas de modèle de chat. La version GA ne contient aucun modèle de chat Jinja. DeepSeek fournit à la place un dossier d'encodage contenant des scripts Python pour transformer les messages au format OpenAI en entrées de modèle et pour analyser la sortie en retour. Tout élément de votre pile technique qui suppose l'utilisation de tokenizer.apply_chat_template nécessitera des ajustements.
Le V4-Pro n'a pas de vision. La vision est réservée à la gamme Flash, pas Pro. Une stratégie à modèle unique supposant la multimodalité échoue ici, ce qui signifie que vous devrez router vos requêtes vers au moins deux modèles, que vous l'ayez prévu ou non.
La résidence des données et l'API sont désormais des décisions distinctes. Envoyer des prompts à api.deepseek.com est une question de flux de données différente de l'exécution des mêmes poids au sein de votre propre VPC. Les équipes confondent souvent « nous pouvons utiliser DeepSeek V4 » avec « nous pouvons appeler l'API DeepSeek », et ces deux options reçoivent des réponses différentes lors d'un même examen de sécurité. Votre propre service juridique décide de ce qui est acceptable ; l'essentiel est simplement que les poids ouverts rendent les deux voies techniquement possibles.
Un modèle de pointe à poids ouverts ne modifie votre modèle économique que si vous pouvez réellement l'héberger quelque part. C'est là qu'intervient TrueFoundry.
Auto-hébergez-le dans votre propre VPC. Le Passerelle IA enregistre modèles open-weight auto-hébergés aux côtés des fournisseurs hébergés : vous déployez V4-Pro sur votre propre cluster Kubernetes avec vLLM ou SGLang, vous pointez la passerelle vers le point de terminaison, et il apparaît dans le catalogue de modèles avec les mêmes fonctionnalités de routage, de limitation de débit, de suivi des coûts et d'observabilité que n'importe quel modèle API (documentation sur les modèles auto-hébergés). Comme vLLM et SGLang servent tous deux une API compatible OpenAI par défaut, la passerelle n'a pas besoin d'adaptateur spécifique pour DeepSeek.
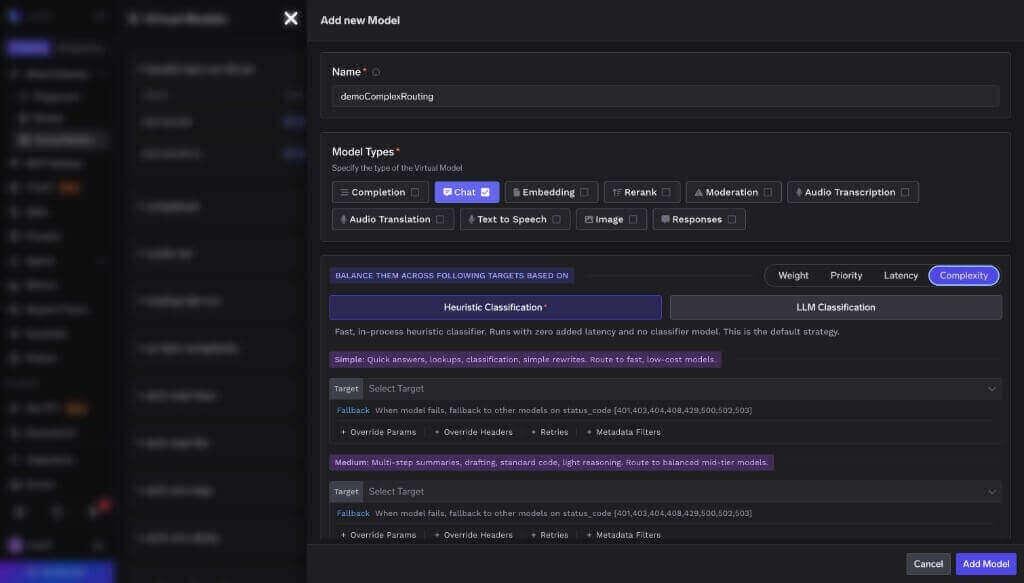
Ou appelez l'API tout en gardant vos options ouvertes. Si vous n'êtes pas prêt pour l'auto-hébergement, acheminez vos requêtes vers l'API de DeepSeek via la passerelle et conservez le même chemin d'appel que celui que vous utiliseriez plus tard pour un déploiement auto-hébergé. Passer du point de terminaison hébergé à votre propre cluster devient une simple modification de configuration plutôt qu'une réécriture de votre application.
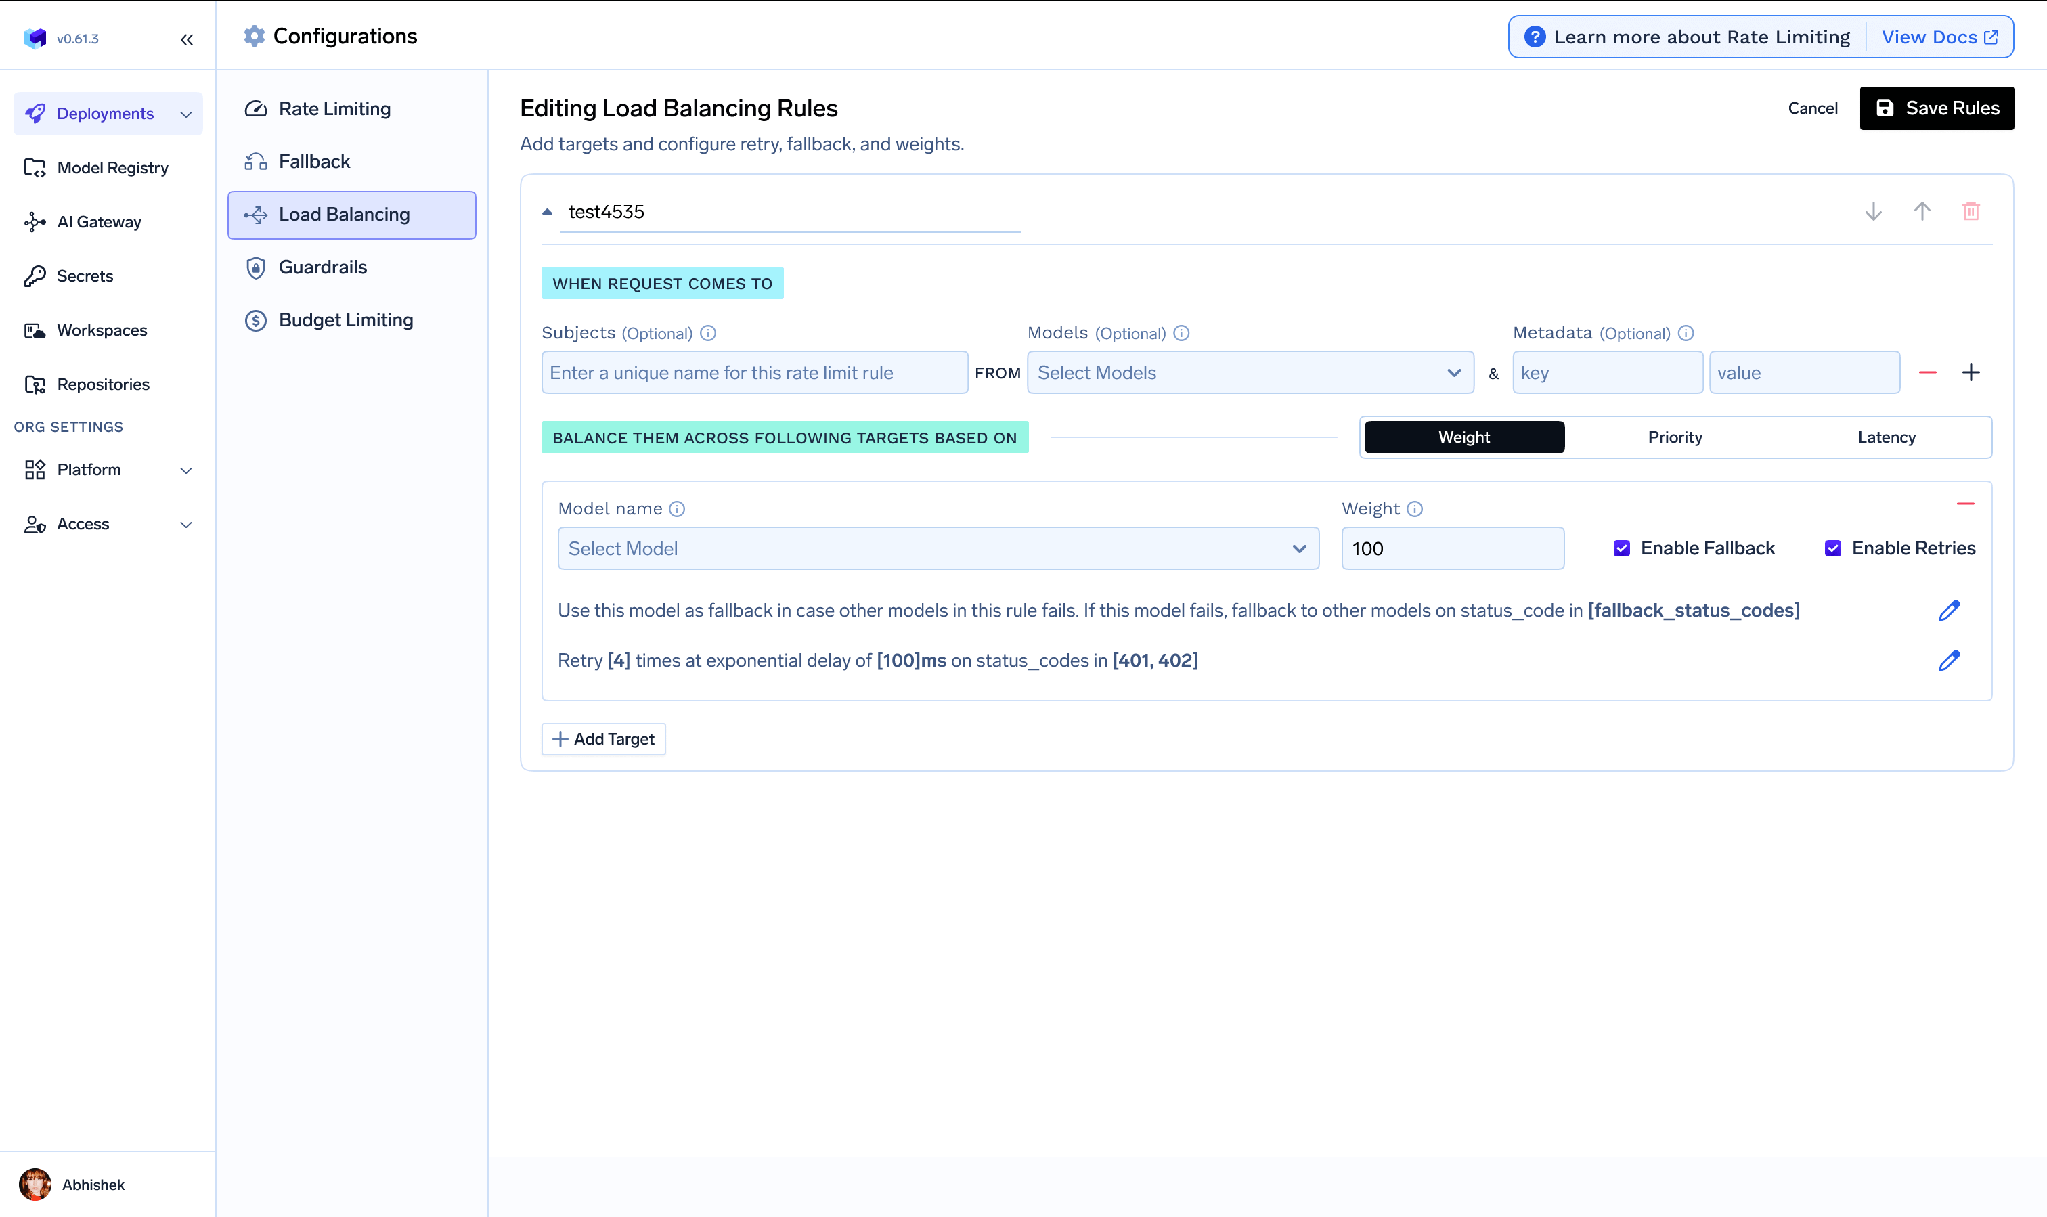
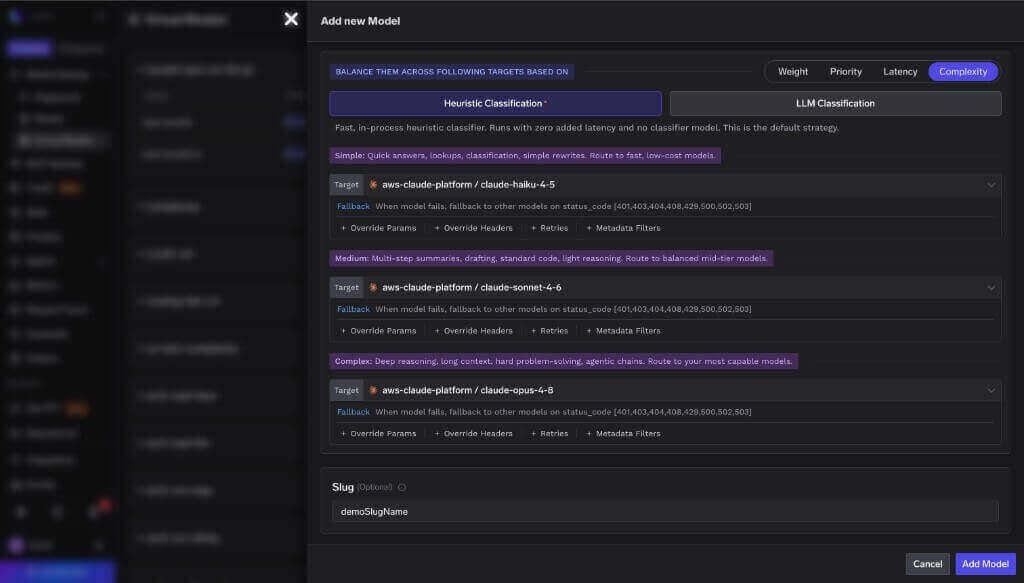
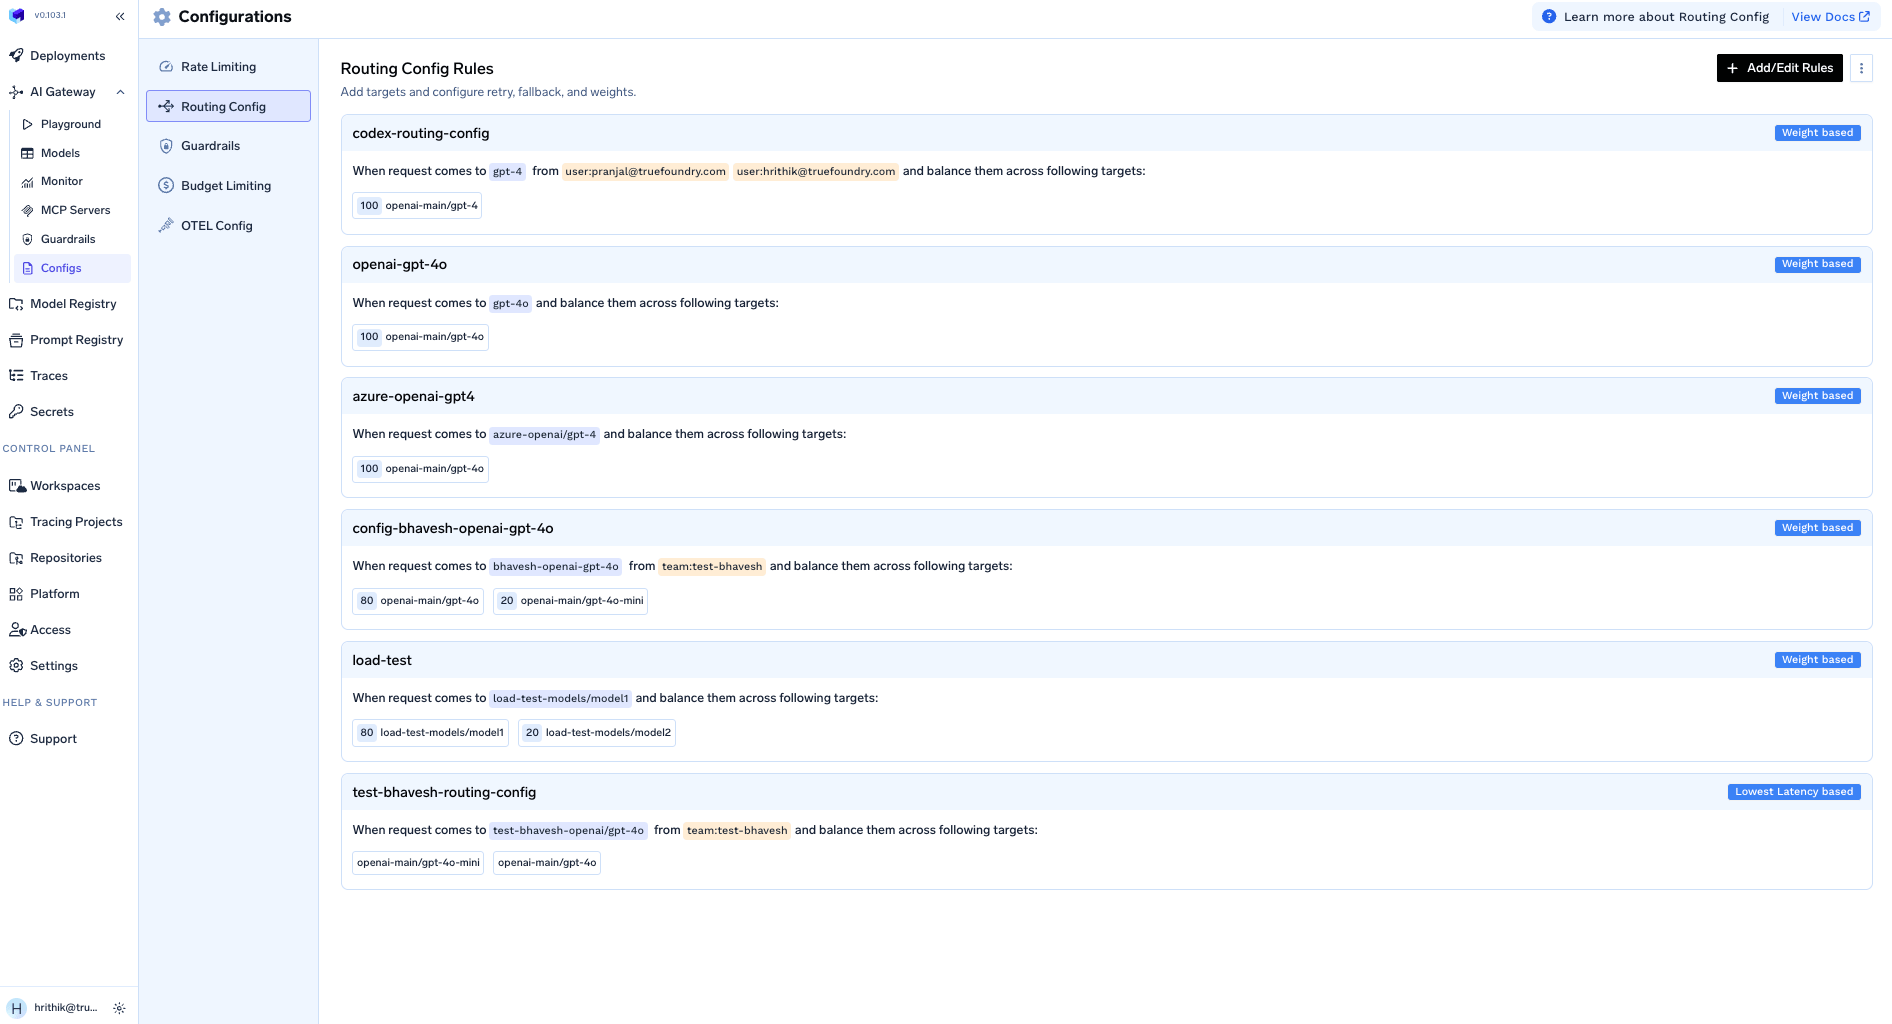
Acheminez selon la complexité, pas par habitude. Le tableau de référence ci-dessus plaide en faveur d'une flotte mixte plutôt que d'une migration, et le routage basé sur le coût et la qualité est la méthode pour y parvenir. Confiez les tâches complexes de dépôt à Opus-4.8, les exécutions d'agents de type terminal à V4-Pro, et la classification ou l'extraction à des modèles plus économiques. Dans le propre benchmark de routage automatique de TrueFoundry portant sur 550 prompts, la hiérarchisation des requêtes a permis de réduire les coûts de 69 % tout en conservant 98 % de la qualité de référence, avec une latence moyenne passant de 7,6 s à 4,0 s ; sur un trafic représentatif de la production, la réduction a atteint 80 %.
Appliquez les mêmes garde-fous, quel que soit le choix. Un modèle auto-hébergé n'hérite pas de la pile de sécurité d'un fournisseur. Les garde-fous au niveau de la passerelle s'exécutent sur le chemin de la requête et de la réponse, que le modèle soit le point de terminaison de DeepSeek ou votre propre pod.
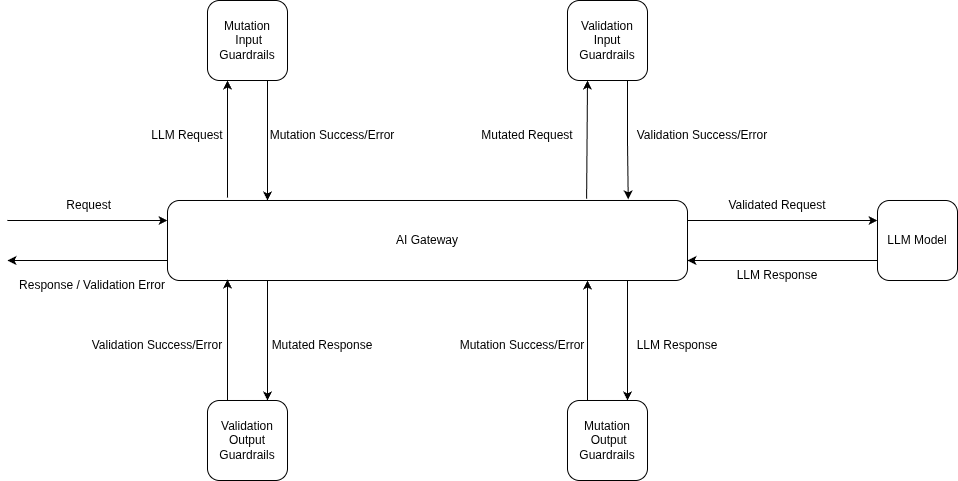
Mesurez avant de vous engager. Le suivi du coût et de la latence par requête et par équipe est le seul moyen de déterminer si la tarification hors pointe de V4-Pro ou un nœud auto-hébergé surpasse réellement ce que vous utilisez aujourd'hui.
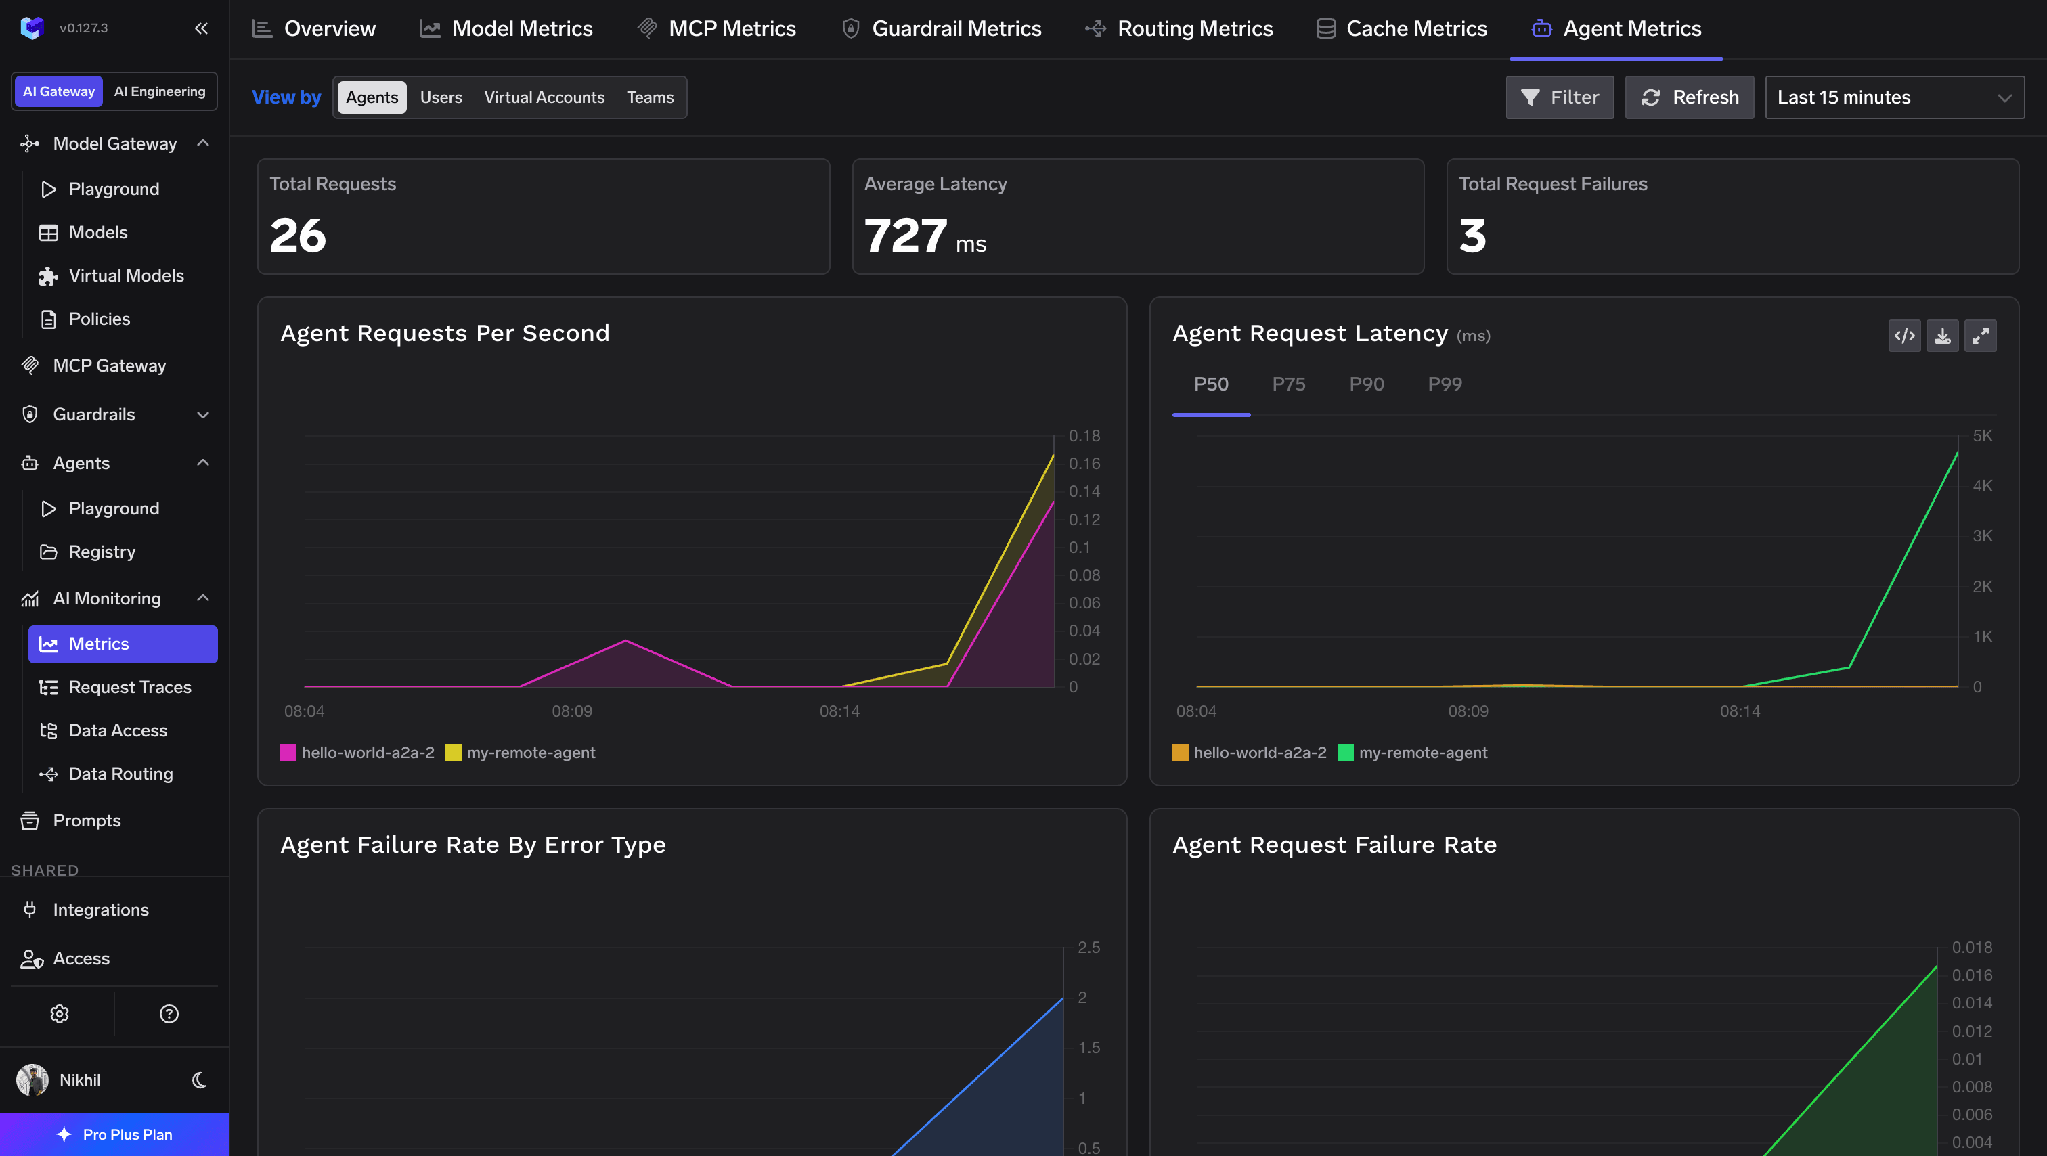
En résumé, à compter de septembre 2026 :
La sortie en disponibilité générale de DeepSeek V4-Pro ne se résume pas à une simple histoire de benchmarks. Selon les chiffres publiés par DeepSeek lui-même, il surpasse Opus-4.8 sur certaines tâches d'agent, mais s'incline sur des travaux de référentiel plus complexes et sur les connaissances générales, tandis que Kimi K3 conteste sa position de leader parmi les modèles ouverts. En tant qu'entrée dans un classement, c'est un bon modèle aux résultats inégaux.
En tant que licence, c'est une tout autre affaire. Un modèle avec une fenêtre de contexte d'un million de jetons, suffisamment proche de la pointe technologique pour constituer une réelle alternative et publié sous licence MIT, transforme la question du déploiement : elle n'est plus théorique. Vous pouvez l'exécuter dans votre propre VPC, conserver vos prompts sur une infrastructure que vous contrôlez et payer pour la puissance de calcul plutôt que pour les jetons — à condition que votre utilisation justifie un nœud dédié et que vous soyez prêt à gérer la pile de service. Pour la plupart des équipes aujourd'hui, ce n'est pas le cas, et la stratégie la plus pertinente consiste à passer par l'API tout en gardant la possibilité d'un auto-hébergement.
Voici la conclusion en toute franchise : tout dépend de ce que vous souhaitez maîtriser. Si vous préférez qu'un tiers exécute le modèle, les modèles fermés de pointe restent la solution la plus rapide et la plus performante pour les tâches les plus complexes. Si vous souhaitez avoir la possibilité d'intégrer le modèle au sein de votre propre périmètre sans réécrire votre application, un modèle à poids ouverts derrière une passerelle est le moyen le plus économique d'acquérir cette flexibilité — et il vaut mieux l'acquérir avant d'en avoir besoin.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




DeepSeek V4 est la famille de modèles mixture-of-experts de DeepSeek. La préversion de V4, couvrant V4-Pro et V4-Flash, a été lancée le 24 avril 2026. DeepSeek-V4-Pro est passé en disponibilité générale sous le nom DeepSeek-V4-Pro-0813 le 13 août 2026.
Les poids et le dépôt sont publiés sous licence MIT sur Hugging Face, à l'adresse deepseek-ai/DeepSeek-V4-Pro-0813. Cela couvre les poids et le code, pas les données d'entraînement : « poids ouverts » est donc un terme plus précis qu'« open source ».
En septembre 2026 : 0,66 $ par million de tokens d'entrée en heures creuses et 1,32 $ en heures pleines en cas d'absence de cache, 0,022 $ et 0,044 $ en cas de succès de cache, et 1,98 $ et 3,96 $ par million de tokens de sortie. Les heures pleines vont de 01h00 à 04h00 et de 06h00 à 10h00 UTC en semaine.
Oui, et DeepSeek publie des recettes de déploiement pour vLLM et SGLang. Soyez réaliste quant à l'échelle : c'est un modèle de 1 700 milliards de paramètres, et la configuration de référence de la model card est un nœud GB300 multi-GPU.
L'AI Gateway de TrueFoundry ajoute environ 3 à 4 ms et soutient plus de 350 RPS sur 1 vCPU, ce qui est négligeable face à des temps de génération de plusieurs secondes.
Non, et la dispersion des benchmarks ci-dessus est l'argument qui s'y oppose. Router par type de tâche entre modèles ouverts et fermés est généralement moins coûteux et plus efficace que de standardiser sur un seul.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















