



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




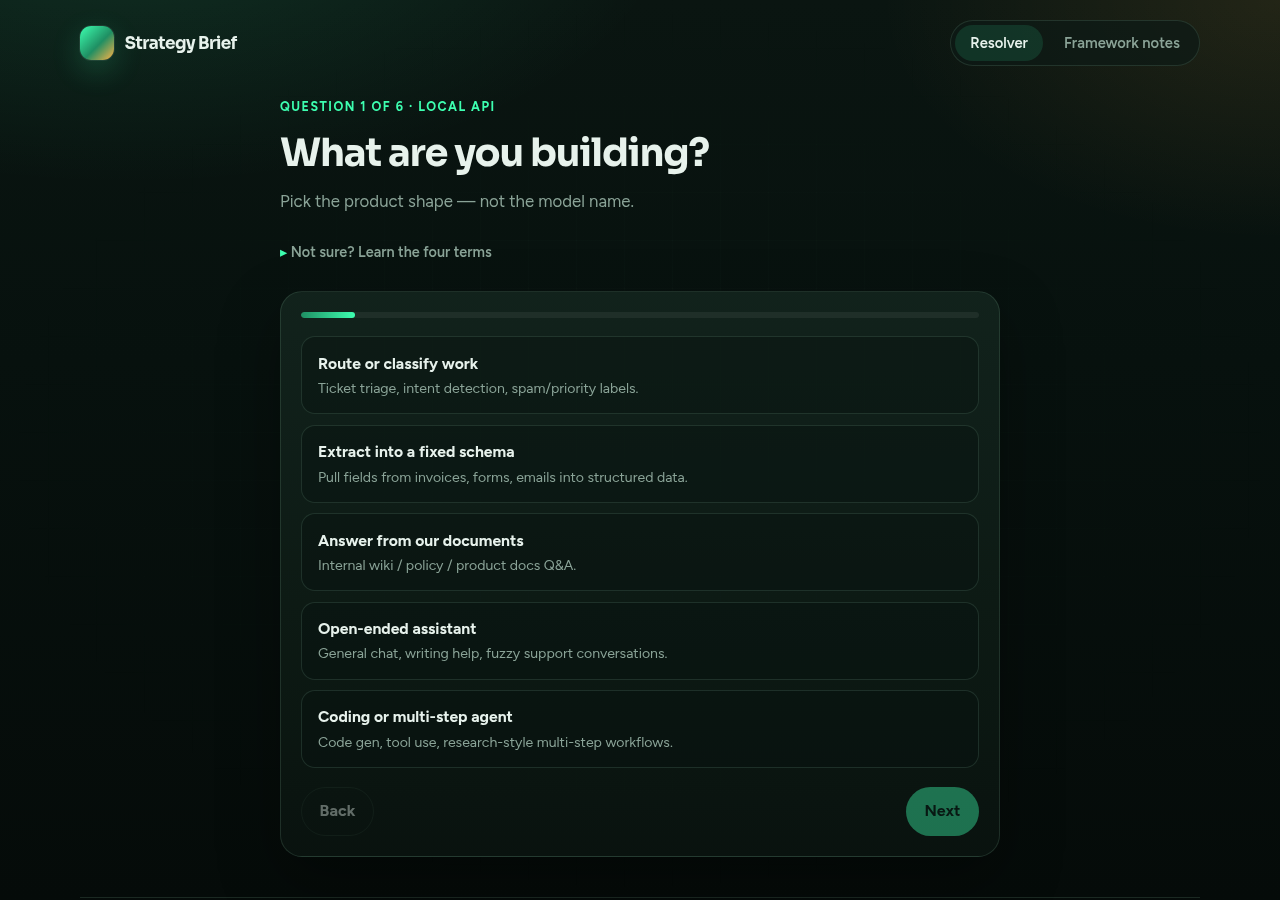
Lorsque la tâche est étroite et répétitive, que vous disposez d'environ 1 000 exemples étiquetés propres ou plus, qu'un responsable est désigné pour les évaluations et les redéploiements, que le volume est suffisant pour que le coût unitaire ou la latence posent problème, et qu'il existe une référence avec prompts que vous pouvez dépasser sur un jeu de données mis de côté. S'il manque l'un de ces éléments, continuez avec les prompts (et ajoutez du RAG si la tâche relève de la connaissance).
Le fine-tuning modifie les poids du modèle pour obtenir un comportement spécialisé. Le RAG récupère des documents de confiance au moment de la question afin que les réponses restent fondées et à jour. L'hébergement privé désigne l'endroit où s'exécute l'inférence. Vous pouvez les combiner dans n'importe quel ordre ; choisir un hébergement en VPC n'implique pas que vous deviez faire du fine-tuning.
Généralement pour l'une de ces raisons : pas d'évaluation sur des données mises de côté, des étiquettes qui étaient des tickets bruts, une tâche ouverte qui n'aurait pas dû être spécialisée, ou personne pour empêcher le modèle spécialisé de dériver. Appliquer Specialize sans tableau de score, c'est avancer à l'aveugle.
Faites passer le trafic par une passerelle d'IA. Définissez des modèles par défaut. Restreignez l'accès aux modèles premium. Rendez visibles les dépenses par équipe. L'AI Gateway de TrueFoundry donne aux responsables de l'ingénierie une visibilité sur l'utilisation et les coûts de plus de 1 000 LLM derrière une seule API compatible OpenAI, afin que les choix de modèles ne s'accumulent pas en mauvaises surprises de facturation pendant que vous validez encore le produit.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















