August 26, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 10, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Lorsque OpenAI a lancé GPT-5.6 le 9 juillet en trois niveaux (Sol, Terra et Luna), l'attention s'est principalement portée sur la hiérarchie des niveaux elle-même. Le changement plus discret est pourtant plus intéressant : les écritures en cache sont désormais facturées pour la première fois, à 1,25 fois le tarif d'entrée normal, tandis que les lectures en cache conservent leur remise existante de 90 %. La mise en cache était auparavant un avantage quasi gratuit. Elle a désormais un coût, ce qui signifie qu'il existe un seuil au-delà duquel elle n'est plus rentable.
Où se situe donc ce seuil ? Nous avons élaboré un petit modèle de coût pour le déterminer, pour les trois niveaux.
Pour une charge de travail d'agent classique, vous disposez d'un vaste contexte partagé (invite système, schémas d'outils, contexte de dépôt) réutilisé lors de nombreux appels, ainsi qu'une petite partie unique par requête. Le seuil de rentabilité dépend de trois chiffres : le prix d'entrée complet, le prix d'écriture en cache et le prix de lecture en cache. En résolvant l'équation pour le mélange écriture/lecture où la mise en cache coûte autant que l'absence de mise en cache, on obtient un ratio unique.
Voici ce que nous n'avions pas prévu : ce ratio est identique pour Sol, Terra et Luna. Les écritures peuvent représenter jusqu'à 78,3 % des requêtes avant que la mise en cache ne cesse d'être rentable, et ce chiffre ne varie pas en fonction de la taille du contexte, du volume de requêtes ou du niveau utilisé. OpenAI a appliqué les mêmes multiplicateurs de 1,25x/0,10x de manière uniforme à toute la gamme ; le choix du niveau modifie donc vos coûts absolus, mais pas votre stratégie de mise en cache.
La taille du contexte ne modifie pas le seuil de rentabilité, mais elle change l'enjeu. En appliquant le même ratio écriture/lecture à trois tailles de contexte différentes :
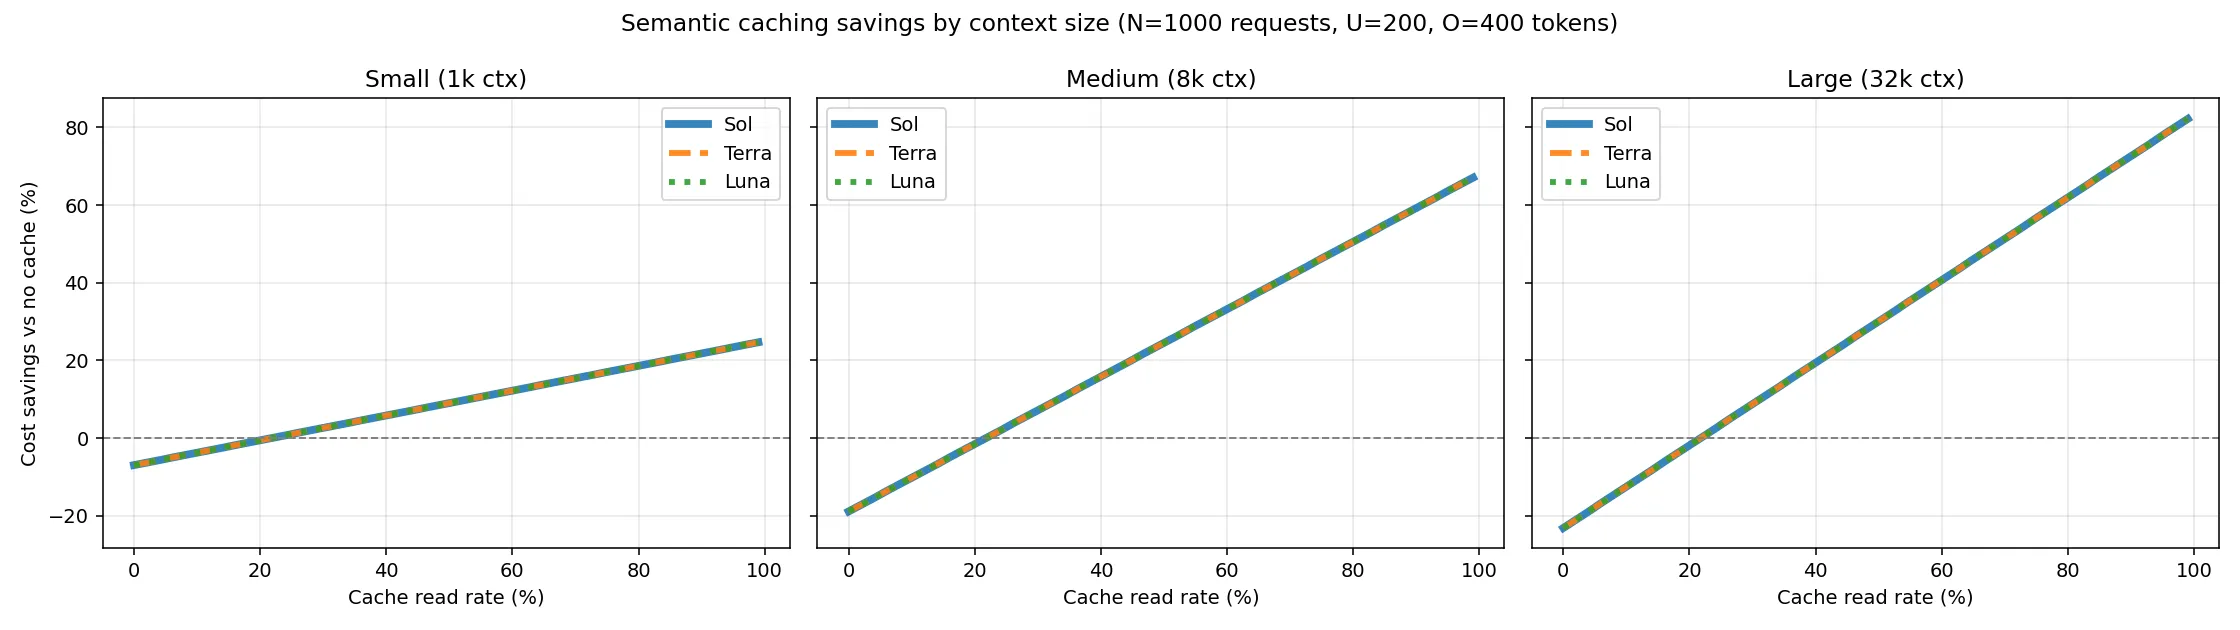
Avec un petit contexte partagé (1 000 jetons), les économies sont réelles mais modestes, même avec des taux de répétition élevés. Avec un contexte important (32 000 jetons, pensez aux longues invites système et aux gros schémas d'outils), le même taux de répétition génère des économies nettement plus importantes, simplement parce qu'une plus grande partie est remise à chaque lecture.
Un taux de répétition fixe et propre est un bon exemple pédagogique, mais le trafic réel des agents n'est pas aussi ordonné. La durée des sessions (combien d'appels partagent un contexte mis en cache avant qu'il ne change ou n'expire) varie considérablement. Nous avons modélisé la durée des sessions avec une distribution log-normale (moyenne de 25 requêtes par session, avec une longue traîne) et obtenu une part d'écriture simulée d'environ 3 %, avec une session médiane de 23 requêtes et une session au 90e percentile de 58. On est loin du seuil de rentabilité de 78,3 %. Dans cette simulation, la mise en cache s'est imposée confortablement : les économies variaient de 24 % sur un petit contexte de 1 000 jetons à près de 80 % sur un contexte de 32 000 jetons.
Le seul cas d'échec à surveiller : un contexte qui change rapidement. Si le contexte partagé de votre agent change toutes les quelques requêtes au lieu de persister sur des dizaines d'entre elles, vous risquez de vous retrouver du mauvais côté de ce seuil, et la mise en cache devient un coût plutôt qu'une économie.
Ne jugez pas la tarification du cache de GPT-5.6 uniquement sur la base du prix catalogue. Modélisez votre propre mélange écriture/lecture par rapport au seuil de 78,3 %. Si le contexte de votre agent reste stable pendant des dizaines de requêtes à la fois, la mise en cache reste très probablement une solution avantageuse avec la nouvelle tarification, quel que soit le niveau que vous utilisez.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception