



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
GPT-6 Astra est arrivé le 3 septembre 2026. La chaîne API est gpt-6-astra — pas d'instantané daté, pas d'alias distinct ; la page du modèle indique gpt-6-astra à la fois comme instantané et comme alias.
Les spécifications, selon la documentation du modèle d'OpenAI :
Trois points dans les petites lignes comptent plus que l'annonce principale.
Premièrement, reasoning.effort n'accepte plus none. C'était le cas pour GPT-5.6 Sol. Si vous avez un chemin rapide et économique configuré sur none, il ne sera pas compatible.
Deuxièmement, temperature, top_p et logprobs ont disparu. Le journal des modifications indique qu'Astra « ne prend pas en charge les valeurs personnalisées de température ou de top_p, ni les probabilités logarithmiques ». Tout élément de votre pile technique définissant des paramètres d'échantillonnage doit être audité avant toute migration.
Troisièmement, l'appel d'outils nécessite l'API Responses. Si vous appelez des outils via Chat Completions aujourd'hui, il s'agit d'une migration, pas d'un simple changement de modèle.
[CAPTURE D'ÉCRAN : Plateforme OpenAI — la page du modèle gpt-6-astra affichant la fenêtre de contexte, la sortie maximale et la tarification par jeton]
La fenêtre de contexte et la limite de sortie n'ont pas bougé. Le prix, si.
Sources : documentation du modèle GPT-6 Astra, documentation du modèle GPT-5.6 Sol, septembre 2026. Notez qu'OpenAI décrit les tarifs de GPT-5.6 Sol comme une tarification promotionnelle disponible au moins jusqu'au 21 novembre 2026 ; le ratio pourrait donc ne plus être valable après cette date.
Chaque tarif a évolué selon exactement le même facteur. Cela s'avère important pour la question du cache abordée ci-dessous.
Les modes Batch et Flex restent à 50 % du tarif Standard. Le mode Fast, qui, selon OpenAI, offre une vitesse jusqu'à deux fois supérieure au traitement Standard, est facturé au double des tarifs en vigueur ; ainsi, le mode Fast pour Astra coûte 20 $ en entrée et 100 $ en sortie.
OpenAI publie un vaste tableau comparatif dans son article de lancement. Voici la partie qui mérite d'être reproduite, suivie de celle que la plupart des médias omettent.
Source : Article de lancement de GPT-6 Astra, septembre 2026. Les scores correspondent au maximum atteint quel que soit l'effort de raisonnement.
Là où Astra domine clairement. Travail d'agent sur le long terme. Terminal-Bench 4.0 progresse de plus de vingt points par rapport à Sol. Terminal-Bench Science triple presque son score. AutomationBench fait plus que doubler. La récupération sur contexte long (512K-1M) passe de 73,8 % à 96,3 %. Ce sont les charges de travail pour lesquelles le modèle a été conçu, et l'écart est flagrant.
Là où l'écart devient négligeable. Connaissances et raisonnement en une seule étape. GPQA Diamond passe de 94,6 % à 96,0 %. DeepSWE passe de 72,7 % à 74,1 %. Si votre trafic consiste en des questions nécessitant des réponses plutôt que des tâches nécessitant des étapes, vous payez 2,5 fois plus cher pour gagner environ un point.
Là où Astra ne gagne pas. Sur les deux indices composites tiers qu'OpenAI a choisi d'inclure, Astra n'arrive pas en tête. L'Artificial Analysis Intelligence Index place Claude Fable 5.1 à 65,7 contre 61,2 pour Astra. Le Coding Agent Index place Claude Opus 5 à 68,1 contre 67,0 pour Astra. OpenAI a publié ces deux chiffres, ce qui est tout à son honneur, et ils constituent un contrepoids honnête à la supériorité constatée sur les tâches d'agent.
Un élément qui complexifie la question du prix. Les estimations de coût par tâche d'OpenAI sont parfois inférieures à celles de Sol malgré des tarifs 2,5 fois plus élevés, car Astra termine les tâches avec moins de jetons. L'article de lancement annonce un coût API estimé par tâche environ 9 % inférieur sur Terminal-Bench 4.0 par rapport à Sol, environ 27 % inférieur sur Terminal-Bench Science avec un paramètre de coût réduit, et environ 43 % inférieur sur BenchCAD. Il s'agit des propres estimations d'OpenAI dans des configurations spécifiques, et non de reproductions indépendantes ; elles ne seront donc pas généralisables à votre propre trafic. Cependant, cela signifie que « 2,5 fois plus cher » n'est pas le résumé approprié pour le travail d'agent. Mesurez les jetons par tâche accomplie, pas le prix par jeton.
TrueFoundry a effectué le calcul du seuil de rentabilité du cache sur GPT-5.6 lorsque les écritures en cache sont devenues facturables pour la première fois. La même question se pose ici, et la réponse est plus intéressante qu'il n'y paraît.
Les multiplicateurs de cache d'Astra sont identiques à ceux de GPT-5.6. La documentation du modèle indique que les écritures en cache sont facturées à 1,25 fois le tarif d'entrée sans cache, et le tarif publié pour les entrées en cache de 1,00 $ par rapport à un tarif d'entrée de 10,00 $ représente exactement 0,10 fois. Donc :
Soit w la part des requêtes sur un préfixe partagé qui sont des écritures en cache plutôt que des lectures. Le seuil de rentabilité du cache est atteint lorsque :
1,25w + 0,10(1 - w) = 1
1,15w = 0,90
w = 78,3 %
Le seuil de rentabilité est de 78,3 %, inchangé par rapport à GPT-5.6. P s'annule, c'est pourquoi l'augmentation de prix de 2,5x ne change rien. Le cache cesse d'être rentable uniquement lorsque plus de 78 % environ de vos requêtes sur un préfixe donné sont des écritures — c'est-à-dire lorsque votre contexte partagé survit à moins de 1,3 requête en moyenne avant d'être modifié ou d'expirer. Presque aucune charge de travail d'agent réel ne se situe dans cette zone.
Ce que l'augmentation de prix change, c'est l'enjeu financier. Prenons un préfixe partagé de 32 000 jetons réutilisé sur une session de 25 requêtes — une écriture, vingt-quatre lectures :
Le pourcentage est identique. Les montants en dollars sont 2,5 fois plus élevés. L'utilisation du cache a toujours été pertinente ; avec Astra, ne pas l'utiliser coûte deux fois et demie plus cher.
Le mode de défaillance reste également inchangé : un contexte qui change trop rapidement. Si votre agent reconstruit son prompt système ou son schéma d'outils toutes les quelques itérations, vous payez 12,50 $ par million pour écrire un cache que vous lisez à peine. C'est désormais une erreur qui coûte 12,50 $ au lieu de 5,00 $.
La fenêtre de contexte annoncée pour GPT-6 est de 1 050 000 jetons. La facturation n'est pas linéaire sur cette plage.
Extrait de la documentation du modèle : « Les prompts de plus de 272 000 jetons en entrée sont facturés au double des tarifs d'entrée et de cache, et à 1,5 fois le tarif de sortie pour l'ensemble de la requête. »
Lisez ceci attentivement. C'est pour l'ensemble de la requête, et non pour le dépassement au-delà de 272 000. Franchir cette limite ne vous coûte pas le double sur les jetons supplémentaires ; cela vous coûte le double sur la totalité des jetons.
Une augmentation de 0,7 % de la taille du prompt entraîne une hausse de 101 % de la facture d'entrée. Les lectures en cache doublent également, passant de 1,00 $ à 2,00 $ par million, et la sortie passe de 50,00 $ à 75,00 $. GPT-5.6 Sol applique la même règle, ce n'est donc pas nouveau — mais aux tarifs d'Astra, le saut est 2,5 fois plus important.
La conséquence pratique : si vos prompts avoisinent les 272 000 jetons, l'optimisation des coûts la plus efficace à votre disposition est de les réduire en dessous de ce seuil. Supprimer 5 000 jetons d'un prompt de 275 000 jetons est plus rentable que n'importe quel changement de routage.
[CAPTURE D'ÉCRAN : Plateforme OpenAI — tableau de bord d'utilisation affichant les dépenses en jetons d'entrée, d'entrée en cache et de sortie par modèle]
Quatre types de défaillances reviennent systématiquement dans les premières semaines suivant le lancement d'un modèle de pointe, et Astra les présente tous les quatre.
Tout est redirigé vers le nouveau modèle. La dépense la plus lourde pour une équipe après un lancement est de définir le nouveau modèle par défaut pour tout. À 10 $ pour l'entrée et 50 $ pour la sortie, un appel de classification qu'un modèle économique traite correctement coûte désormais 2,5 fois plus cher que le mois dernier, sans aucun gain de qualité. L'écart de performance observé ci-dessus plaide en faveur d'une flotte mixte, et non d'une migration totale.
La migration ne se résume pas à un simple remplacement de chaîne de caractères. Pas d'effort de raisonnement, pas de température, pas de top_p, pas de logprobs, et un appel d'outils qui nécessite l'API Responses. Le code qui fonctionnait avec gpt-5.6-sol peut échouer avec gpt-6-astra de manières qui ne deviennent évidentes qu'en production.
La surveillance des désalignements peut interrompre votre requête. OpenAI effectue des vérifications asynchrones sur le travail des agents dans les requêtes prises en charge par l'API Responses. L'article de lancement est explicite sur les conséquences : dans ChatGPT ou Codex, il peut vous être demandé de valider une action, mais « dans l'API, la tâche s'arrêtera ». OpenAI reconnaît que ces vérifications « peuvent parfois interrompre un travail légitime ». Il s'agit d'une nouvelle caractéristique de fiabilité à prendre en compte dès la conception, et non d'une simple note de bas de page.
Personne ne connaît le coût réel avant de recevoir la facture. Le prix par jeton ne signifie pas grand-chose lorsque le modèle utilise un nombre de jetons différent selon la tâche. Sans attribution des coûts par requête et par équipe, il est impossible de répondre à la question : « Astra est-il plus ou moins coûteux pour nous ? »
Un modèle de pointe plus coûteux ne rend pas l'utilisation d'une passerelle moins pertinente. Au contraire, elle la renforce, car chaque décision de routage vaut désormais 2,5 fois plus cher.
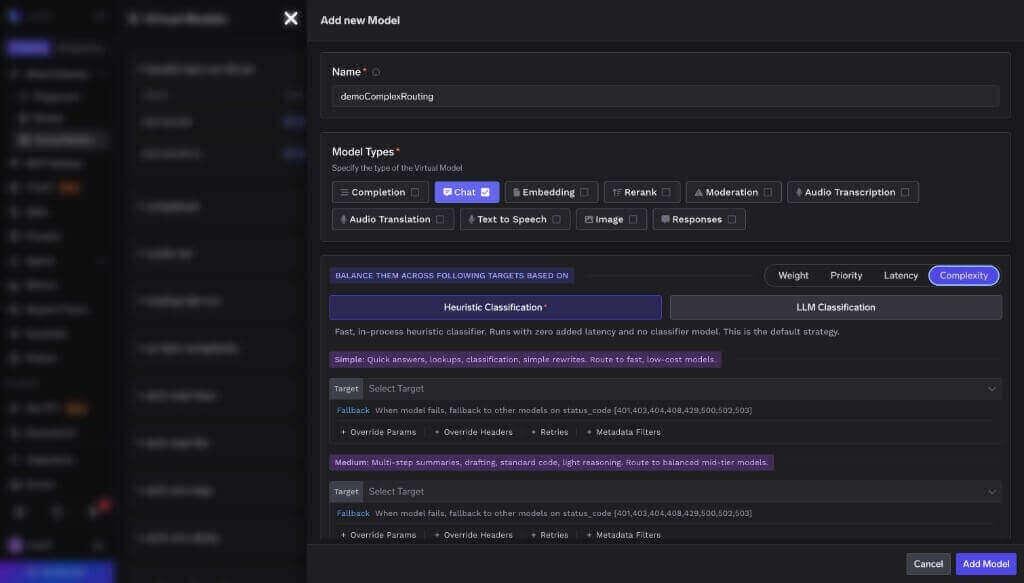
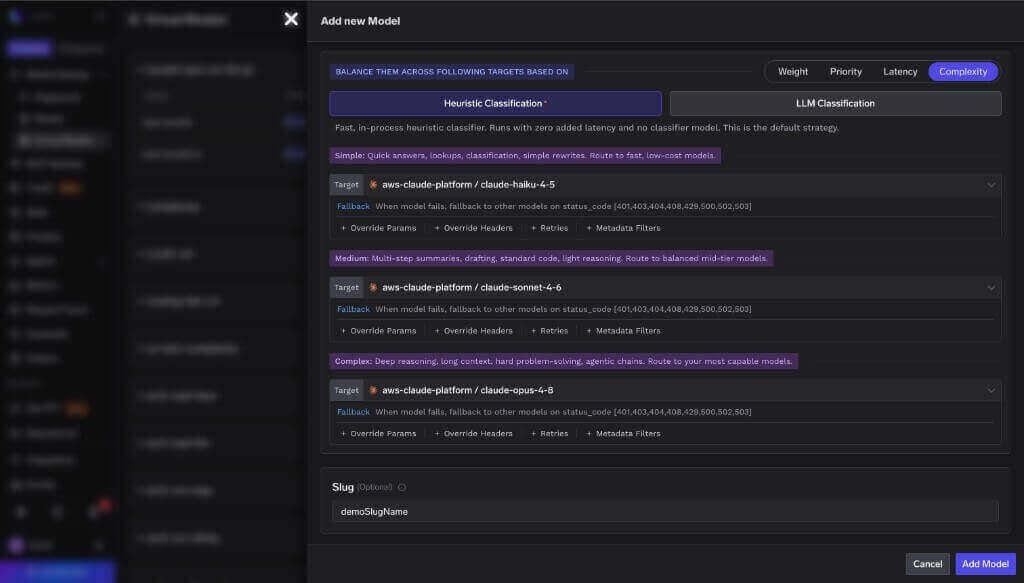
Routez selon la complexité, pas par habitude. La Passerelle IA classifie les requêtes entrantes et envoie chacune vers le niveau approprié, afin que les tâches complexes des agents atteignent Astra, tandis que l'extraction, la classification et la synthèse ne le font pas. Dans le benchmark d'Auto Routing de TrueFoundry portant sur 550 prompts, la hiérarchisation a réduit les coûts de 69 % tout en conservant 98 % de qualité de référence, avec une latence moyenne passant de 7,6 s à 4,0 s. Sur un trafic représentatif de la production, la réduction a atteint 80 %. Ces pourcentages appliqués à des tarifs de 10 $/50 $ ont une valeur nettement supérieure à ce qu'ils représentaient à 4 $/20 $.
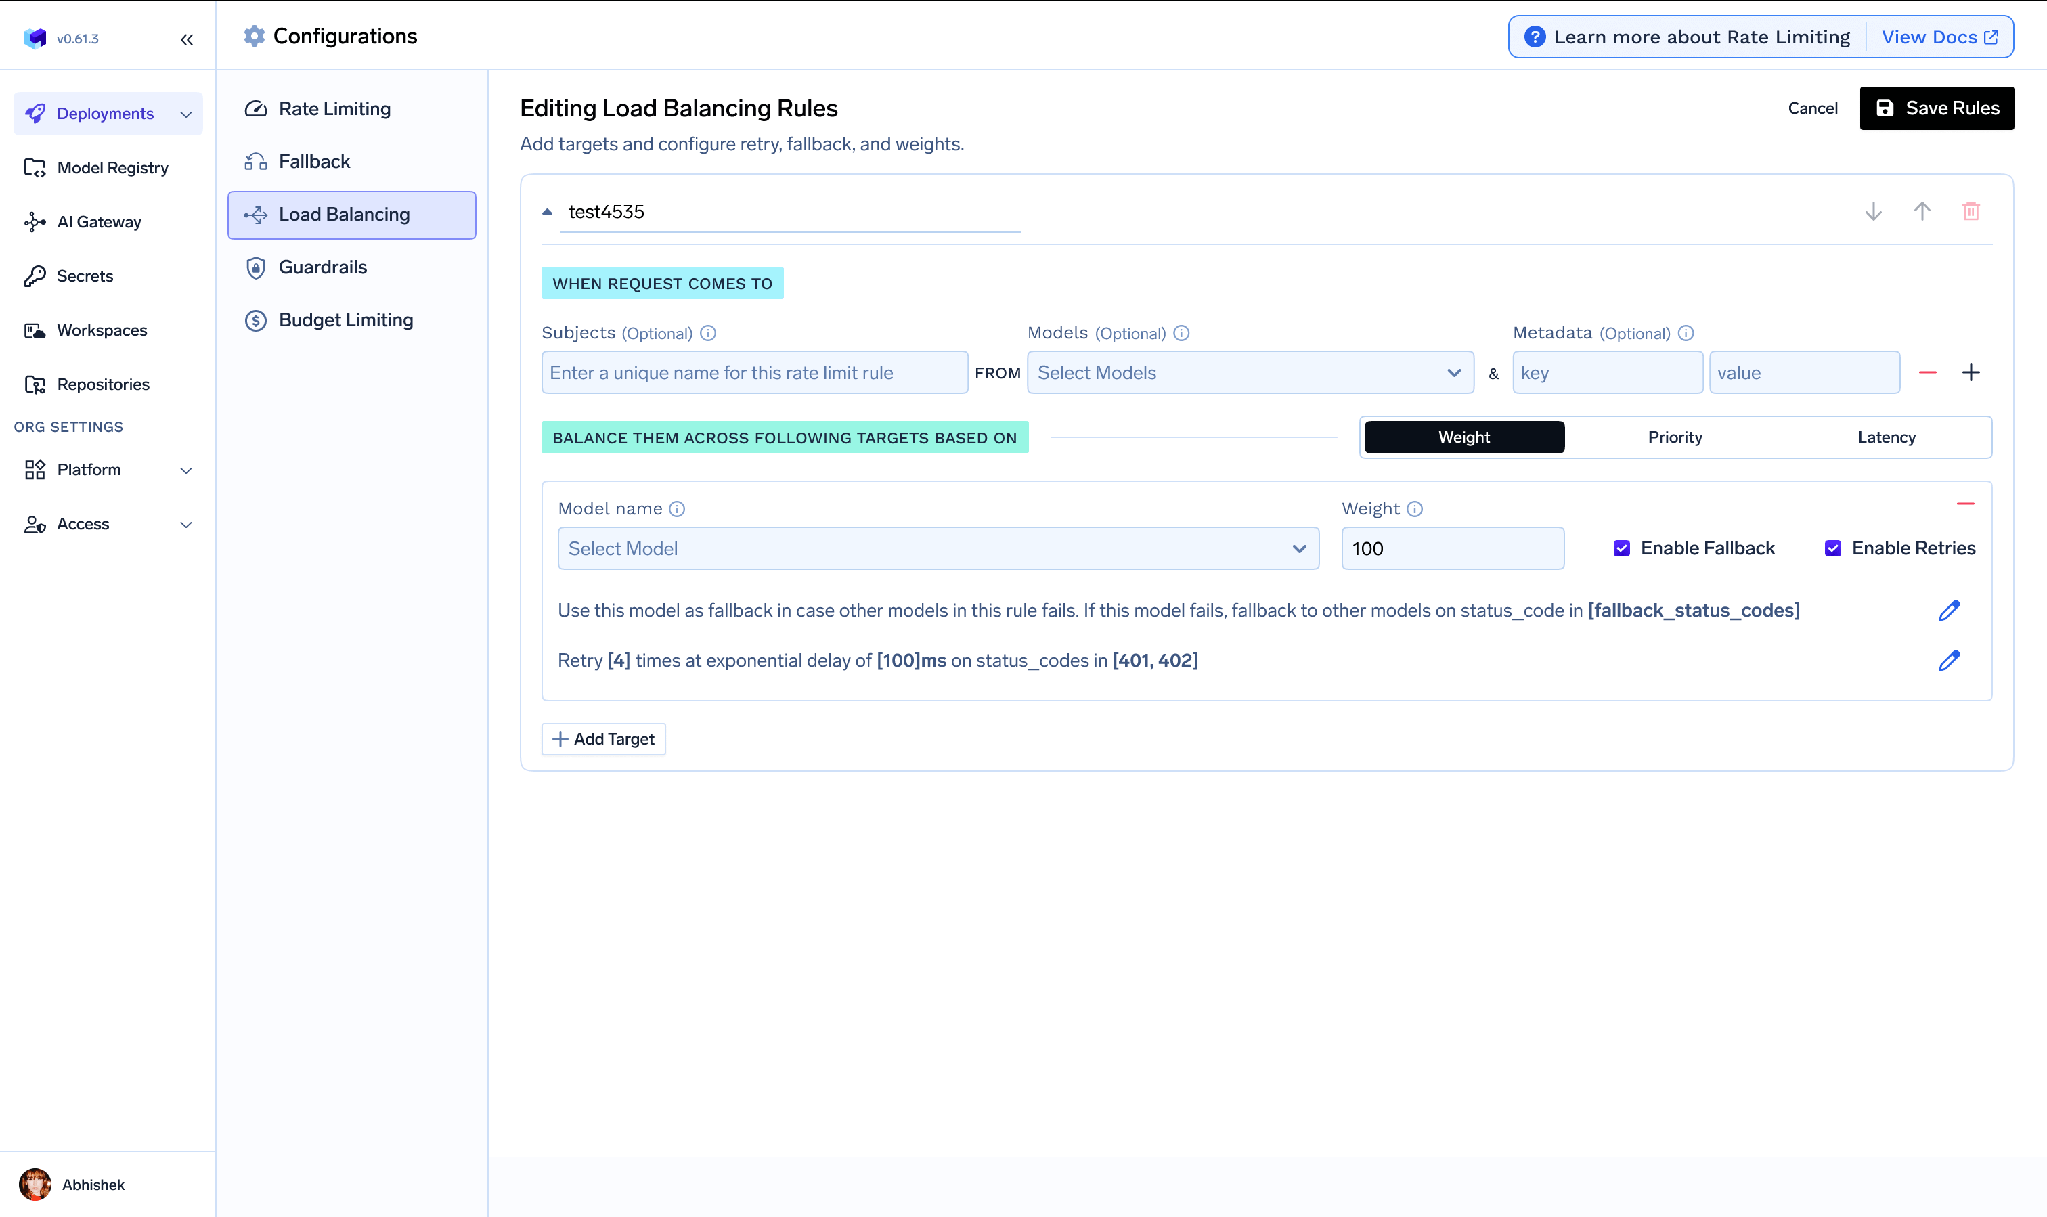
Normaliser la mise en cache entre les fournisseurs. Les sémantiques de cache d'Astra sont celles d'OpenAI. Celles d'Anthropic sont différentes, et celles de Bedrock diffèrent encore. Mise en cache de prompts agnostique vis-à-vis du fournisseur au niveau de la passerelle signifie que vous écrivez le préfixe une seule fois et que la règle des 78,3 % mentionnée plus haut reste valable, quel que soit le modèle choisi par le routeur.
Mesurez le coût par tâche, pas le coût par jeton. L'argument commercial d'Astra repose entièrement sur l'efficacité des jetons, et vous ne pouvez pas le trancher à partir d'une simple liste de prix. Le coût par requête, le nombre de jetons et la latence ventilés par équipe et par modèle sont les indicateurs qui vous permettront de vérifier si la promesse d'Astra, à savoir moins de jetons par tâche, se confirme sur votre charge de travail.
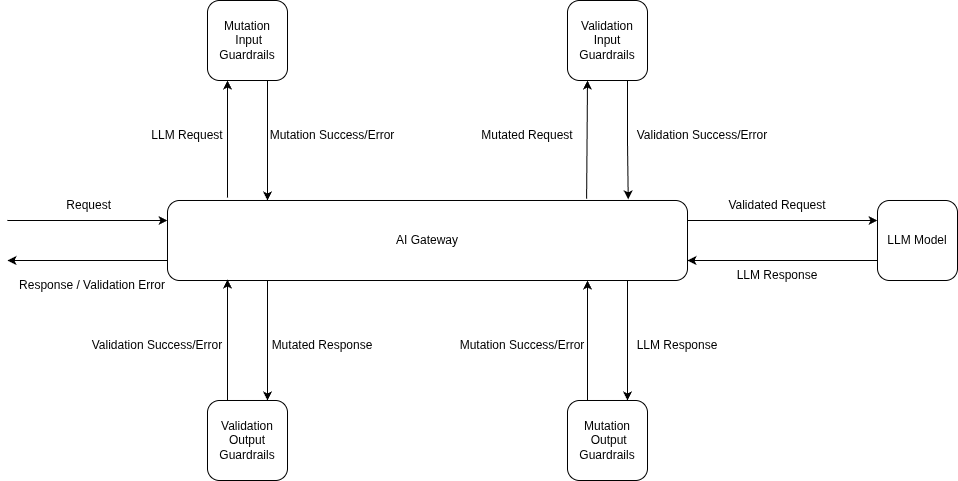
Maintenez un chemin de garde-fous unique pour tous les modèles. Les garde-fous au niveau de la passerelle s'exécutent sur le chemin de la requête et de la réponse, quel que soit le modèle qui répond ; ainsi, un changement de routage ne modifie pas discrètement votre niveau de sécurité.
En résumé, à la date de septembre 2026 :
GPT-6 Astra représente une véritable avancée pour les tâches pour lesquelles il a été conçu. Terminal-Bench 4.0 en hausse de vingt points, récupération en contexte long en hausse de vingt-deux, AutomationBench plus que doublé : ce ne sont pas des améliorations incrémentales. Sur les indices composites tiers publiés par OpenAI lui-même, il n'est pas le leader, et sur les questions de connaissances en un seul essai, l'écart par rapport à GPT-5.6 Sol est proche d'une erreur d'arrondi.
La tarification reflète cette même dualité. Tous les tarifs ont été multipliés par 2,5, ce qui ressemble à une augmentation directe jusqu'à ce que l'on remarque que les estimations par tâche d'OpenAI sont inférieures à celles de Sol sur plusieurs benchmarks d'agents, car Astra termine avec moins de jetons. Les deux affirmations peuvent être vraies. Celle qui s'applique à vous est une question empirique liée à votre trafic, et la seule façon d'y répondre est d'exécuter les deux et de mesurer le coût par tâche terminée.
Deux points ne nécessitent aucune mesure. La mise en cache reste rentable exactement au même seuil de rentabilité de 78,3 % que sur GPT-5.6 ; donc, si vous utilisez le cache aujourd'hui, continuez. Et le seuil de facturation de 272 000 jetons est une fonction en escalier qui doublera discrètement une facture d'entrée pour un prompt qui s'est allongé de quelques milliers de jetons.
Tout dépend donc de ce que vous souhaitez maîtriser. Si vous voulez un modèle unique et une facture simple, dirigez tout vers Astra et acceptez de surpayer pour la moitié la plus simple de votre trafic. Si vous préférez envoyer les tâches complexes vers le modèle de pointe et tout le reste vers une solution moins coûteuse, il vous faut une couche de routage — et à 10 $ en entrée et 50 $ en sortie, le calcul pour en construire une vient de devenir deux fois et demie plus convaincant.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




GPT-6 Astra est le modèle de pointe d'OpenAI, sorti le 3 septembre 2026 et appelable dans l'API sous le nom gpt-6-astra. Il est disponible via l'API OpenAI, Microsoft Azure et AWS Bedrock, ainsi que pour les utilisateurs de ChatGPT Plus, Pro, Business et Enterprise.
En septembre 2026, par million de tokens : 10,00 $ en entrée, 1,00 $ en entrée mise en cache, 12,50 $ pour les écritures en cache, 50,00 $ en sortie. Batch et Flex sont à 50 % de ces tarifs ; le mode Fast est à 2x. Les requêtes de plus de 272K tokens d'entrée sont facturées à 2x les tarifs d'entrée et de cache et à 1,5x le tarif de sortie pour l'ensemble de la requête.
1 050 000 tokens, avec une sortie maximale de 128 000 tokens. Les deux valeurs sont identiques à celles de GPT-5.6 Sol. La limite pratique est commerciale plutôt que technique : au-delà de 272K tokens d'entrée, toute la requête est facturée au double du tarif d'entrée.
Cela dépend entièrement de la nature de la tâche. Sur le travail agentique de longue durée, les gains sont importants — Terminal-Bench 4.0 passe de 37,3 % à 57,9 %. Sur les questions de connaissance à réponse unique, ils sont marginaux, et vous les payez 2,5 fois plus cher par token. Routez en conséquence plutôt que de tout basculer.
Oui, et dans la même proportion. Les écritures en cache coûtent 1,25 fois le prix d'entrée et les lectures 0,10 fois, exactement comme avec GPT-5.6, si bien que le seuil de rentabilité se situe dans les deux cas à une part d'écritures de 78,3 %. Des prix catalogue plus élevés augmentent les économies en valeur absolue, pas le seuil.
L'AI Gateway de TrueFoundry ajoute environ 3 à 4 ms et soutient plus de 350 RPS sur 1 vCPU, ce qui est négligeable face à des temps de génération de plusieurs secondes.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















