



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 8, 202615
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le concept de « Human in the loop » (HITL) pour MCP est une politique de passerelle qui suspend certains appels d'outils jusqu'à ce qu'une personne désignée les approuve ou les refuse. Cela permet aux entreprises d'offrir une réelle autonomie à leurs agents IA sans transformer chaque action irréversible en un risque incontrôlé.
L'authentification prouve l'identité de l'agent. L'autorisation prouve ce qu'il est habilité à appeler. Le HITL répond à la question ultime que ni l'une ni l'autre ne peut trancher : cette action spécifique doit-elle être effectuée maintenant ? Sans HITL, une erreur autorisée peut devenir un incident critique (P1), entraîner la suppression totale des droits d'écriture de l'agent et paralyser l'ensemble du programme d'agents.
La différence entre TrueFoundry et Kong réside dans l'emplacement de l'approbation humaine. Kong fonctionne comme une passerelle API sans état : il évalue chaque appel d'outil MCP et l'autorise ou le refuse de manière synchrone, sans maintenir l'état du flux de travail nécessaire pour suspendre et reprendre une requête. TrueFoundry peut retenir un appel d'outil au niveau de la passerelle, notifier les approbateurs habilités et délivrer une autorisation limitée dans le temps et le périmètre. Les entreprises utilisant Kong doivent concevoir et gérer elles-mêmes ce flux d'approbation humaine.
Imaginez une équipe de plateforme de services financiers. Ses agents accèdent aux systèmes internes uniquement via une passerelle MCP. L'identité, le contrôle d'accès basé sur les rôles (RBAC) et la journalisation d'audit sont déjà en place. Un agent de nettoyage peut accéder à Kubernetes, aux comptes cloud et à Slack, y compris à un outil de suppression de base de données.
Donnez maintenant à cet agent une instruction raisonnable pour la fin du trimestre : « Nettoyer l'infrastructure inutilisée ». Le risque devient évident lorsque l'on suit la requête, de l'autorisation à la conséquence.
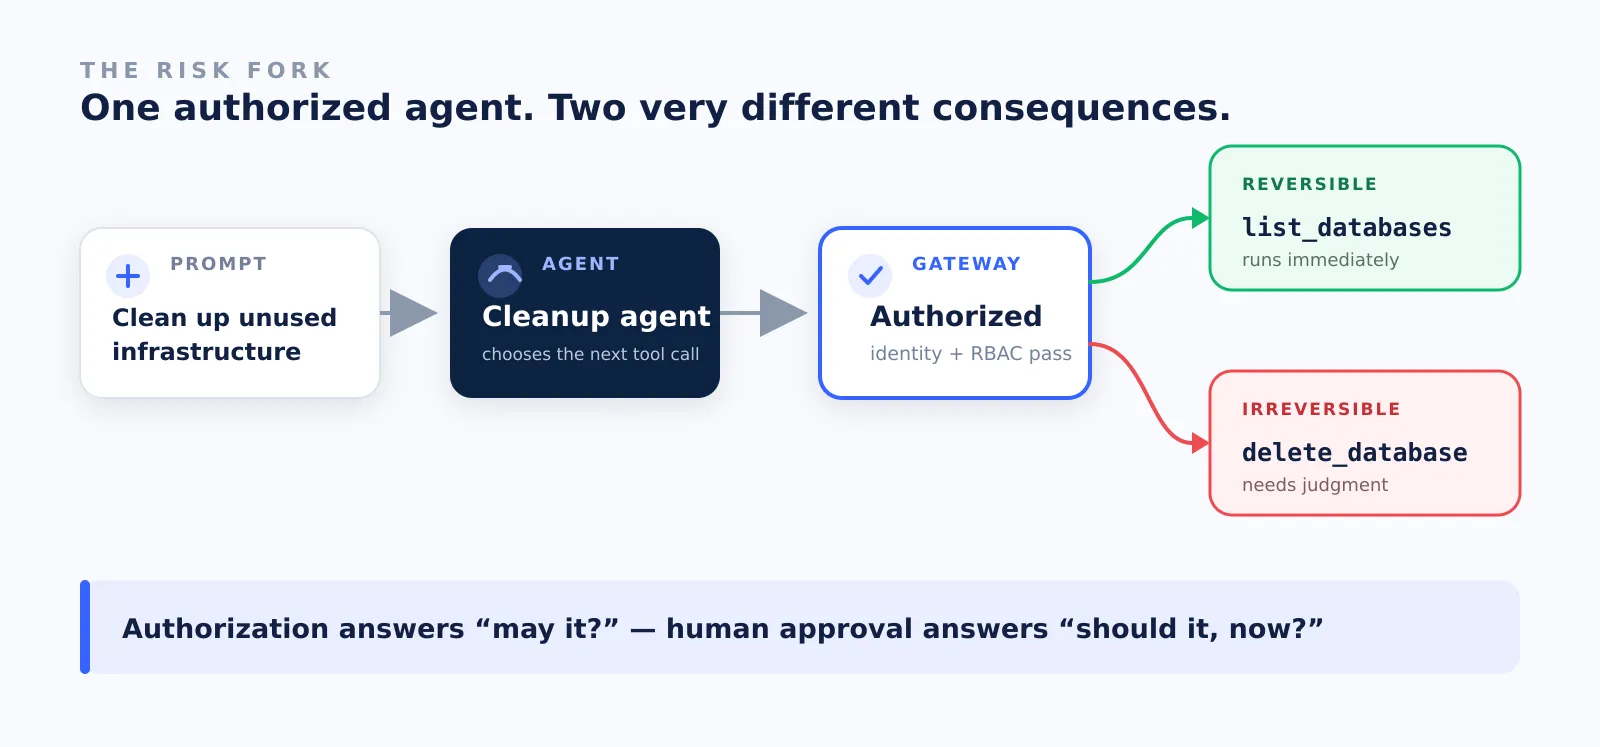
Fig. 01 · Une identité et une passerelle autorisent les deux chemins. La différence ne réside pas dans l'accès, mais dans la conséquence.
L'agent commence par des tâches inoffensives : lister les pods, mettre à l'échelle les déploiements inactifs et inventorier les bases de données. Puis il trouve db-fin-rpt-01, inutilisée depuis 34 jours. L'heuristique indique qu'elle est obsolète, il appelle donc delete_database.
L'appel est valide, authentifié, autorisé et journalisé. C'est précisément là que réside le problème : tous les contrôles conventionnels vérifient si l'appel est autorisé, mais aucun ne demande si cette action irréversible est pertinente à cet instant précis.
Une fois l'appel exécuté, la défaillance technique est récupérable. La perte de confiance dans l'autonomie de l'agent, elle, ne l'est pas.
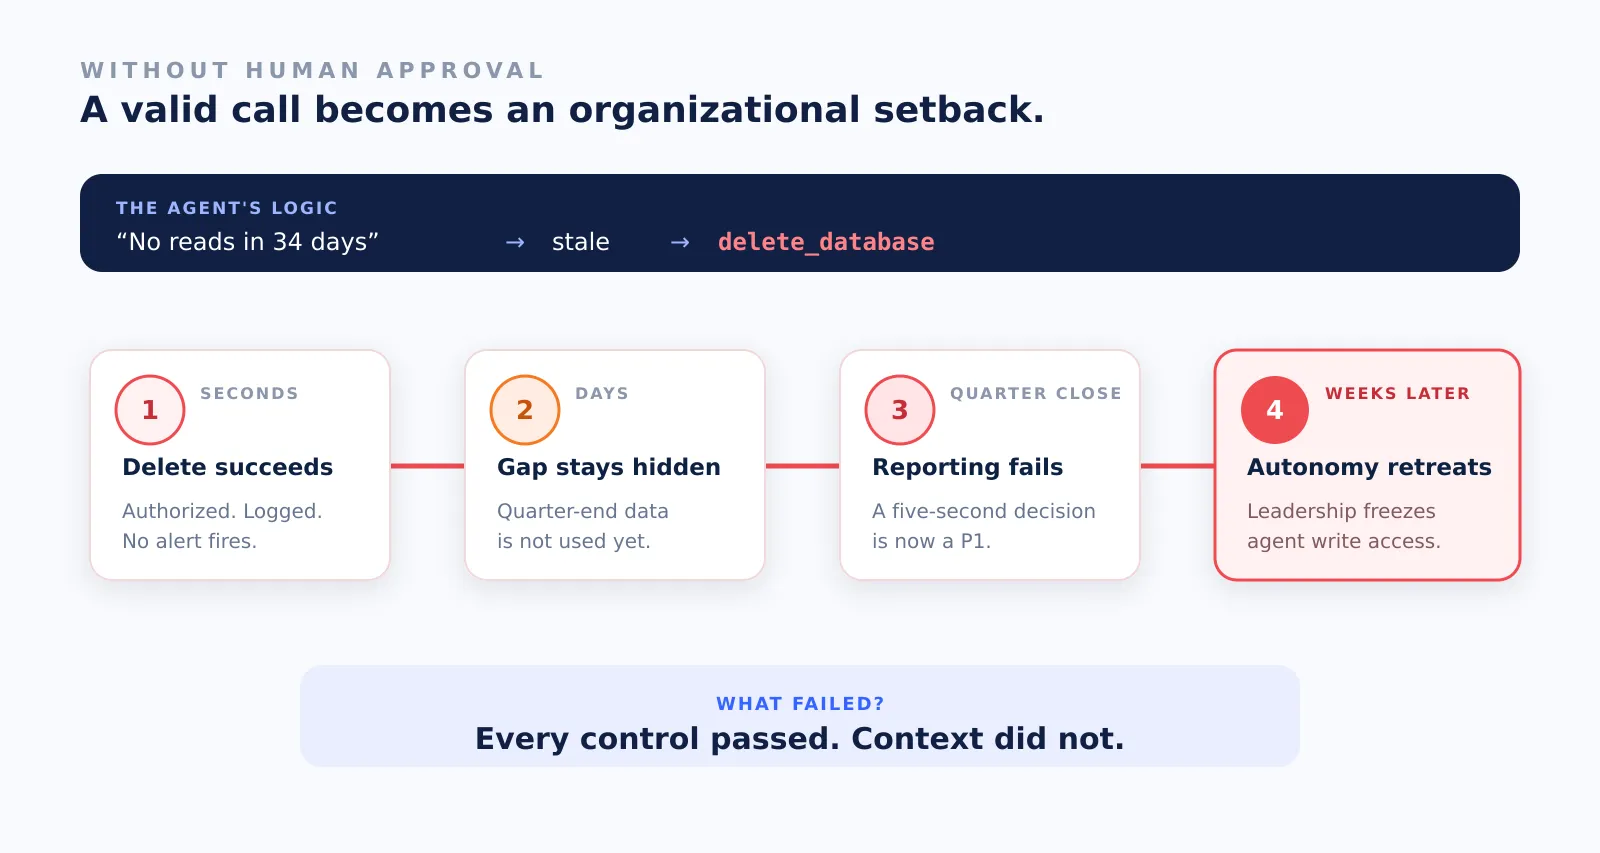
Fig. 02 · Une suppression valide passe d'invisible à urgente, et se termine par un gel des droits d'écriture de l'agent.
Pour un VP Engineering, la leçon n'est pas que l'agent manquait de contrôles, il les avait tous. L'échec réside dans l'absence de décision entre autoriser et refuser. Une brève approbation avant delete_database aurait pu éviter à la fois l'incident P1 de fin de trimestre et le repli ultérieur vers des agents en lecture seule.
Le HITL crée cette troisième voie. Les lectures de routine et les modifications réversibles se poursuivent à la vitesse de la machine ; les actions de suppression, de paiement, d'envoi et de déploiement attendent une intervention humaine. Le problème devient alors une question de politique de passerelle, et non une logique de récupération que chaque équipe d'agents doit réinventer.
TrueFoundry transforme cette troisième voie en une politique de passerelle MCP de premier ordre. Les équipes de plateforme définissent une fois pour toutes les outils nécessitant une approbation, et la règle s'applique ensuite à l'ensemble des agents, clients et frameworks.
Appliquez cela à db-fin-rpt-01 : lorsque l'agent appelle delete_database, la passerelle suspend la requête avant son exécution, notifie un approbateur habilité et renvoie une réponse « approbation en attente » que l'agent peut relancer en toute sécurité. Une approbation crée une autorisation limitée dans le temps, restreinte au demandeur, au serveur et à l'outil concernés.
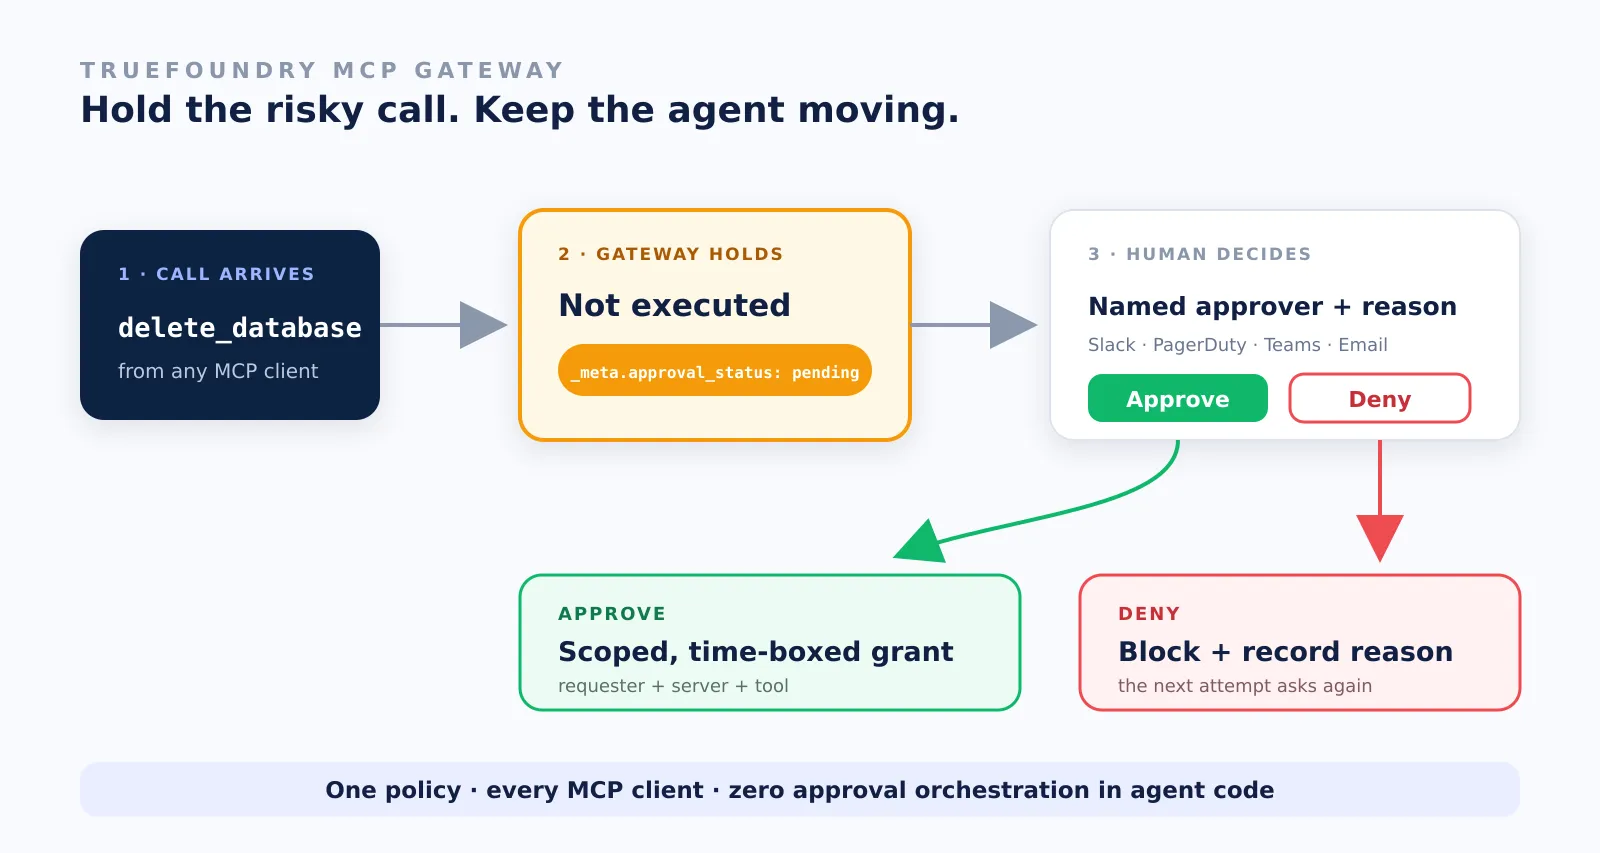
Comme l'état de l'approbation est géré au niveau de la passerelle, les équipes applicatives n'ont pas à réimplémenter la mise en pause, la reprise, les notifications, la gestion des refus et la logique d'audit pour chaque agent. Seuls les administrateurs du tenant et les approbateurs de serveurs MCP désignés peuvent trancher.
Pour l'équipe plateforme, la configuration se résume à définir la politique : sélectionner le serveur et les outils, définir la fenêtre de validité, choisir un canal de notification et enregistrer. En cas de chevauchement des règles, c'est la politique la plus restrictive qui prévaut. C'est à cette limite de workflow que commence la comparaison avec Kong.
Les contrôles MCP de Kong authentifient les agents, appliquent les listes de contrôle d'accès (ACL) aux outils et autorisent ou refusent les appels. Ils ne prennent pas en charge un workflow d'approbation natif capable de suspendre un appel d'outil par ailleurs autorisé, le temps qu'un humain prenne une décision.
C'est la couche manquante. Le HITL est dynamique : la passerelle doit conserver une requête en attente, notifier les approbateurs autorisés, enregistrer la décision et émettre une autorisation limitée et temporaire. Une décision binaire d'autorisation ou de refus par requête ne peut pas assurer ce workflow par elle-même.
Tous ces coûts découlent de la même limite architecturale : Kong régit la requête, tandis que l'entreprise doit construire le cycle de vie de l'approbation autour. La comparaison ci-dessous rend cette limite explicite.
Le tableau des fonctionnalités se résume à un seul test d'approvisionnement en conditions réelles. Demandez à chaque fournisseur : « Un agent autorisé demande une action irréversible sur un MCP. Montrez-moi l'approbation humaine, la politique qui l'a déclenchée et la piste d'audit correspondante. »
Si la démonstration dépend d'un code de workflow personnalisé dans chaque agent, l'approbation n'est pas une fonctionnalité de la plateforme ; c'est une dette technique applicative.
Réserver une démo et sécurisez votre appel d'outil le plus risqué en un après-midi, ou explorez la Agent Gateway et MCP Gateway documentation.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















