



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
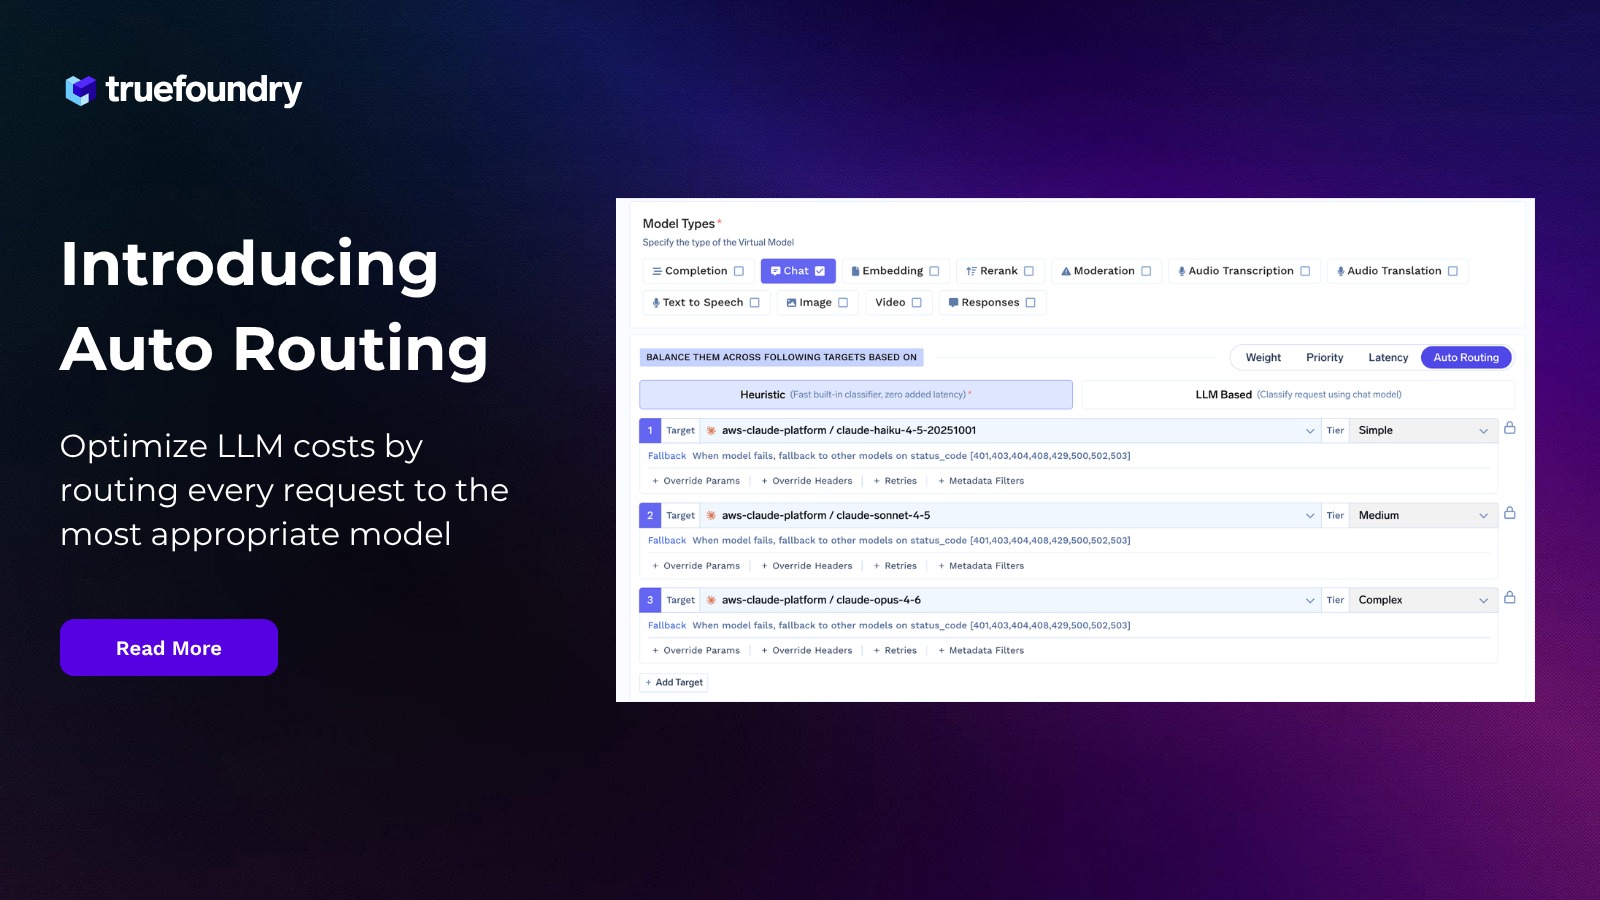
Nous venons d'ajouter une nouvelle fonctionnalité à la passerelle IA de TrueFoundry. Le nouveau routage automatique analyse chaque requête entrante, la classe selon trois niveaux de complexité et l'envoie au modèle le plus adapté à ce niveau.
Nous l'avons conçu pour résoudre un problème récurrent observé dans le trafic de nos clients. En général, la plupart des requêtes sont simples et peuvent être traitées par des modèles légers, tandis que seules quelques requêtes complexes nécessitent un modèle plus puissant. Cependant, il arrive souvent qu'un seul modèle soit systématiquement utilisé pour répondre à toutes les requêtes, quelle que soit leur complexité. Résultat : les entreprises se retrouvent avec une facture inutilement élevée à la fin de chaque cycle. Le codage en dur des règles de routage n'est pas une solution évolutive, car chaque équipe finit par appliquer sa propre logique sans aucune standardisation.
Ce travail incombe désormais à la passerelle.
Pendant la majeure partie des deux dernières années, les équipes ont mesuré l'adoption de l'IA par la consommation. Le nombre de jetons consommés est devenu l'indicateur du travail accompli. Certaines entreprises ont même mis en place des classements internes pour récompenser les plus gros consommateurs. Cela pouvait se justifier au début de l'adoption de l'IA, lorsque l'objectif était de comprendre quelle part de travail pouvait réellement être déléguée aux modèles.
Puis les factures sont arrivées. Dans une enquête IDC auprès des décideurs cloud et IA, 61 % des organisations ont dépassé leur budget cloud IA pour 2025. Le CTO d'Uber a révélé que son équipe avait épuisé son budget annuel dédié à l'IA dès la mi-avril. Les boucles de raisonnement se sont allongées, les fenêtres de contexte se sont étoffées et les agents ont commencé à solliciter des modèles pour leur propre compte des milliers de fois par jour, sans aucune supervision.
Les priorités ont donc changé. La consommation effrénée de jetons a laissé place à l'économie des jetons, une stratégie où les entreprises cherchent à plafonner leurs dépenses en IA sans freiner l'adoption ou l'expérimentation. Cela implique une attention accrue portée à l'observabilité des coûts en temps réel, aux modèles de refacturation interne, à l'attribution par équipe et aux plafonds d'utilisation. Bien qu'importantes, ces fonctionnalités ne permettent que de surveiller ou de restreindre les dépenses, et non de les optimiser.
La décision qui détermine réellement votre facture intervient bien plus tôt et bien plus vite : quel modèle reçoit cette requête. C'est à ce niveau que le routage automatique intervient.
Le routage automatique est configuré sur un modèle virtuel, qui correspond à une entrée nommée appelée par votre application. Vous pouvez assigner des modèles spécifiques à trois niveaux de complexité.
Comme les attributions de niveaux sont gérées au niveau du modèle virtuel, vous pouvez remplacer le modèle associé à un niveau dès qu'une option plus performante ou plus économique est disponible, sans modifier le code de votre application. La politique de routage devient un objet de configuration doté d'un responsable, d'un historique des modifications et d'un point d'édition unique.
Il existe deux méthodes pour classer chaque requête dans l'un des trois niveaux :
Le classificateur heuristique lit l'invite, l'évalue par rapport à un ensemble fixe de signaux et sélectionne un niveau. Il s'exécute au sein du processus de passerelle, n'ajoute donc aucune latence ni aucun coût, et est entièrement déterministe.
Il détermine la complexité d'une requête en fonction de certains paramètres :
Ici, vous choisissez le modèle de classification, qui doit être un modèle de chat du catalogue plutôt qu'un autre modèle virtuel, et vous définissez un délai d'expiration en millisecondes. Vous devez également configurer ce qui se passe en cas d'échec de cet appel. Deux options de secours sont disponibles : heuristique, qui renvoie la décision aux signaux intégrés, ou statique, qui envoie tout vers un niveau que vous nommez. Une défaillance du classificateur n'entraîne jamais l'échec de la requête.
Cela implique deux compromis. Le classificateur s'exécute en tant qu'appel de modèle avant la requête, ce qui ajoute de la latence. Il s'agit également d'une requête de passerelle facturable, attribuée au même locataire et au même sujet que la requête qui l'a déclenchée.
Le routage automatique va plus loin que les simples règles de routage, en vous offrant des capacités supplémentaires pour garantir l'optimisation des dépenses liées aux modèles, tout en conservant la précision :
Nous avons testé Auto Routing par rapport à une référence envoyant chaque requête à Claude Opus 5, sur 16 jeux de données publics et environ 4 700 appels, en utilisant le classificateur heuristique gratuit et une hiérarchie Haiku, Sonnet, Opus. L'évaluation est déterministe : le code généré est exécuté par rapport aux tests unitaires de chaque benchmark dans un environnement isolé, et les réponses mathématiques ainsi que les choix multiples sont comparés aux clés de correction.
Dans chaque cas, des économies significatives ont été réalisées, sans aucun compromis sur la qualité.
Pour consulter la méthodologie complète, la répartition par jeu de données et l'analyse du trafic en production, lisez notre analyse technique approfondie : Comment nous avons réduit les coûts des LLM de deux tiers sans perte de qualité.
Auto Routing repose sur un modèle virtuel. Accédez à AI Gateway → Modèles → Modèle virtuel, choisissez Complexité comme type de routage, sélectionnez une stratégie de classification et définissez une cible pour chaque niveau que vous souhaitez utiliser. Ensuite, pointez votre application vers le nom du modèle virtuel et testez-le avec des prompts de complexité variable dans le playground.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















