



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le RBAC Kubernetes est le mode d'autorisation qui détermine si une requête authentifiée adressée au serveur API est autorisée. Il est intégré au groupe d'API rbac.authorization.k8s.io/v1 et est activé sur pratiquement tous les clusters gérés.
L'authentification et l'autorisation sont deux étapes distinctes. Le serveur API détermine d'abord qui vous êtes – à partir d'un certificat client, d'un jeton OIDC, d'un jeton ServiceAccount ou d'une identité IAM cloud – puis demande au RBAC si cette identité est autorisée à effectuer ce verbe sur cette ressource. Le RBAC ne définit jamais l'identité, seulement les permissions.
Une règle RBAC s'appuie sur un petit ensemble de champs de requête :
Deux propriétés sont plus importantes que n'importe quel détail de syntaxe.
Le RBAC est additif. Il n'existe pas de règle de refus. Si une liaison accorde une permission, vous l'avez, et la seule façon de la supprimer est de supprimer toutes les liaisons qui l'accordent. D'où le ticket classique : « J'ai supprimé leur rôle d'administrateur, mais ils peuvent toujours supprimer des pods. »
Le RBAC est basé sur le refus par défaut. Tout verbe qui n'a pas été explicitement accordé est refusé. Le risque réel n'est donc presque jamais une règle manquante, mais plutôt une règle beaucoup trop large par rapport à l'intention initiale.
Un Role est un objet associé à un namespace. Il accorde des permissions sur des ressources situées dans un namespace, et uniquement au sein de celui-ci.
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: pod-reader
  namespace: team-alpha
rules:
  - apiGroups: [""]              # "" is the core API group
    resources: ["pods", "pods/log"]
    verbs: ["get", "list", "watch"]
Un ClusterRole n'est pas associé à un namespace. Il existe une seule fois pour l'ensemble du cluster et permet trois choses qu'un Role ne peut pas faire :
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: node-viewer
rules:
  - apiGroups: [""]
    resources: ["nodes"]          # cluster-scoped
    verbs: ["get", "list", "watch"]
  - nonResourceURLs: ["/healthz"]
    verbs: ["get"]
La question du choix entre Role et ClusterRole dans k8s est généralement posée comme s'il s'agissait d'une question de privilèges. Il s'agit en réalité de portée et de réutilisation:
Quatre ClusterRoles par défaut méritent d'être connus avant d'écrire les vôtres : view (lecture de la plupart des ressources à portée d'espace de noms, en excluant délibérément les Secrets), edit (lecture/écriture de la plupart, incluant les Secrets), admin (modification et création de Roles et RoleBindings dans l'espace de noms), et cluster-admin (* sur *, partout).
view, edit et admin sont des ClusterRoles agrégés: le contrôleur remplit leurs règles à partir de tout ClusterRole étiqueté pour correspondre à leur aggregationRule. C'est la méthode prise en charge pour les étendre à vos propres CRD.
Un Role ou un ClusterRole seul n'accorde rien. Une liaison (binding) l'associe à des sujets.
Un RoleBinding est limité à un espace de noms et accorde son roleRef à ses sujets au sein de son propre espace de noms.
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: alpha-pod-readers
  namespace: team-alpha
subjects:
  - kind: Group
    name: team-alpha-engineers
    apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io
La chose la plus utile à savoir sur le RoleBinding dans Kubernetes est que son roleRef peut pointer vers un ClusterRole, et les autorisations restent confinées à l'espace de noms du RoleBinding. Définissez la capacité une fois ; accordez-la espace de noms par espace de noms :
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: alpha-viewers
  namespace: team-alpha
subjects:
  - kind: ServiceAccount
    name: reporting
    namespace: team-alpha
roleRef:
  kind: ClusterRole
  name: view                     # scoped to team-alpha by this binding
  apiGroup: rbac.authorization.k8s.io
Un ClusterRoleBinding supprime cette limite, accordant un ClusterRole partout – dans chaque espace de noms, ainsi que pour toutes les ressources à portée de cluster définies dans le rôle.
Trois règles qui piègent souvent les utilisateurs :
Le RBAC reconnaît exactement trois types de sujets, et ce qui les distingue est leur origine.
Il n'existe pas de ressource Utilisateur – vous ne pouvez pas faire de kubectl create user. Kubernetes fait correspondre le nom d'utilisateur et la liste de groupes fournis par l'authentificateur aux liaisons sous forme de chaînes de caractères simples ; ainsi, une faute de frappe dans le nom d'un sujet n'accorde rien silencieusement, sans erreur lors de l'application.
Les ServiceAccounts sont l'identité utilisée par vos charges de travail. Un pod qui n'en spécifie aucun s'exécute avec le compte par défaut de son namespace, qui ne possède aucune autorisation mais dont le jeton est tout de même monté et authentifié. Par conséquent, définissez automountServiceAccountToken: false partout où un pod n'appelle jamais le serveur API.
Kubernetes synthétise également des groupes que vous ne devriez jamais lier à la légère : system:authenticated (toute identité authentifiée), system:serviceaccounts (tous les comptes de service à l'échelle du cluster) et system:masters, qu'une liaison par défaut mappe directement sur cluster-admin.
Les recommandations officielles sont concises, et portent presque exclusivement sur la portée.
Privilégiez les Roles limités à un namespace. Optez d'abord pour un Role et un RoleBinding. Utilisez un ClusterRole lorsque la ressource est réellement étendue au cluster ou si vous souhaitez une définition réutilisable – et même dans ce cas, liez-le avec un RoleBinding, sauf si le sujet a réellement besoin d'accéder à tous les namespaces.
Ne distribuez pas de droits cluster-admin. L'utilisation de * sur * inclut les objets RBAC eux-mêmes, ce qui permet à un détenteur de s'octroyer n'importe quel droit de manière permanente. Réservez cette pratique aux procédures d'urgence (break-glass).
Évitez les caractères génériques (wildcards). resources: ["*"] inclut silencieusement les CRD installés ultérieurement, et verbs: ["*"] comprend deletecollection. Énumérez vos ressources.
Privilégiez les groupes aux utilisateurs individuels. Une liaison par personne devient ingérable lors des départs. Associez vos groupes IdP au cluster et liez-les, ainsi les changements d'équipe ne nécessitent aucune modification de YAML.
Considérez l'autorisation list sur les Secrets comme un accès en lecture aux Secrets. list renvoie le corps complet des objets, ce qui n'est pas moins permissif que get. La lecture de Secrets expose également les identifiants du ServiceAccount de cet espace de noms.
Connaissez les verbes d'escalade. create sur les pods permet au détenteur d'exécuter un pod en tant que n'importe quel ServiceAccount dans l'espace de noms et d'hériter de ses permissions. escalate et bind lèvent la protection qui vous empêche d'accorder des permissions que vous ne possédez pas. impersonate vous permet d'agir sous une autre identité.
Auditez avec l'outil, pas avec le YAML. Comme les autorisations sont cumulatives et proviennent de plusieurs liaisons, seul le serveur API fournit une réponse fiable :
kubectl auth can-i delete pods --namespace team-alpha
kubectl auth can-i --list --namespace team-alpha
kubectl auth can-i list secrets \
--as=system:serviceaccount:team-alpha:reporting -n team-alpha
--as nécessite une autorisation d'usurpation d'identité (impersonation), que les administrateurs possèdent généralement. Appliquez les manifestes RBAC avec kubectl auth reconcile, qui fusionne les règles et les sujets au lieu de les remplacer.
Utiliser un ClusterRoleBinding alors qu'un RoleBinding suffirait. C'est l'erreur la plus courante. Quelqu'un a besoin d'un accès en lecture dans son propre espace de noms, le ClusterRole existe déjà, et un ClusterRoleBinding est plus rapide à écrire – mais il accorde aussi un accès en lecture sur tous les espaces de noms, y compris là où se trouvent les Secrets.
Croire que les espaces de noms isolent davantage qu'ils ne le font réellement. Un espace de noms est l'unité de portée pour le RBAC et rien d'autre – ce n'est pas une limite réseau, de nœud ou de ressource. Dire « ils n'ont accès qu'à leur espace de noms » est une affirmation concernant le serveur API, pas le cluster.
Lier à system:authenticated par facilité. Cela ressemble à « tout le monde dans l'équipe ». Cela signifie chaque identité capable de s'authentifier, y compris chaque ServiceAccount dans chaque espace de noms.
Croire que le RBAC du cluster couvre la plateforme qui s'exécute sur le cluster. Un data scientist sans aucune autorisation Kubernetes peut toujours déployer un service, appeler un modèle ou lire un secret, car ces actions passent par une API de plateforme que le RBAC du cluster ne voit jamais.
Le RBAC de Kubernetes répond précisément à une question : qui peut effectuer ce verbe sur cet objet Kubernetes ? Il n'a aucun avis sur une deuxième question tout aussi importante sur une plateforme d'IA : qui peut déployer ce modèle, utiliser ce compte fournisseur, appeler cet outil MCP ou lire ce groupe de secrets ? Ce ne sont pas des objets Kubernetes. Ils résident dans un plan de contrôle, accessible via une API de plateforme, et aucun Role ou RoleBinding ne les régit.
TrueFoundry est natif à Kubernetes – le plan de calcul est constitué d'un ou plusieurs de vos propres clusters EKS, GKE, AKS, OpenShift ou sur site, connectés en sortie au plan de contrôle par un tfy-agent léger. Les deux couches sont présentes simultanément, il est donc utile d'être précis sur la distinction entre les deux.
Les deux modèles partagent un vocabulaire, et ce n'est pas une coïncidence. Dans les concepts clésde TrueFoundry, un Cluster est un cluster Kubernetes réel et un Workspace est un namespace Kubernetes. Accordez à quelqu'un Membre de l'espace de travail et vous leur attribuez le même périmètre d'objet qu'un RoleBinding.
Ce que vous ne faites pas, c'est écrire un RoleBinding. Les rôles de la plateforme et les objets RBAC du cluster sont configurés indépendamment, à des endroits différents, et la documentation ne décrit aucun mécanisme permettant de générer, synchroniser ou traduire l'un en l'autre. Deux couches, une frontière commune. La documentation trace la même limite pour l'audit : les journaux d'audit de la plateforme couvrent l'activité de la plateforme et ne remplacent explicitement pas les journaux d'audit au niveau de l'infrastructure provenant de Kubernetes ou de votre cloud.
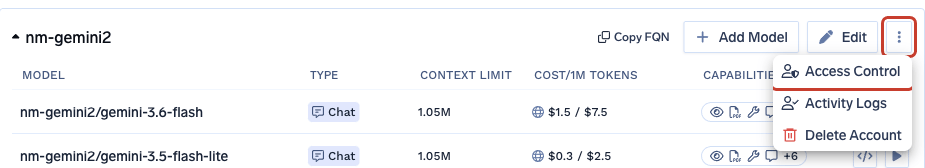
Le modèle est sujet + ressource + rôle = attribution de rôle, ce qui vous semblera familier. Un sujet est un utilisateur, une équipe, un compte virtuel ou un agent ; une ressource est un cluster, un espace de travail, un dépôt, un groupe de secrets, un compte fournisseur ou un serveur MCP. Les autorisations commencent à partir de la ressource – ouvrez son menu à trois points et choisissez Contrôle d'accès:
Choisissez ensuite les sujets et un rôle. Le panneau latéral liste les actions incluses dans chaque rôle :
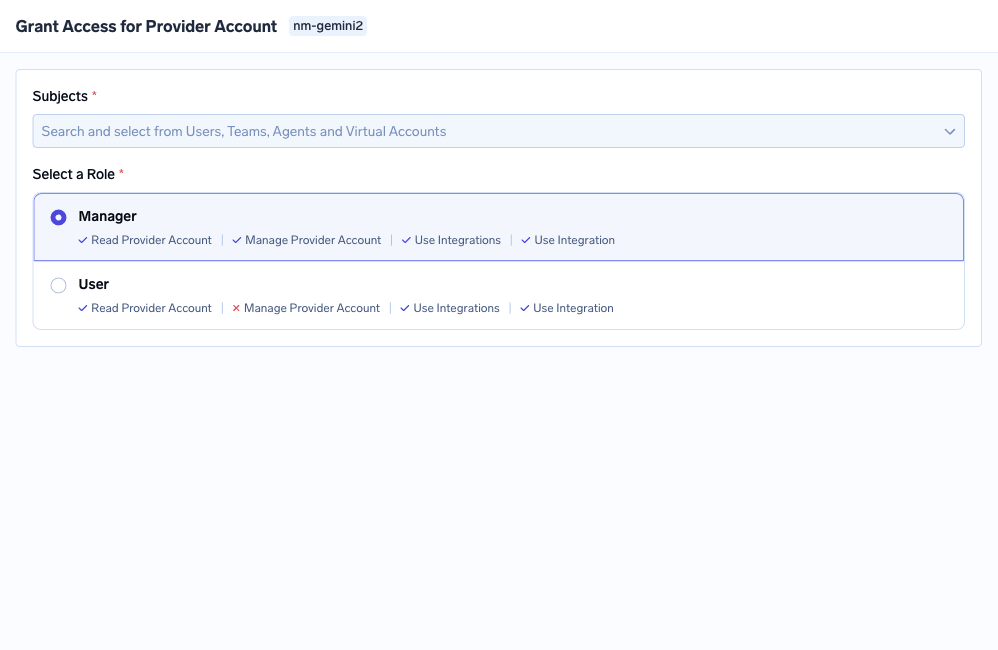
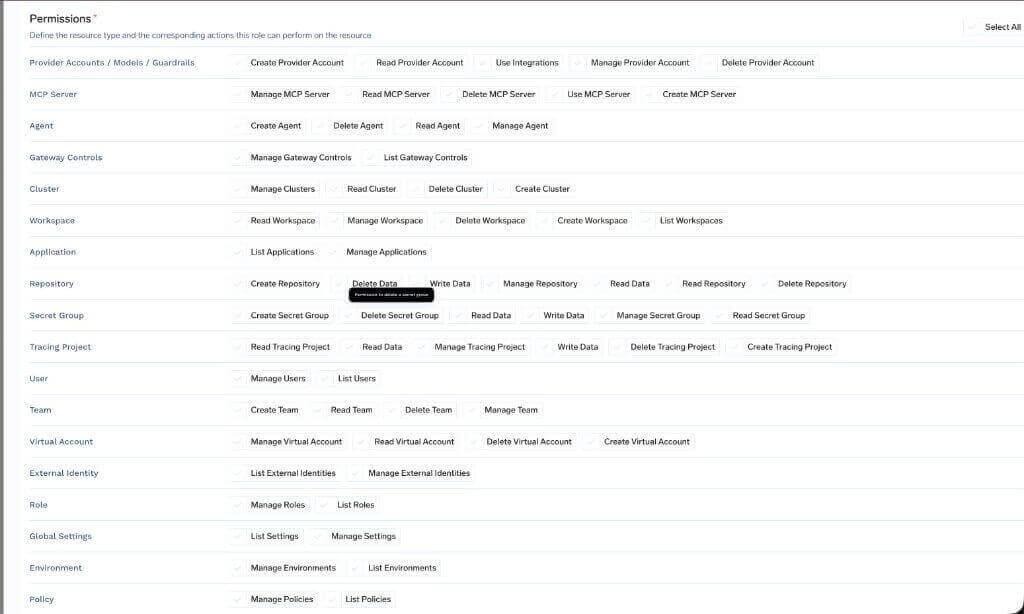
Les rôles proposés dépendent du type de ressource : Administrateur / Membre / Lecteur de cluster sur un cluster, Administrateur / Membre / Lecteur d'espace de travail sur un espace de travail, Gestionnaire / Utilisateur / Approbateur sur un serveur MCP. En arrière-plan, les permissions sont des clés structurées sous la forme ressource:Action – cluster:ReadCluster, workspace:ManageWorkspace, secret-group:ReadData. La même structure de règle que Kubernetes, mais avec des objets différents :
Les rôles à l'échelle du tenant sont l'équivalent sur la plateforme d'un ClusterRoleBinding et comportent le même avertissement. Administrateur et Membre en lecture seule ne peuvent pas être modifiés. Membre, le rôle de base modifiable attribué à chaque utilisateur, est volontairement limité – cluster:ReadCluster, user:ListUsers, agent:CreateAgent et quelques autres – sans accès à aucun espace de travail, modèle ou serveur MCP individuel.
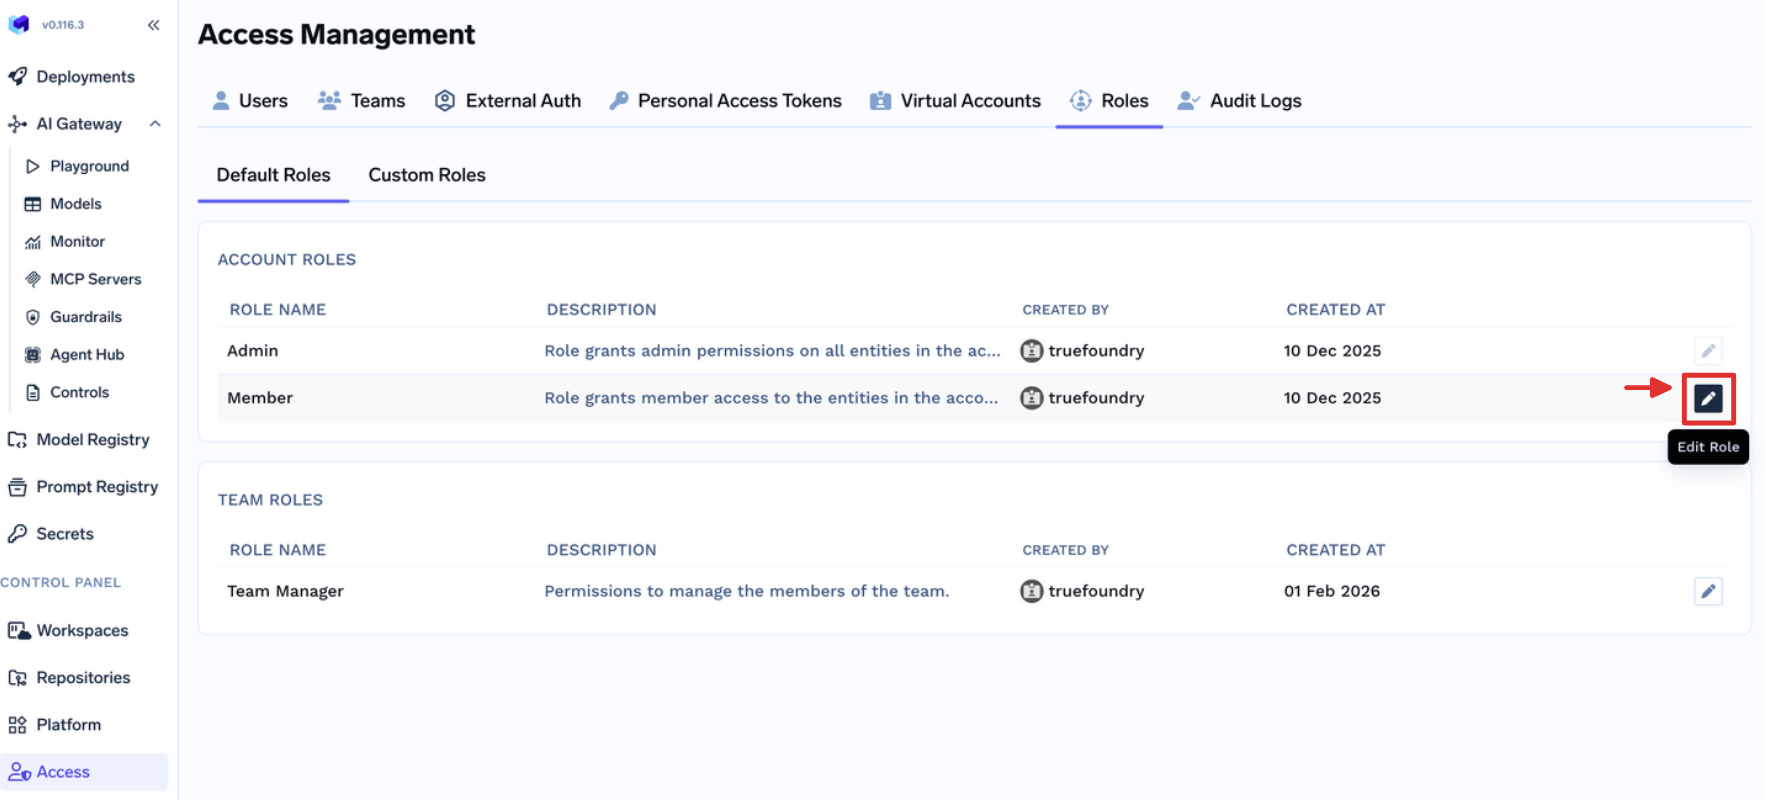
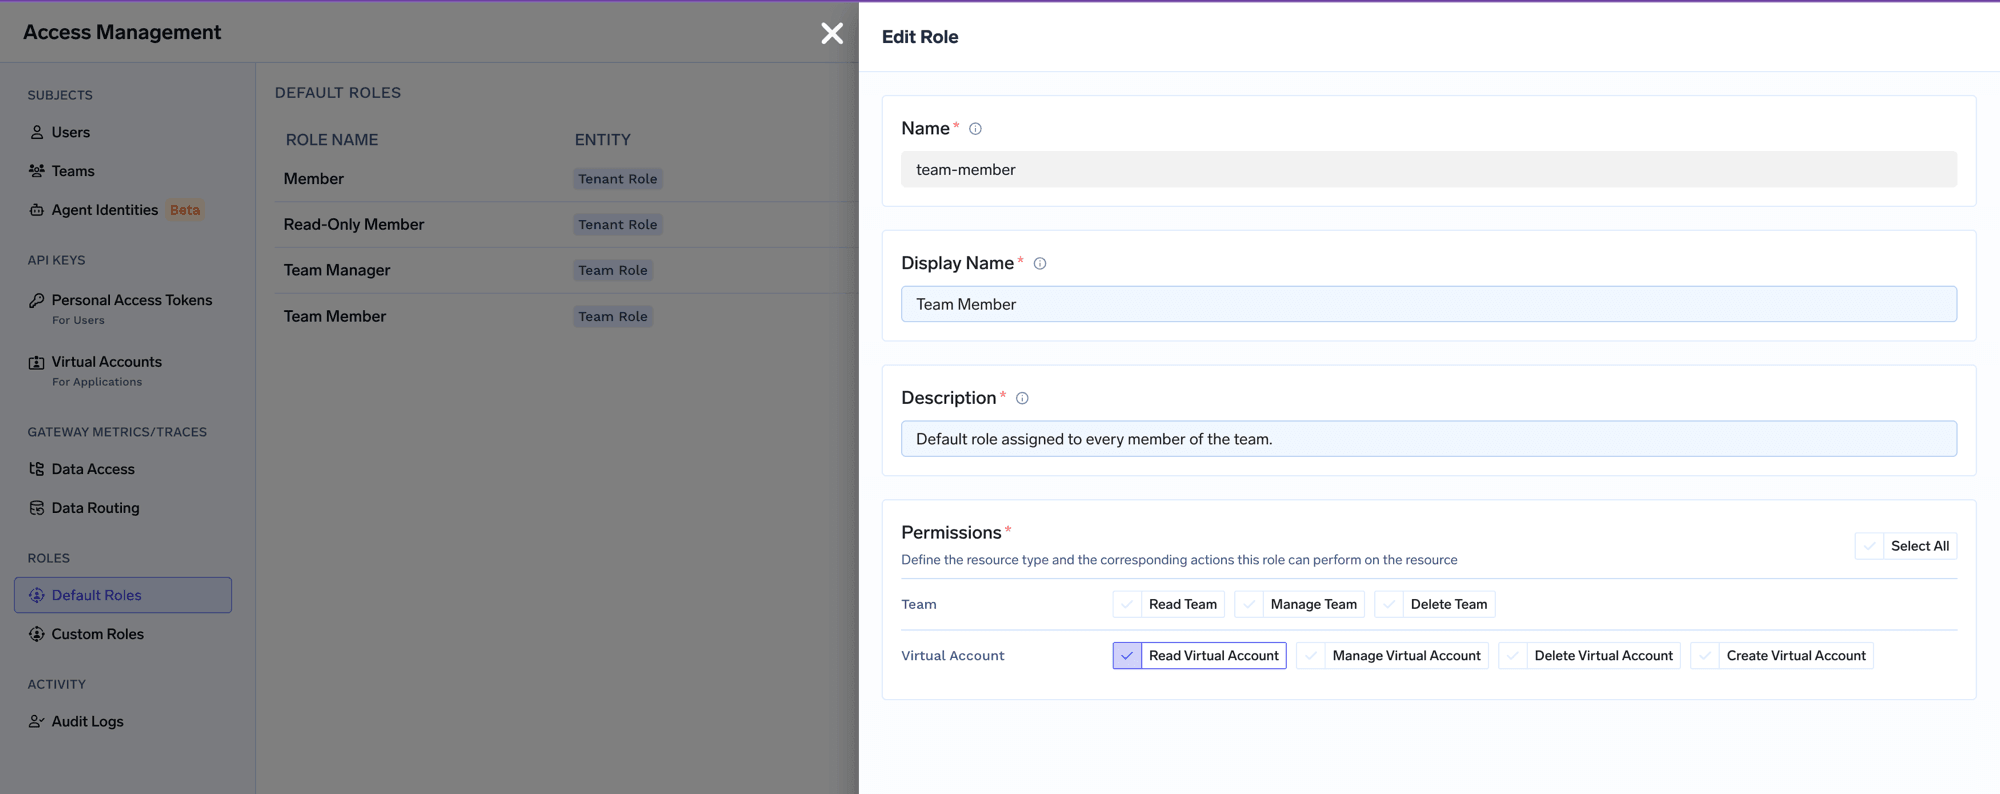
Les rôles d'équipe correspondent à un RoleBinding limité par la propriété : Membre de l'équipe inclut virtual-account:ReadVirtualAccount, limité aux comptes virtuels appartenant aux équipes dont l'utilisateur fait partie.
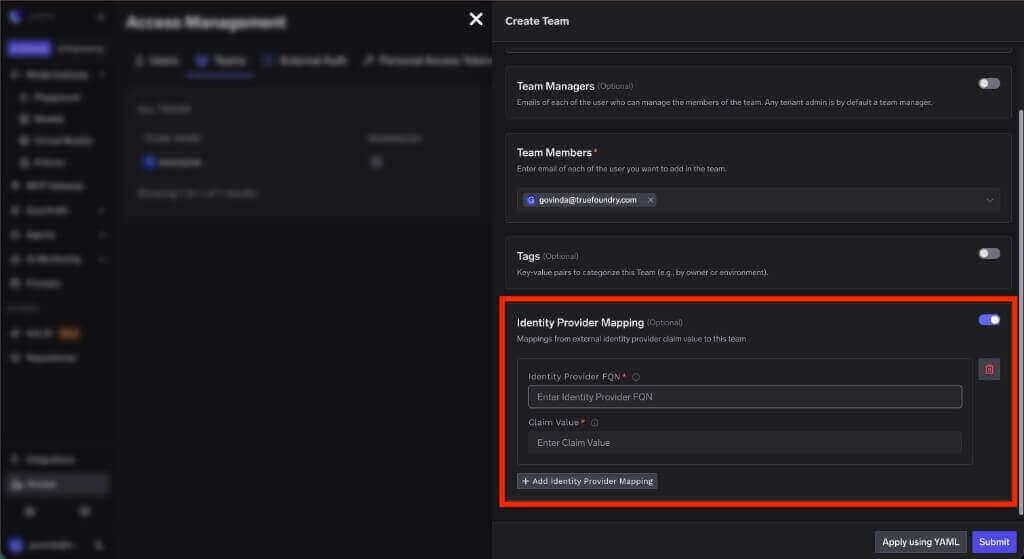
La bonne pratique consistant à lier des groupes plutôt que des utilisateurs reste valable. Une valeur de revendication IdP est associée à une équipe TrueFoundry, de sorte que le même groupe d'annuaire qui gère vos liaisons de cluster gère l'appartenance à la plateforme :
Une demande réaliste : permettre à l'équipe ML de déployer dans son propre namespace et de mettre en place un serveur MCP, sans nommer personne administrateur de cluster ou administrateur de tenant.
Dans Kubernetes. Le namespace est ml-prod. Liez le rôle edit à ce namespace unique avec un RoleBinding dont le sujet est le groupe géré par l'IdP :
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: ml-team-edit
  namespace: ml-prod
subjects:
  - kind: Group
    name: ml-engineers
    apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: ClusterRole
  name: edit
  apiGroup: rbac.authorization.k8s.io
Vérifiez-le et contrôlez également le rayon d'impact dans la direction négative :
# --as-group must be paired with --as
kubectl auth can-i create deployments -n ml-prod \
  --as=priya --as-group=ml-engineers
kubectl auth can-i create deployments -n payments \
  --as=priya --as-group=ml-engineers
Notez que l'édition inclut les Secrets dans cet espace de noms. Si l'équipe ne doit pas y avoir accès, liez un ClusterRole personnalisé plus restreint.
Dans la plateforme. Rien de tout cela ne permet à quiconque de créer un serveur MCP, car les serveurs MCP ne sont pas des objets Kubernetes. L'instinct pousse à accorder un accès Admin. Construisez plutôt un rôle personnalisé à partir de Accès > Rôles personnalisés contenant exactement mcp-server:CreateMcpServer :
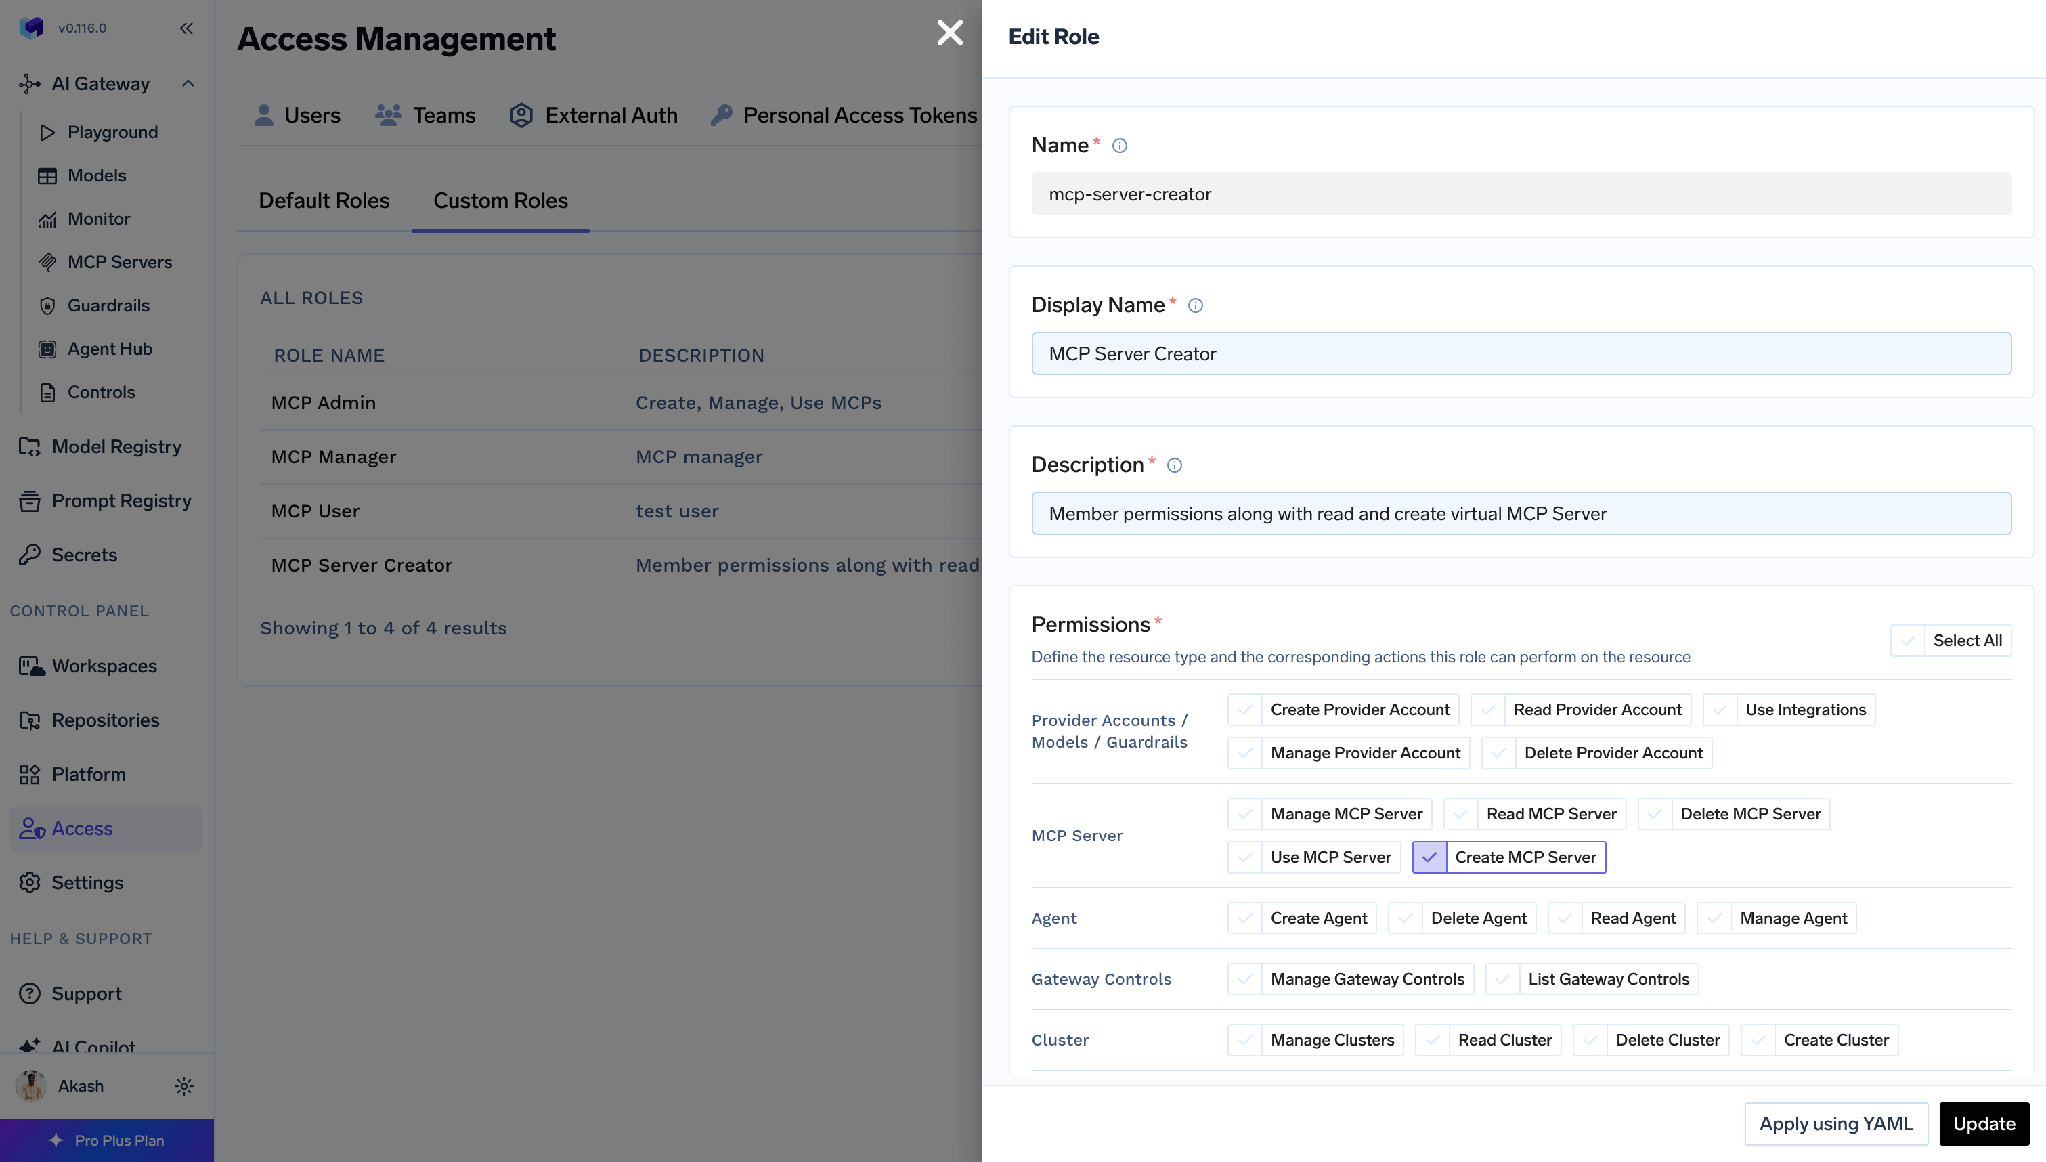
Attribuez-le ensuite depuis Accès > Utilisateurs ou Accès > Équipes.
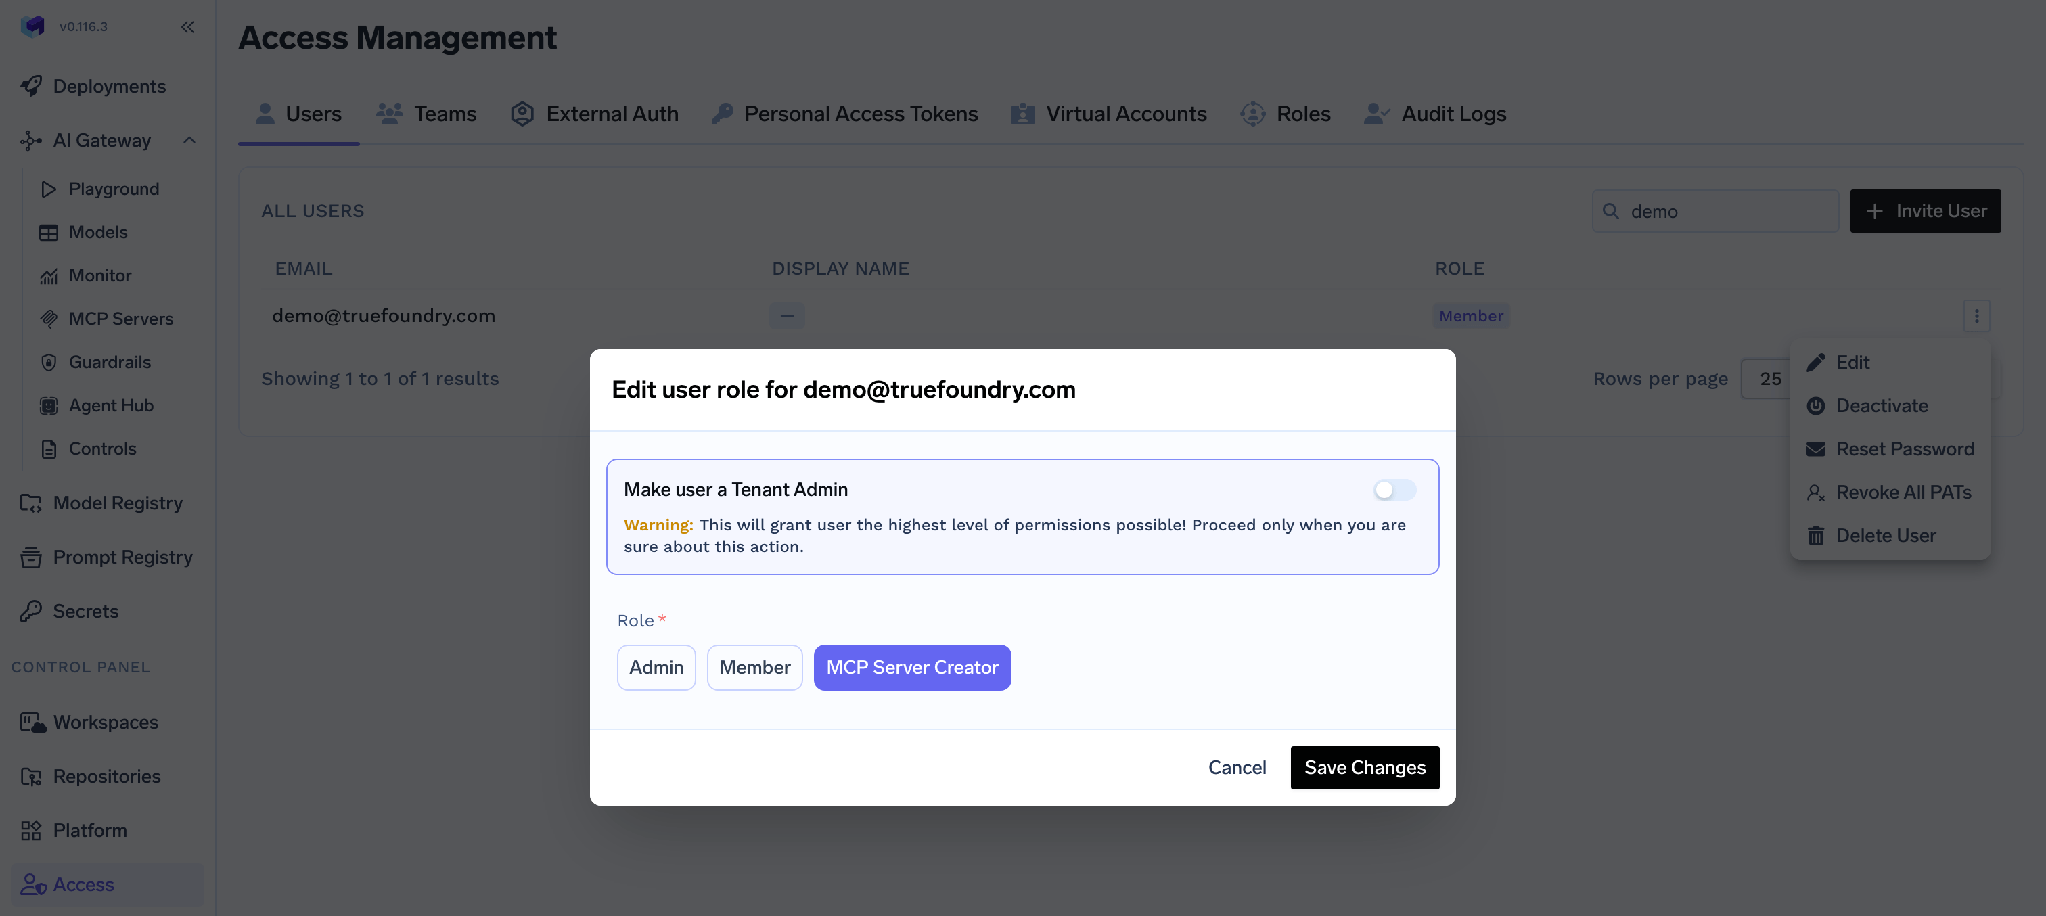
Le comportement reflète précisément celui de Kubernetes. Créer un serveur MCP permet de créer un nouveau serveur et n'accorde aucun droit sur ceux existants – exactement comme l'autorisation de création sur une ressource Kubernetes n'accorde aucun droit sur les objets déjà présents. Le propriétaire s'octroie ensuite le rôle Gestionnaire de serveur MCP depuis la page de contrôle d'accès propre à ce serveur, et contrôle d'accès MCP régit les outils que l'agent est autorisé à appeler.
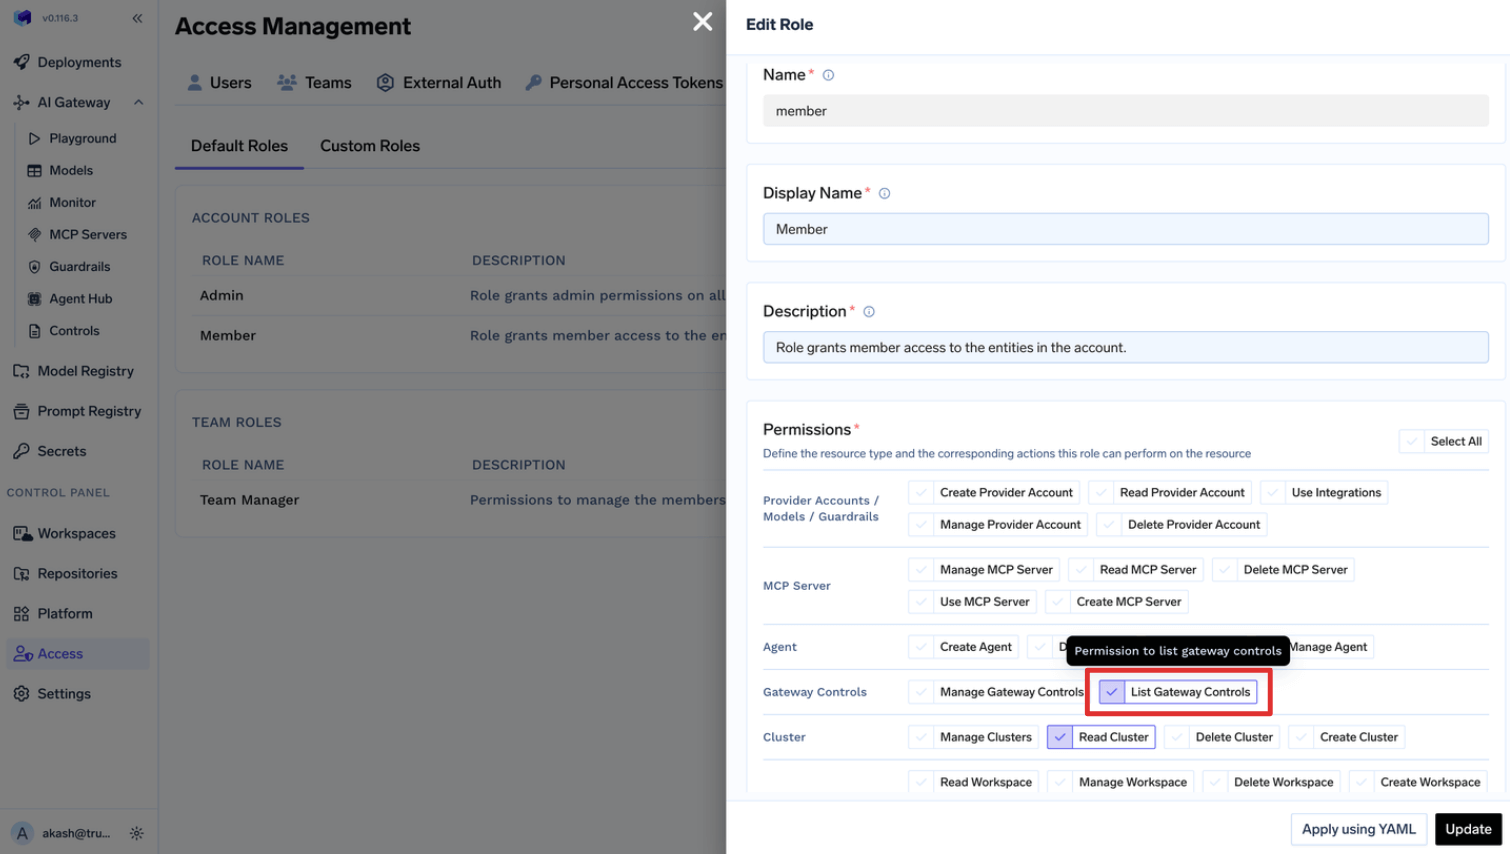
Autre parallèle : les autorisations des rôles personnalisés s'appliquent à toutes les ressources du type sélectionné, de la même manière qu'un ClusterRoleBinding s'applique à tous les espaces de noms. Pour une ressource spécifique, utilisez la page de contrôle d'accès de cette ressource. Il en va de même pour l'élargissement de la base de référence : l'ajout de gateway-controls:ListGatewayControls au rôle Membre l'accorde à tous les utilisateurs :
L'agent de la plateforme est une étude de cas sur la différence entre Role et ClusterRole. tfy-agent nécessite un ClusterRole et un ClusterRoleBinding pour exécuter des informers, car les informers Kubernetes ne peuvent pas surveiller un sous-ensemble d'espaces de noms ; il est donc en lecture seule et effectue un filtrage côté client. tfy-agent-proxy, qui effectue les écritures, est celui que vous pouvez restreindre : config.allowedNamespaces le fait passer à des RoleBindings par espace de noms, et tfyAgentProxy.clusterRole.strictMode: true le réduit à un ensemble minimal d'autorisations. C'est la règle générale en miniature.
Les droits se cumulent sur les deux couches, et la suppression de l'un n'entraîne pas la suppression de l'autre. Dans Kubernetes, l'accès effectif est l'union de toutes les liaisons correspondantes. Dans TrueFoundry, un sujet peut détenir un accès directement et l'hériter d'une équipe. Vérifiez toutes les sources avant de conclure qu'une suppression a échoué.
La modification d'un rôle d'équipe par défaut de la plateforme l'impacte pour toutes les équipes. Membre d'équipe et Responsable d'équipe sont modifiés sous Accès > Rôles par défaut, et la modification est globale. Ajouter virtual-account:ManageVirtualAccount pour qu'une équipe puisse récupérer des jetons lui accorde ce droit dans toutes les équipes. Kubernetes présente le même risque sous une forme différente : modifier un ClusterRole partagé l'impacte pour toutes les liaisons qui y font référence.
La plupart des problèmes de RBAC dans Kubernetes sont des problèmes de portée, et non de syntaxe. Deux types d'objets décrivent les permissions et deux autres les attribuent ; la compétence consiste à choisir le plus restreint quand le plus large est plus simple à saisir. Privilégiez le Role par espace de noms, le ClusterRole lié par un RoleBinding pour la réutilisation, et le ClusterRoleBinding uniquement lorsqu'un sujet a réellement besoin de l'ensemble du cluster. Liez des groupes, évitez les caractères génériques et vérifiez avec kubectl auth can-i.
Ce qu'il est facile d'oublier, c'est que tout cela ne répond qu'à une seule question. Tout ce que vos équipes font via une API de plateforme – déployer un modèle, appeler un outil MCP, lire un groupe de secrets – est invisible pour le RBAC du cluster et nécessite sa propre solution.
Sur TrueFoundry, il s'agit de deux couches sur la même infrastructure : partageant une limite car un espace de travail est un espace de noms, configuré indépendamment car ils régissent des objets différents. Un ingénieur plateforme a besoin des deux. L'erreur est de supposer que l'un couvre l'autre.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




C'est le mode d'autorisation qui détermine si une identité authentifiée peut exécuter un verbe sur une ressource via l'API server. Vous inscrivez les permissions dans un Role (limité à un namespace) ou un ClusterRole (à l'échelle du cluster), puis vous les associez à des sujets avec un RoleBinding (ce namespace uniquement) ou un ClusterRoleBinding (tout le cluster). Les règles sont additives, sans refus explicite, et tout ce qui n'est pas accordé est refusé.
Un Role est rattaché à un namespace et ne peut accorder des droits que sur des ressources de son propre namespace. Un ClusterRole a une portée de cluster et peut en outre accorder des droits sur des ressources de portée cluster, comme les nœuds et les volumes persistants, ainsi que sur des URL hors ressources comme /healthz. La différence pratique tient à la réutilisation : un ClusterRole est défini une fois et peut être lié à n'importe quel namespace avec un RoleBinding.
Oui, et c'est le modèle recommandé. Les permissions restent limitées au namespace du RoleBinding : vous définissez donc une capacité une seule fois et vous l'accordez équipe par équipe. L'inverse n'est pas autorisé : un ClusterRoleBinding ne peut jamais référencer un Role.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















