



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 8, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une étude majeure de 2026 sur la sécurité des agents LLM aboutit à une conclusion que les équipes en entreprise doivent prendre au sérieux : dès lors qu'un modèle peut utiliser des outils, conserver un état et agir au nom d'un tiers, la sécurité ne se résume plus au simple filtrage des prompts. Il s'agit désormais d'un problème systémique qui englobe les flux d'informations, les délégations d'autorité et les états persistants.
L'étude part d'un constat architectural simple : un agent LLM ne se contente pas de générer du texte. Il peut planifier, appeler des outils, naviguer sur le web, exécuter du code, mettre à jour des états et se coordonner avec d'autres agents. Ces capacités transforment les sorties du modèle en entrées pour le flux de contrôle logiciel.
Cela modifie la nature des défaillances. Une instruction malveillante dissimulée dans une page web peut influencer un futur appel d'outil. Un résultat d'outil corrompu peut servir de contexte à une décision ultérieure. Une entrée mémoire compromise peut persister au-delà de la session initiale. Un identifiant délégué peut transformer un plan malveillant en une action réelle. Dans un système multi-agents, une information contaminée peut se propager bien au-delà de l'agent qui l'a rencontrée en premier.
L'étude structure donc la sécurité des agents autour de trois propriétés interdépendantes :
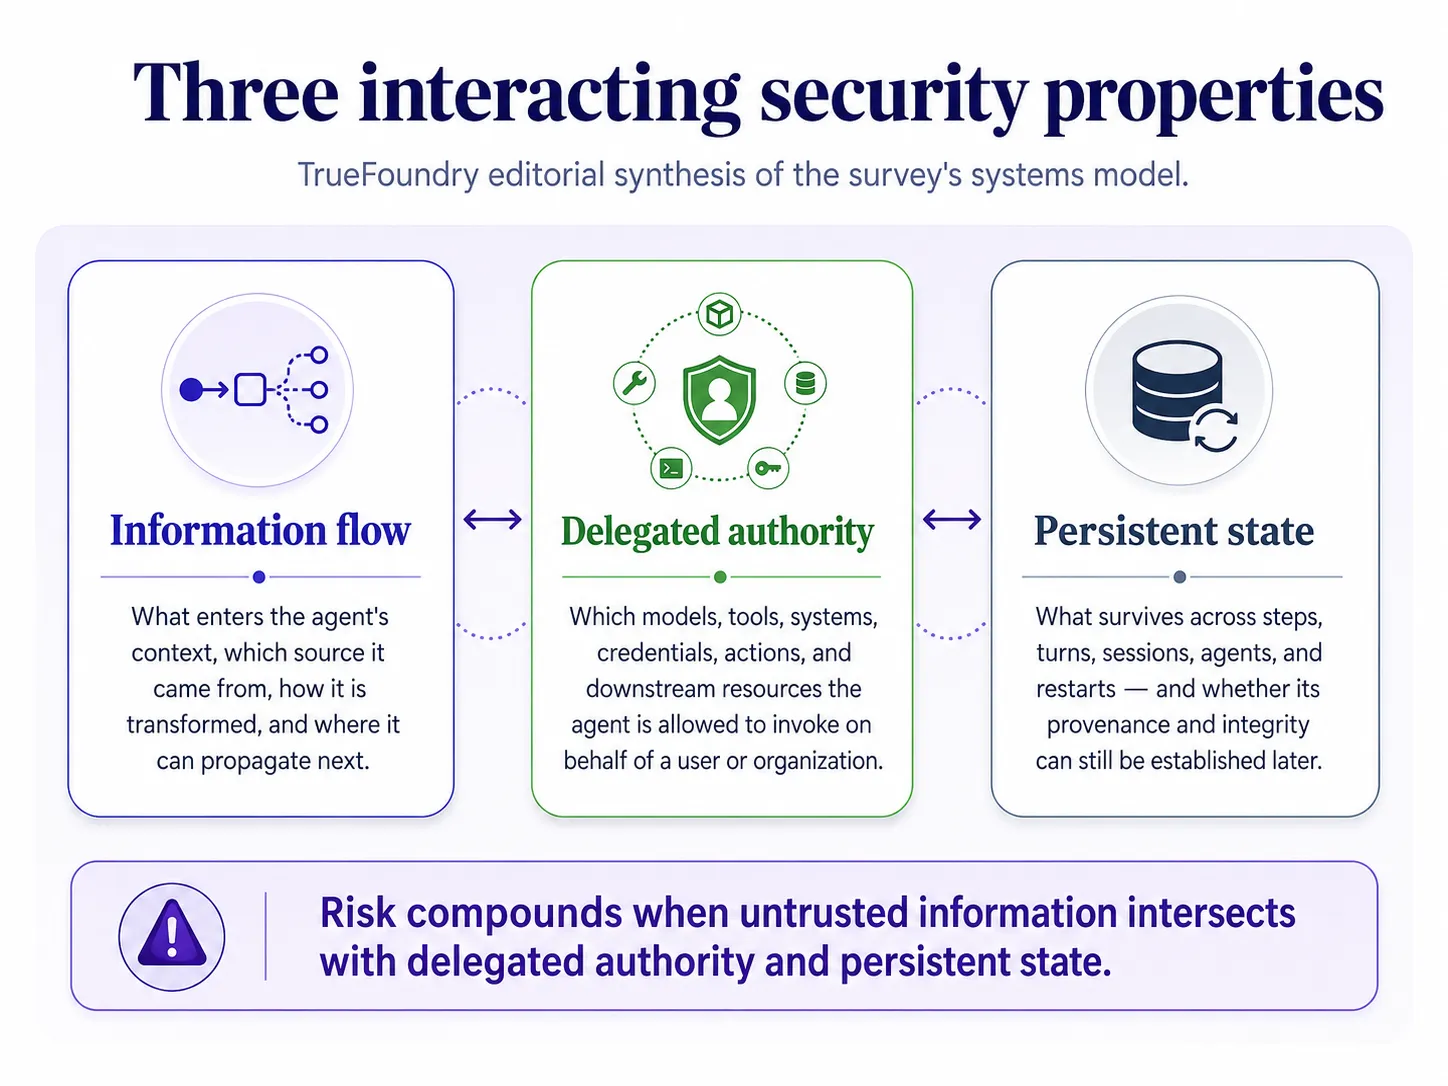
L'implication pratique est qu'une architecture d'agent sécurisée ne doit pas seulement se demander : « Avons-nous bloqué le prompt malveillant ? » Elle doit également poser les questions suivantes : quel contenu cela pourrait-il influencer, quelle autorité la trajectoire résultante pourrait-elle exercer, et quel état cette trajectoire pourrait-elle laisser derrière elle ?
Ling et ses coauteurs utilisent un cadre orienté système basé sur le cycle de vie plutôt qu'une simple liste de noms d'attaques. Sur le plan opérationnel, il est utile de distinguer le chemin d'action principal — entrée, planification, décision, exécution d'outil et sortie — des surfaces transversales telles que la mémoire, la surveillance et la coordination multi-agents, car ces surfaces peuvent influencer ou observer plusieurs étapes de l'exécution.
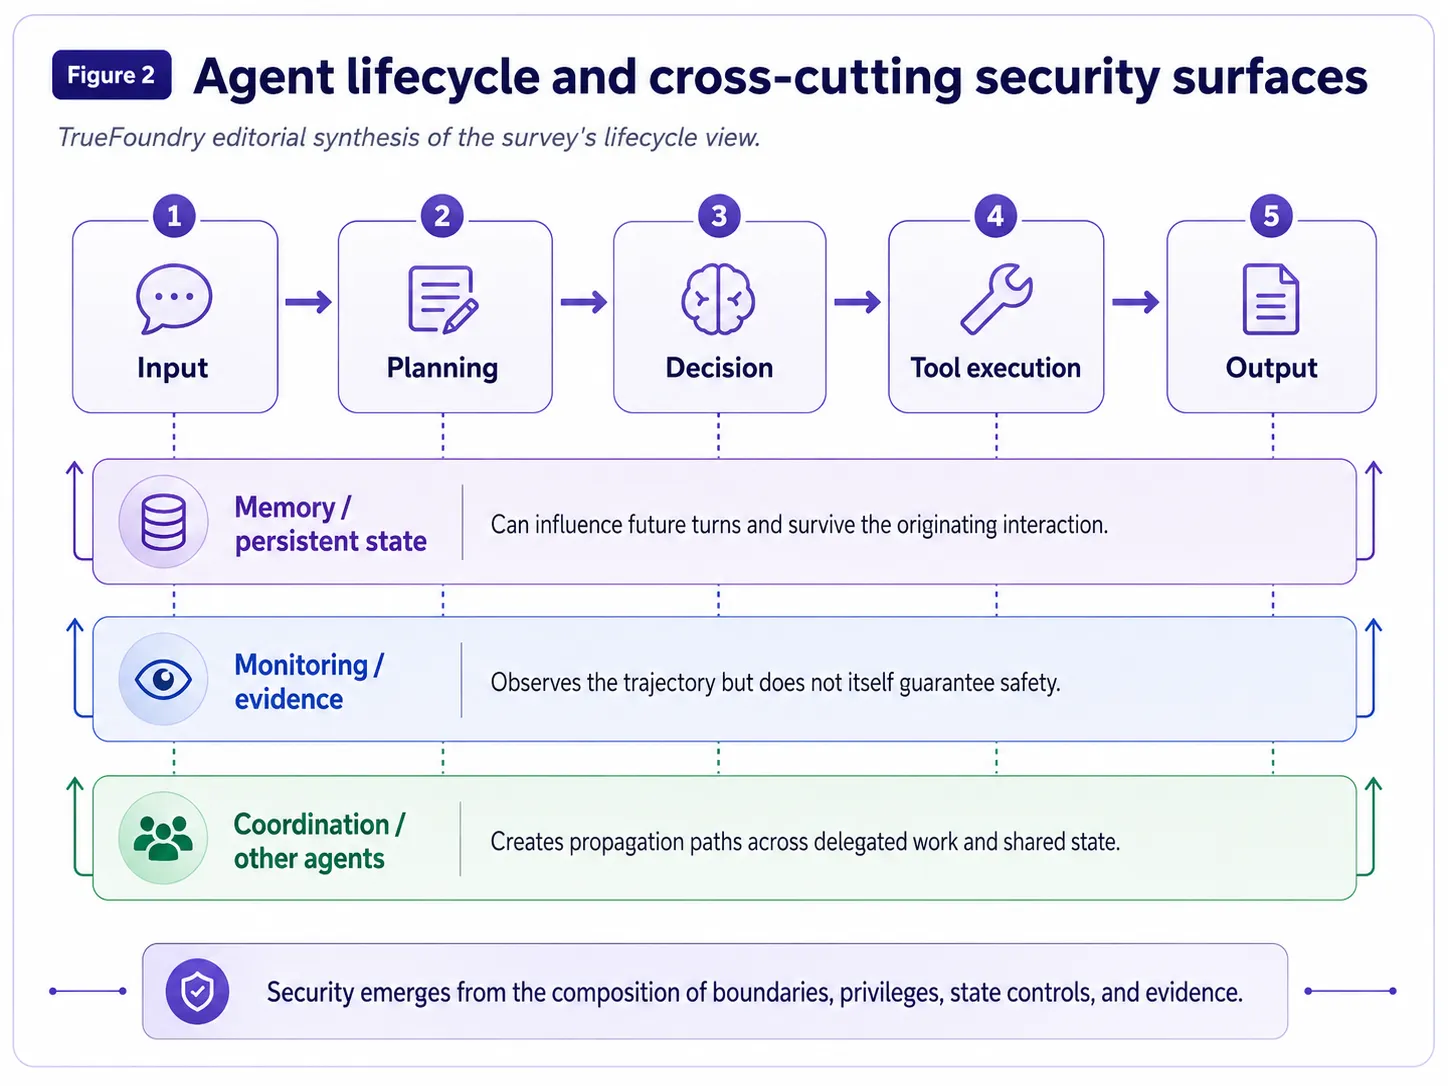
Cette perspective axée sur le cycle de vie explique également pourquoi les défenses peuvent être « faiblement compositionnelles », comme le souligne l'étude. Un filtre de contenu peut bloquer une catégorie de texte malveillant sans rien faire contre des identifiants aux privilèges excessifs. Un bac à sable peut contenir l'exécution de code sans empêcher un appel API autorisé. Une étape de validation peut stopper un effet secondaire sans empêcher une écriture mémoire empoisonnée. Une trace peut rendre un incident observable sans pour autant le prévenir.
La sécurité découle donc de la composition des frontières, des privilèges, des contrôles étatiques et des preuves.
La manière la plus pertinente de présenter le produit n'est pas de dire « TrueFoundry résout la sécurité des agents », mais plutôt de déterminer quelle partie du modèle de systèmes de l'étude chaque couche peut réellement régir.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















