



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Un juge est un modèle auquel on fournit trois éléments : une sortie à évaluer, une grille d'évaluation définissant ce qui est « bon », et une instruction pour renvoyer un verdict lisible par machine — succès/échec, un score ou une préférence entre deux candidats.
Il existe parce que l'alternative n'est pas scalable. Les métriques de correspondance exacte fonctionnent lorsqu'il n'y a qu'une seule bonne réponse ; elles sont inutiles pour une réponse de support où cinq réponses sont toutes correctes. Les humains les évaluent bien, mais lentement. Un juge se situe entre les deux : moins bon qu'un humain attentif, bien meilleur qu'une comparaison de chaînes de caractères, et assez rapide pour traiter des milliers d'échantillons. Considérez-le comme un proxy bon marché, bruyant et corrélé à l'humain.
L'erreur la plus courante consiste à traiter l'évaluation hors ligne et le filtrage en ligne comme une seule et même chose avec deux cibles de déploiement.
La ligne d'échec est celle qu'il faut intégrer. Hors ligne, un score erroné entraîne une décision que vous réexaminerez au prochain sprint ; en ligne, c'est un utilisateur confronté à une erreur. Ajustez donc un juge en ligne pour privilégier la précision, même au détriment du rappel. Copier une grille d'évaluation d'un mode à l'autre est le meilleur moyen pour une équipe de bloquer quelques pourcents de trafic valide.
Les juges sont efficaces pour des critères qui sont descriptibles mais non calculables — est-ce fondé sur le contexte récupéré, le ton est-il approprié pour un cadre clinique. Vous pouvez rédiger la règle dans un paragraphe, mais pas sous forme d'expression régulière. Ils échouent de trois manières.
Biais de position. Face à deux candidats, les juges favorisent une position ; inversez l'ordre et une part significative des verdicts change. La solution consiste à juger chaque paire deux fois en inversant les positions et à ne comptabiliser que les accords, ce qui double votre coût.
Biais de verbosité. Les réponses plus longues obtiennent de meilleurs scores, indépendamment du fait que les mots ajoutés apportent quelque chose ou non. Cela pousse discrètement les prompts de production vers le remplissage : vous optimisez en fonction du juge, le juge récompense la longueur, la facture de jetons augmente, et personne ne fait le lien entre les deux.
Auto-préférence. Un modèle note plus favorablement les textes qui ressemblent à ses propres générations. Si GPT juge la sortie de GPT, le score est biaisé — c'est l'argument le plus fort en faveur d'un juge issu d'une famille différente de celle du modèle testé.
Les juges sont également mal calibrés sur des échelles continues : demandez une note sur 10 et tout se concentre sur 7 et 8. Une évaluation binaire réussite/échec basée sur un critère strict est bien plus fiable. Et un juge ne peut pas vérifier un fait qu'il ne possède pas — sans matériel de référence, vous obtenez ses a priori, pas une vérification des faits.
Une famille différente de celle du modèle testé, car l'auto-préférence est réelle et facile à éviter. Plus petit que vous ne le pensez, car juger consiste à classer selon un long prompt, et non à raisonner. Fixé, pas flottant, car un alias de fournisseur qui se met à jour automatiquement déplace votre seuil de qualité sans modification de code. Et un p99 inférieur à celui qu'il contrôle, sinon le juge devient votre latence de queue.
Vient ensuite l'arithmétique. Un juge intégré est une seconde inférence ; vérifiez à la fois le prompt et la réponse et cela en fait deux. Ce n'est pas une surcharge que vous pouvez éliminer par l'ingénierie, la question est donc quelle part du trafic :
Si vous pouvez exprimer la règle sous forme de code, faites-le.
Elles intègrent des critères d'évaluation hors ligne directement dans le flux de requêtes. Une grille d'évaluation à dix dimensions, efficace lors d'un traitement par lots nocturne, devient un frein lent et imprévisible en production. Les critères d'évaluation en ligne doivent être uniques, binaires et formulés de manière suffisamment concise pour qu'un petit modèle puisse y répondre de façon cohérente.
Elles ne mesurent jamais la performance du juge. Il s'agit d'un modèle en production sans aucune évaluation propre. Étiquetez manuellement quelques centaines d'exemples réels et analysez séparément la précision et le rappel. Si vous ne pouvez pas déterminer le taux de faux positifs, vous ne pouvez pas savoir quelle proportion d'utilisateurs est pénalisée par votre garde-fou.
Elles activent le blocage sans transition. Un juge précis à 90 % bloquera une réponse pertinente sur dix dès sa mise en service. Auditez d'abord, examinez une semaine de traces, puis déployez.
Elles oublient les réponses en flux (streaming). Les jetons sont transmis au navigateur en continu, et un juge de sortie n'a rien à évaluer tant que le flux n'est pas terminé. La plupart des passerelles, TrueFoundry incluse, ignorent les garde-fous de sortie sur les requêtes en streaming.
TrueFoundry ne propose pas de produit d'évaluation. Pas de page d'évaluation, pas de jeux de données, pas de suivi d'expérimentation, pas d'interface de notation. L'évaluation hors ligne relève des plateformes conçues à cet effet, et le rôle de TrueFoundry consiste à exporter les traces via OpenTelemetry — des traces, et non des métriques OTEL, depuis cet écran. Pour un jeu de données noté et un classement, utilisez Braintrust, Arize ou un équivalent et configurez l'exportateur pour qu'il s'y connecte.
Ce que TrueFoundry implémente, c'est la partie en ligne : un juge agissant comme un garde-fou dans le flux de requêtes, dont le verdict, la latence et la consommation de jetons sont enregistrés sur la même trace que la requête qu'il a supervisée.
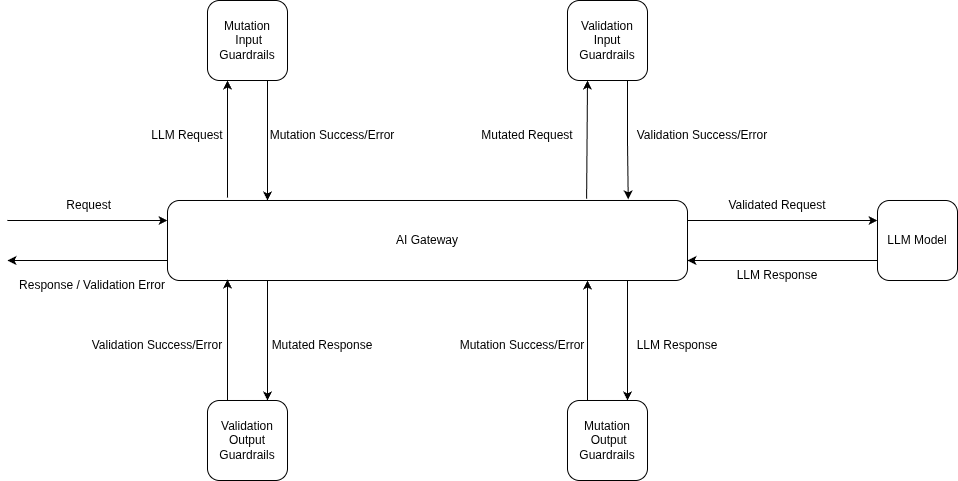
Flux d'exécution du garde-fou LLM : mutation de l'entrée, validation parallèle de l'entrée, appel du modèle, puis mutation et validation de la sortie
Chaque juge ci-dessous est un petit service que vous déployez, appelé par la passerelle en tant que garde-fou via le contrat custom-guardrail. Ce contrat comporte une règle qu'il est utile de retenir : Un code HTTP 2xx signifie que la barrière de sécurité a terminé son exécution et que la décision de politique se trouve uniquement dans le corps JSON. La documentation avertit qu'un statut « bloqué » signalé par un code HTTP 400 peut être interprété comme une erreur d'exécution et laisser passer la requête. Renvoyez un code 2xx avec verdict: false.
NeMo s'exécute en tant que wrapper FastAPI déployé sur TrueFoundry — aucun appel SDK NeMo natif depuis la passerelle, aucune modification du SDK client dans votre application. En interne, il utilise un petit LLM d'évaluation ainsi que Colang, un langage dédié, pour évaluer les prompts et les réponses via les rails self_check_input et self_check_output. Le référentiel se trouve dans le bundle Colang, où le fichier config/prompts.yml contient des exemples few-shot qui, dans la v1, détectent les jeux de rôle de type DAN, les tentatives d'« ignorer les instructions précédentes », l'extraction de prompts système et les marqueurs de contournement de politique.
Le détail qui compte sur le plan opérationnel : le LLM d'évaluation rappelle via la même passerelle TrueFoundry. Le fichier .env du wrapper contient TFY_BASE_URL, TFY_API_KEY et JUDGE_MODEL — l'exemple de la documentation utilise openai-main/gpt-4o-mini. Comme l'inférence de l'évaluateur constitue un trafic de passerelle, ses jetons, son coût et sa latence apparaissent dans les mêmes tableaux de bord que le reste, vous permettant ainsi de visualiser le coût des barrières de sécurité. Changer d'évaluateur se fait en une ligne : modifiez JUDGE_MODEL (la documentation indique openai-main/gpt-4o) et redéployez.
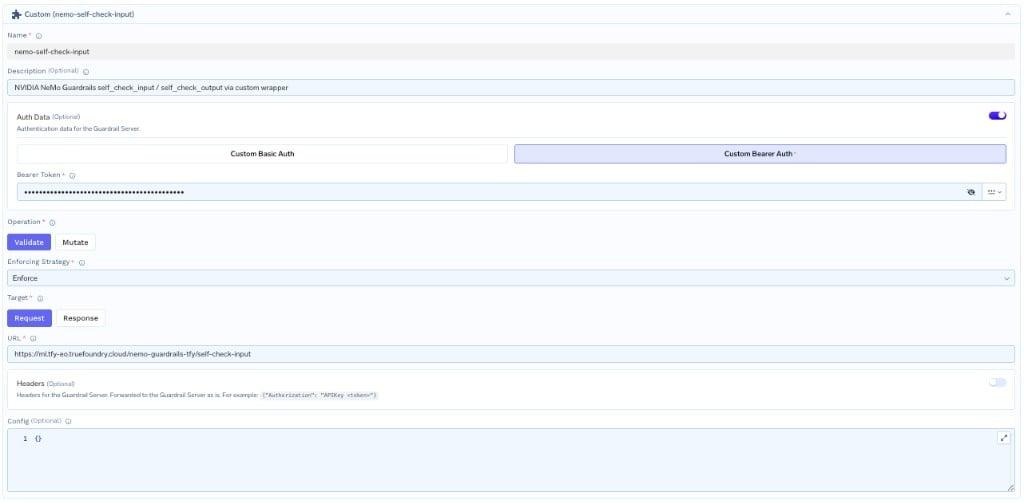
Enregistrement du rail d'auto-vérification NeMo en tant que configuration de barrière de sécurité personnalisée dans TrueFoundry
Enregistrez deux configurations de barrière de sécurité personnalisées, toutes deux de type Validate — avec les sélecteurs nemo-self-check/nemo-self-check-input et .../nemo-self-check-output — en recommandant l'option « Appliquer mais ignorer en cas d'erreur » (Enforce But Ignore On Error). Le contrat de verdict est minimaliste : HTTP 200 accompagné de {"verdict": bool, "message": Optional[str]} ; une défaillance réelle renvoie un code 5xx.
La passerelle répartit l'appel du rail d'entrée et l'appel du modèle en parallèle, de sorte que l'évaluateur n'augmente pas le temps jusqu'au premier jeton ; en cas de blocage, il annule l'appel du modèle en cours. Le rail de sortie s'exécute de manière séquentielle, car c'est nécessaire.
La documentation est transparente sur le prix. Concernant les limitations connues, pour reprendre leurs termes : chaque requête sécurisée ajoute un ou deux appels LLM, un par direction. Ils notent également qu'il n'existe pas de barrières de sécurité compatibles avec le streaming, car le contrat est mis en mémoire tampon, et que l'état en mémoire est propre à chaque réplique.
Patronus est ce qui se rapproche le plus d'un évaluateur clé en main dans le catalogue, et il est uniquement de type Validate — son fonctionnement est littéralement la « validation », et la documentation précise qu'il ne peut pas effectuer de mutation.
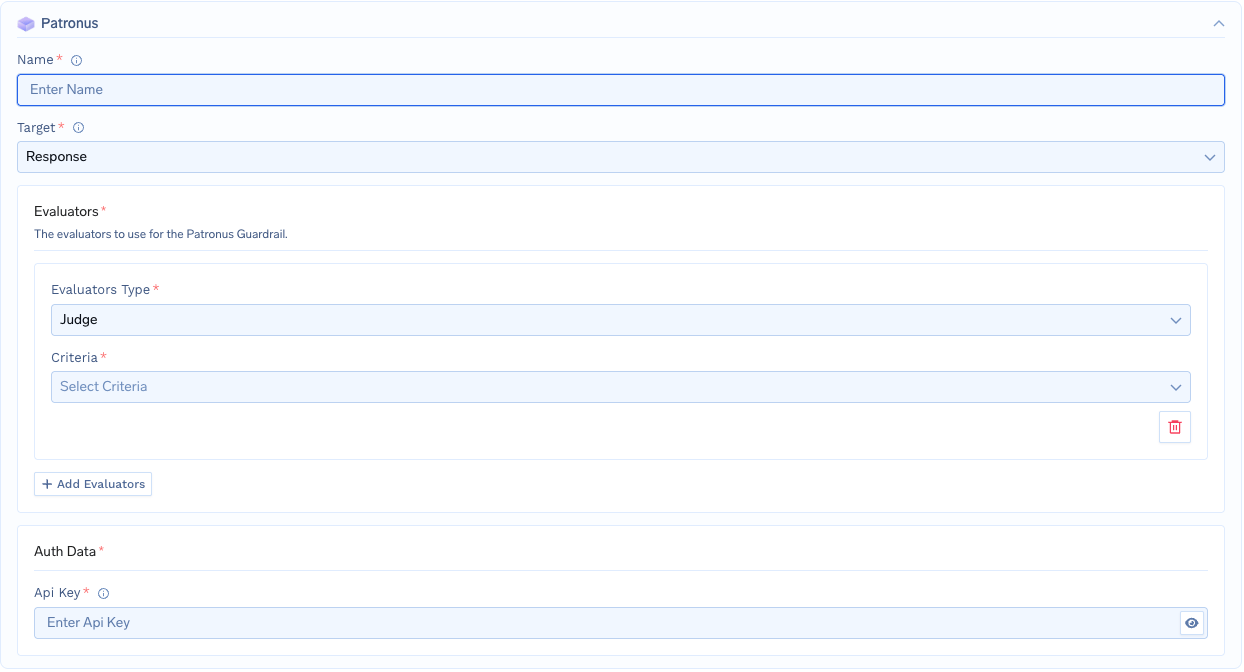
Configuration des garde-fous Patronus dans la passerelle IA TrueFoundry
Le type de configuration est integration/guardrail-config/patronus. Définissez la cible sur request ou response, puis listez les évaluateurs ; il en existe six types : answer-relevance, glider, judge, pii, phi, toxicity. Le type judge correspond à l'approche LLM-as-a-judge et son champ criteria est obligatoire. Voici les quinze valeurs documentées :
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Il s'agit d'utiliser un modèle de langage pour noter la sortie d'un autre selon une grille écrite, en renvoyant un verdict lisible par machine — réussite ou échec, une note, ou une préférence entre candidats. Cette approche existe parce que le texte libre n'a pas de métrique d'exactitude calculable, et il vaut mieux la considérer comme un substitut bon marché et bruité d'un évaluateur humain.
Pour des critères étroits, binaires et formulés avec précision, souvent oui ; pour des grilles de qualité larges, généralement non. Mesurez d'abord la précision et le rappel séparément sur des exemples étiquetés à la main — un juge exact à 90 % bloque environ une réponse légitime sur dix le jour où vous l'activez.
Au moins un appel de modèle supplémentaire par requête protégée, et deux si vous évaluez à la fois le prompt et la réponse — la documentation NeMo de TrueFoundry énonce explicitement ce calcul. Le seul levier est la couverture : échantillonnez pour la télémétrie et réservez la couverture complète aux vérifications qui ne doivent jamais rien laisser passer.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Environ 3 à 4 ms, en soutenant plus de 350 RPS sur un seul vCPU, sur plus de 1 000 LLM. Le temps des garde-fous est mesuré à part et rapporté aux P50, P75, P90 et P99.
Oui. La passerelle est conforme à OpenTelemetry et exporte les traces vers des backends externes ; c'est ainsi que les données de la passerelle parviennent à des plateformes telles que Braintrust, Langfuse ou Arize. TrueFoundry n'exécute pas lui-même de tâches de scoring hors ligne.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















