August 26, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les benchmarks des fournisseurs mesurent les performances optimales d'un modèle : harnais d'agents complets, conteneurs Docker, jeux de tests sélectionnés. Ce n'est pas ce dont la plupart des ingénieurs ont réellement besoin. La vraie question est de savoir si l'écart de qualité justifie l'écart de prix sur un appel d'API en production.
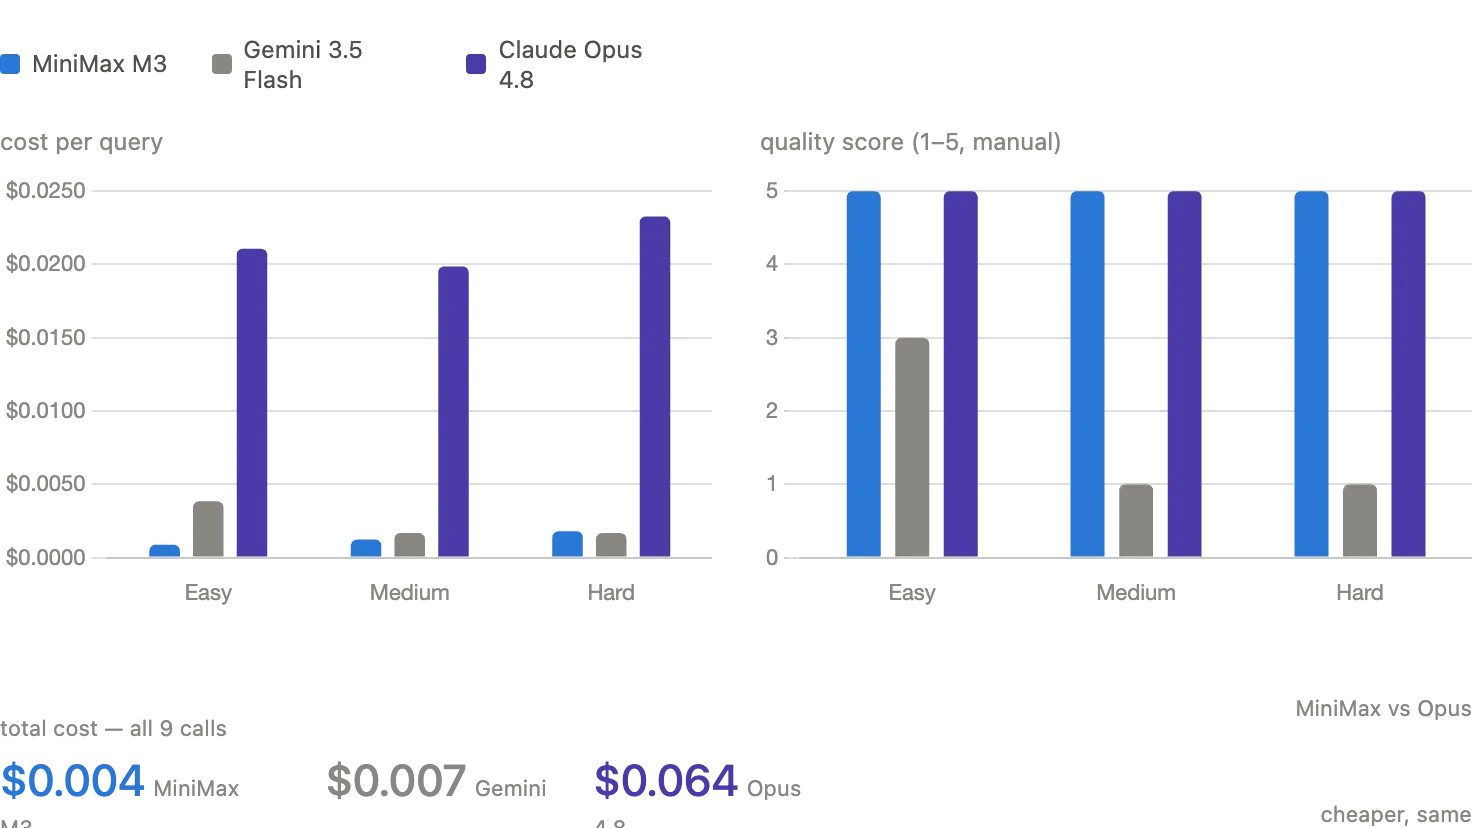
Nous avons testé MiniMax M3, Gemini 3.5 Flash et Claude Opus 4.8 via TrueFoundry AI Gateway sur un service de paiement Python de 130 lignes, avec trois tâches de revue de code de difficulté croissante. Coût total pour les neuf appels : 0,067 $. Les résultats ne sont pas ceux auxquels nous nous attendions.
La base de code contenait des problèmes délibérément introduits : un import time manquant qui ferait planter la logique de nouvelle tentative lors de la première limitation de débit, une clé d'API de production codée en dur, un argument par défaut mutable dans la fonction de facturation, l'absence de clé d'idempotence pour les tentatives, et aucune gestion d'erreur sur deux des quatre fonctions publiques.
Trois tâches, classées par difficulté :
Les neuf appels sont passés par le même point de terminaison TrueFoundry AI Gateway. Même URL de base, mêmes identifiants, chaîne de modèle différente. Nous avons évalué manuellement chaque réponse sur une échelle de 1 à 5 après une lecture complète, 5 signifiant que le modèle a détecté des problèmes non évidents et proposé des correctifs exploitables spécifiques à cette base de code. Pas de juge LLM : utiliser un LLM comme juge pour une tâche de revue de code biaise les résultats en faveur du modèle dont le style de sortie ressemble aux données d'entraînement du juge.
Gemini est le plus rapide avec une marge significative. MiniMax et Opus sont comparables en termes de latence.
Ce qui a marqué, c'est la profondeur du raisonnement, et non simplement le nombre de problèmes identifiés. Pour la tâche de niveau moyen, il ne s'est pas contenté de signaler des bugs isolés : il a retracé comment deux problèmes distincts s'aggravaient mutuellement, transformant ce qui semblait être un plantage en une défaillance silencieuse renvoyant un résultat erroné sans aucune indication d'anomalie. Pour le niveau difficile, il a élaboré un plan de refonte concret plutôt qu'une simple liste de problèmes. Pour le niveau facile, il a détecté un bug en production tout en répondant à une question sur la structure du code.
Égalise MiniMax sur les trois tâches. Il a détecté un problème que MiniMax a manqué : une vulnérabilité de sécurité causée par une entrée utilisateur non nettoyée transmise directement dans une URL. Les modèles de détection diffèrent, mais la qualité globale est équivalente.
La réponse pour le niveau facile était correcte mais générique. Les réponses pour les niveaux moyen et difficile étaient gravement incomplètes : la réponse moyenne s'est interrompue en milieu de phrase, et la difficile s'est terminée en plein milieu d'une expression sans pensée achevée. Qu'il s'agisse d'une troncature lors du streaming ou d'une réponse courte du modèle, votre application reçoit une réponse sans erreur, mais amputée de la majeure partie de son contenu. Les journaux de la passerelle TrueFoundry affichent le nombre de jetons pour chaque appel, ce qui permet de détecter ce problème avant qu'il n'atteigne les utilisateurs.
MiniMax M3 a égalé Opus pour un coût 16 fois inférieur (0,00390 $ contre 0,06422 $ sur neuf appels). Avec 10 000 requêtes par jour sur un contexte de 800 jetons, router les tâches standard vers MiniMax plutôt que vers Opus permet d'économiser environ 4 500 $ par mois.
Pour les tâches où une seule erreur peut avoir des conséquences asymétriques (revue de sécurité, logique de paiement, conformité), utilisez Opus. La détection de traversée de chemin par Opus est l'exemple concret de ce test : MiniMax ne l'a pas trouvée, Opus si. Sur un service de paiement en direct, ce n'est pas une lacune mineure.
Pour Gemini, utilisez-le là où l'exhaustivité de la réponse est vérifiable : classification, détection d'intention, résumé de documents courts. Ne l'utilisez pas sans supervision sur des tâches nécessitant une sortie exhaustive tant que le comportement de réponse incomplète n'est pas mieux compris.
La mise en place via TrueFoundry AI Gateway consiste en un changement de configuration : un modèle virtuel avec des règles basées sur la priorité qui classifie la tâche, l'achemine vers le niveau approprié et bascule automatiquement si un modèle est indisponible. La passerelle gère le routage LLM sur plus de 1 000 modèles via une API unique compatible avec OpenAI, ajoute environ 3 à 4 ms de surcharge à plus de 350 requêtes par seconde sur un seul vCPU, et enregistre le coût ainsi que le nombre de jetons de sortie par requête.
MiniMax M3 n'est pas un modèle économique avec des performances uniquement théoriques. Sur une base de code réelle, il a produit un résultat indiscernable de celui d'Opus 4.8 pour un coût 16 fois moindre. Le constat concernant Gemini est tout aussi important : un modèle qui produit des réponses incomplètes de manière silencieuse est plus dangereux en production qu'un modèle simplement plus lent, car vous ne pouvez pas voir la défaillance dans les journaux de votre application.
La question pratique n'est pas de savoir quel modèle remporte un benchmark, mais quelle stratégie de routage permet d'optimiser le compromis coût-qualité pour votre charge de travail réelle. Exécutez le benchmark sur votre propre base de code et définissez votre stratégie en fonction des résultats obtenus.
Explorer le routage LLM sur la passerelle IA de TrueFoundry
Qu'est-ce qu'une comparaison de modèles LLM et comment les équipes doivent-elles procéder ?
Une comparaison de modèles LLM évalue plusieurs modèles sur une même tâche, dans des conditions identiques : même prompt, même point de terminaison, même grille d'évaluation. Les comparaisons les plus pertinentes utilisent des tâches issues de votre charge de travail réelle. Routez tous les modèles via une passerelle partagée pour garantir des conditions d'infrastructure identiques pour chaque appel.
Comment MiniMax M3 se compare-t-il à Claude Opus 4.8 pour la revue de code ?
Sur les trois tâches que nous avons effectuées, MiniMax M3 a obtenu un score de 5/5 à chaque fois, pour un coût 16 fois inférieur à celui d'Opus 4.8 par requête. Opus a détecté un problème supplémentaire, une vulnérabilité de type traversée de chemin d'URL, que MiniMax a manqué. Les deux modèles ont identifié le bug d'idempotence, l'importation manquante, le problème de journalisation des données personnelles (PII) et l'argument par défaut mutable.
Qu'est-ce que le routage LLM et quand est-il utile ?
Le routage LLM dirige les requêtes vers différents modèles en fonction du type de tâche, de sa complexité, du coût ou des exigences de latence, plutôt que d'envoyer systématiquement tout vers un seul modèle. Router les tâches simples vers des modèles moins coûteux tout en réservant les modèles de pointe aux tâches critiques peut réduire les dépenses liées aux LLM de 60 à 80 %, sans perte de qualité sur les tâches à faible complexité. La passerelle IA de TrueFoundry prend en charge le routage LLM nativement : vous configurez un modèle virtuel avec des règles basées sur les priorités, et la passerelle gère automatiquement la sélection du modèle, les solutions de repli et le suivi des coûts.
Quelle latence la passerelle IA de TrueFoundry ajoute-t-elle ?
Environ 3 à 4 ms de latence. La passerelle gère plus de 350 requêtes par seconde sur un seul vCPU et est conçue pour s'intégrer au chemin critique sans devenir un goulot d'étranglement.
Puis-je déployer TrueFoundry dans mon propre VPC ?
Oui. TrueFoundry s'exécute dans votre VPC, sur site, en environnement isolé (air-gapped), hybride ou sur plusieurs clouds. Aucune donnée ne quitte votre domaine, ce qui est la raison principale pour laquelle les entreprises soumises à des réglementations le préfèrent aux passerelles exclusivement SaaS.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception