



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Demandez à trois équipes ce que fait leur routeur LLM et vous obtiendrez trois réponses qui ne se recoupent pas. La première exécute GPT-4o sur Azure et OpenAI et veut que son trafic survive à une panne. La deuxième a reçu sa facture et souhaite que 70 % des requêtes, les plus simples, soient traitées par une solution moins coûteuse. La troisième possède une filiale allemande dont les prompts ne doivent pas quitter l'UE. Toutes trois ont besoin d'une configuration différente, et deux d'entre elles ne tireraient aucun profit de ce que les autres ont construit.
Il est utile de définir cette taxonomie avec précision, car c'est ce que la plupart des contenus sur le routage LLM omettent :
L'indicateur clé est ce que chaque système analyse pour prendre sa décision. L'équilibrage de charge lit l'état de l'infrastructure, la sélection de modèle lit le corps de la requête, et le routage de données lit les métadonnées et l'identité. Trois entrées, donc trois fonctionnalités — qui se complètent plutôt qu'elles ne se concurrencent.
C'est le sens le plus ancien et le moins complexe du terme, ce qui en fait aussi le plus fiable. Vous disposez de plusieurs moyens d'accéder à la même capacité — azure/gpt-4o et openai/gpt-4o, ou deux déploiements dans des régions différentes — et vous souhaitez répartir les requêtes entre eux afin qu'aucune défaillance isolée ne devienne la vôtre.
Le principe est que chaque cible est équivalente en termes de précision. N'importe laquelle peut traiter la requête ; vous choisissez en fonction de la disponibilité, de la capacité et de la vitesse. C'est ce qui rend l'équilibrage de charge LLM sûr à automatiser. De plus, la latence des fournisseurs n'est pas assez stable pour être ignorée — elle varie selon le modèle, la région, le fournisseur et l'heure :
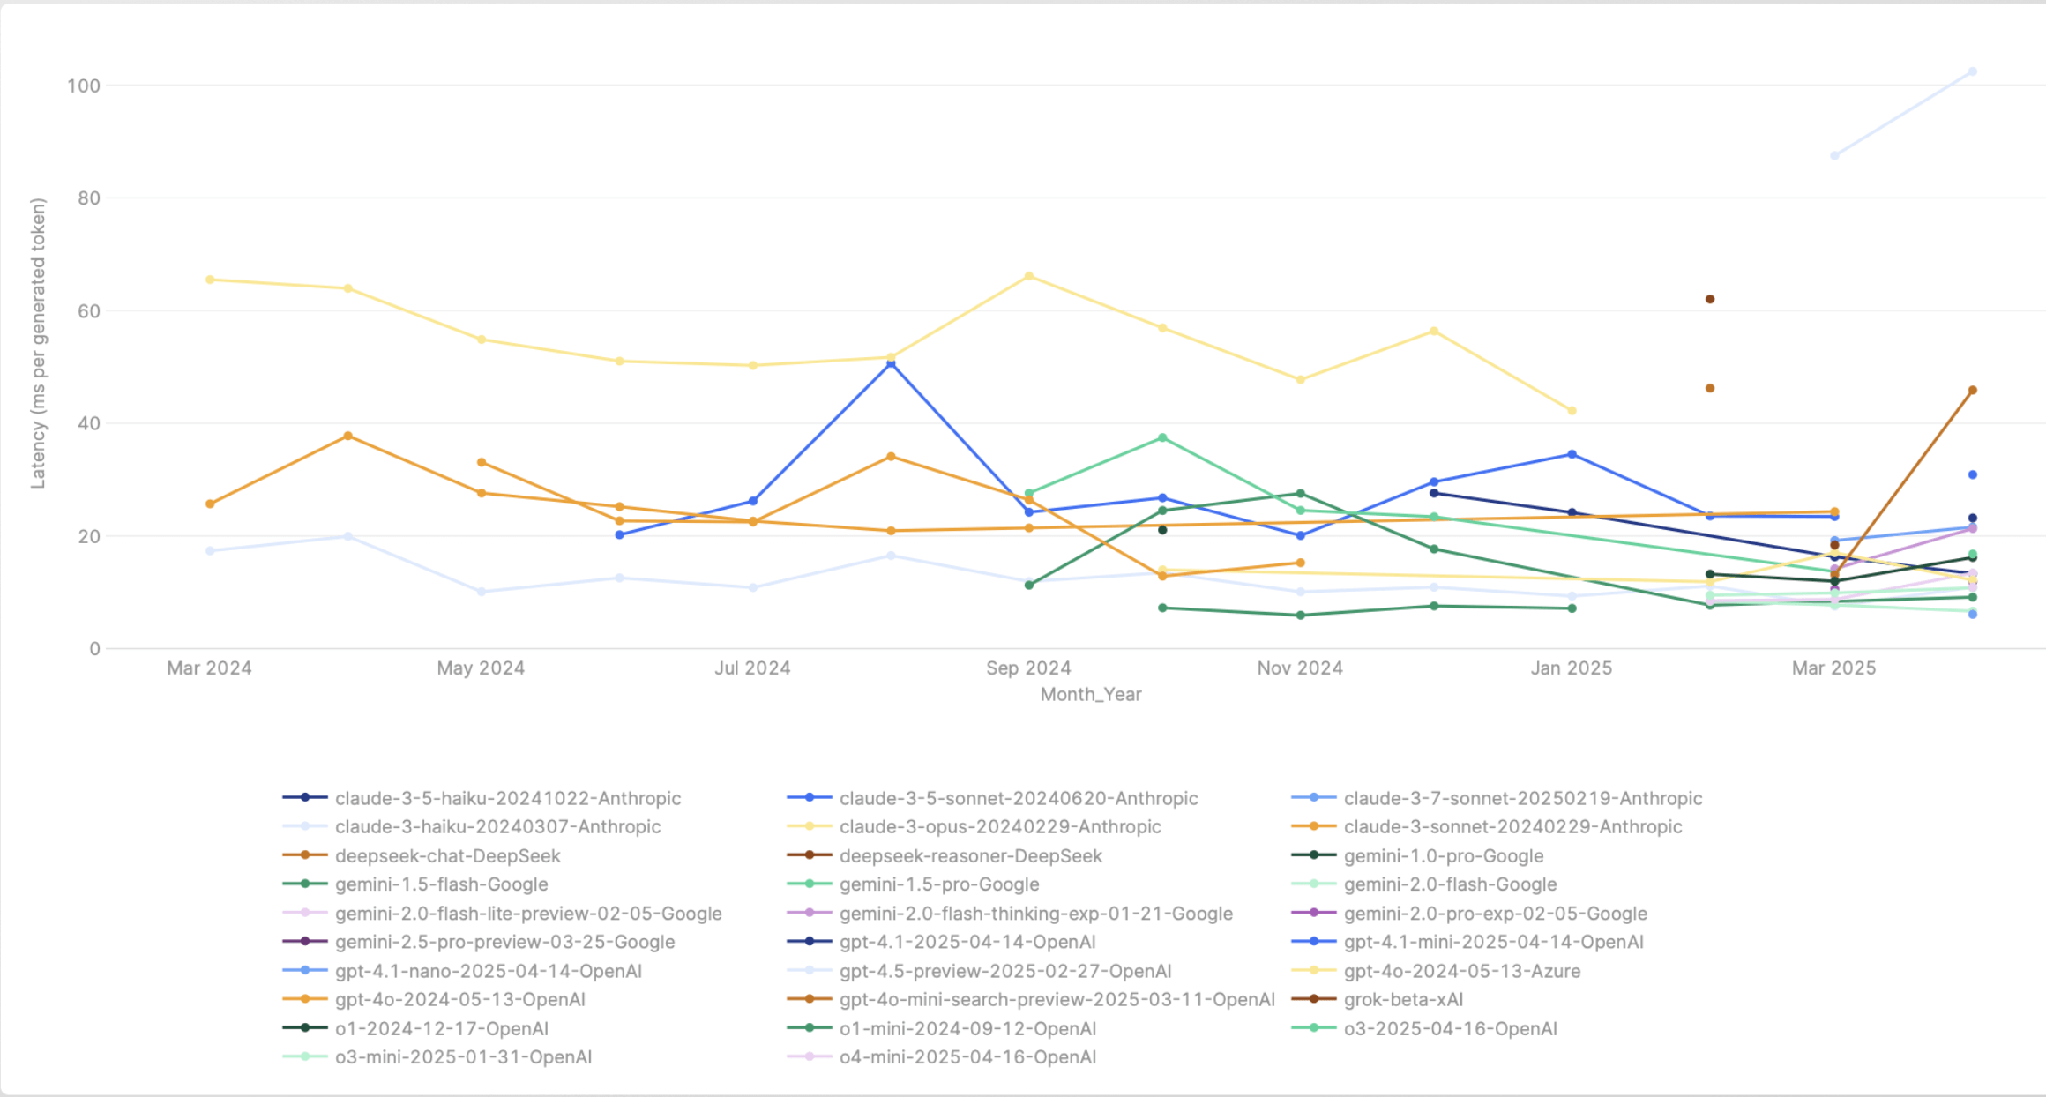
Graphique de la variance de latence mesurée chez plusieurs fournisseurs LLM sur un mois
TrueFoundry configure cela sur un modèle virtuel — un nom que votre application appelle, comme my-group/production-chat, avec une stratégie de routage et une liste de cibles réelles en arrière-plan. Trois stratégies qualifient l'équilibrage de charge :
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Un routeur LLM se place entre votre application et vos modèles et décide quel modèle ou quel déploiement traite chaque requête. Le terme recouvre trois missions distinctes : l'équilibrage de charge entre cibles interchangeables pour le débit et le basculement, la sélection de modèle entre un modèle moins cher et un modèle plus performant, et le routage des données, qui restreint l'endroit où une requête peut être traitée et où ses journaux sont stockés. Chacune s'appuie sur des entrées différentes : la première question est donc de savoir laquelle il vous faut.
Le routage par sélection de modèle, oui ; l'équilibrage de charge et le routage des données, généralement non. L'Auto Routing de TrueFoundry a été mesuré à 69 % d'économies avec 98 % de la qualité conservée sur 550 prompts évalués, et jusqu'à 80 % sur un trafic proche de la production. Les économies dépendent de la composition de votre trafic : ventilez la métrique des décisions de routage par niveau résolu et multipliez la part de chaque niveau par l'écart de prix.
Un routage basé sur la complexité sur un seul modèle virtuel avec le classifieur heuristique gratuit, car il ne nécessite ni modification de l'application ni dépense de classification. Ajoutez une chaîne de priorité entre deux fournisseurs dès qu'une panne vous a coûté quelque chose. Ajoutez le routage des données lorsque quelqu'un demande où vont les données.
Oui — en VPC, on-premise, en environnement air-gapped, en hybride ou sur plusieurs clouds, sans qu'aucune donnée ne quitte votre domaine.
Environ 3 à 4 ms de surcoût, en traitant plus de 350 RPS sur un seul vCPU, pour plus de 1 000 LLM pris en charge. L'exception est le classifieur LLM facultatif, qui ajoute un véritable appel de modèle avant le transfert de la requête.
Oui. La passerelle est conforme à OpenTelemetry et se connecte à Grafana, Datadog ou Prometheus. Chaque appel au classifieur LLM produit son propre span, de sorte que la latence du classifieur est visible séparément de celle du modèle servi.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















