



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les équipes en entreprise comparent Obot AI et LiteLLM lorsque leur pile technologique IA commence à dépasser le stade des appels directs aux modèles. LiteLLM est généralement le choix privilégié pour le routage multi-modèles, les clés virtuelles, le suivi des dépenses, les budgets et l'accès compatible avec OpenAI. Obot AI entre en jeu lorsque la gestion des serveurs MCP, la visibilité sur les clients IA, l'identité et la gouvernance des outils deviennent des priorités.
La vraie question n'est pas de savoir si un outil remplace l'autre dans tous les cas de figure. LiteLLM se concentre sur la couche proxy LLM. Obot AI se positionne davantage sur la gouvernance MCP et la gestion de l'écosystème IA en entreprise. Une équipe qui utilise déjà LiteLLM sans difficulté n'a aucune raison technique de changer. Une équipe submergée par des serveurs MCP non gérés sur les ordinateurs des développeurs n'a aucune raison de rester sur sa solution actuelle.
TrueFoundry devient pertinent lorsque les équipes ont besoin de centraliser la gouvernance du routage de modèles, des outils MCP, des flux de travail des agents, des budgets, des garde-fous et des journaux d'audit, ce qui correspond généralement au moment où deux passerelles open source commencent à ressembler à deux projets de conformité distincts.
Une comparaison utile entre LiteLLM et Obot AI doit commencer par l'objectif de migration. Certaines équipes souhaitent remplacer un serveur proxy. D'autres veulent ajouter une gouvernance MCP autour des agents, des outils de développement et des clients IA internes. Il s'agit de démarches d'achat différentes.
La différence majeure réside dans l'approche initiale de chaque projet. La configuration de LiteLLM décrit principalement les modèles et les règles pour y accéder. Le catalogue d'Obot commence par les serveurs MCP et les politiques définissant qui peut y accéder. Les deux projets ont depuis étendu leur périmètre pour couvrir le domaine de l'autre.
LiteLLM fournit désormais une API unique pour plus de 140 intégrations, ainsi que des fonctionnalités de gestion budgétaire, de routage, de garde-fous et de suivi d'utilisation. Son architecture de passerelle LLM reste un cadre naturel pour comparer le routage conscient des modèles avec une approche proxy générale. LiteLLM positionne désormais son produit comme une passerelle IA couvrant le trafic LLM, MCP et celui des agents.
Les deux passerelles disposent d'une version open source gratuite, le prix du logiciel seul ne permet donc pas une comparaison complète. Le coût de possession inclut également l'infrastructure, l'observabilité, la gestion des identités, les mises à jour et les opérations de la passerelle.
L'offre OSS de LiteLLM couvre plus de 140 fournisseurs, la gestion des utilisateurs et des équipes, les budgets, la limitation de débit, les solutions de secours, la journalisation des requêtes et les métriques Prometheus. La tarification entreprise est basée sur la capacité annuelle de requêtes de la passerelle, l'architecture de déploiement et les besoins en support. L'offre entreprise ajoute le SSO, le SCIM, l'authentification OIDC ou JWT, les journaux d'audit, les gestionnaires de secrets, le support multi-région et les SLA de service.
Cela rend LiteLLM plus facile à évaluer lorsque les équipes connaissent déjà leur volume de requêtes attendu. L'analyse de tarification de LiteLLM par TrueFoundry fournit un contexte supplémentaire concernant l'infrastructure et le coût total de possession (TCO) en entreprise.
Obot propose également une version gratuite. Son modèle actuel prend en charge jusqu'à 100 utilisateurs et appareils par défaut. La version Community conserve ces limites tout en ajoutant des options d'identité telles que Microsoft Entra, Okta, JumpCloud et Auth0. La version Enterprise supprime ces limites et inclut un support formel.
La comparaison doit donc inclure l'hébergement, les bases de données, le stockage pour l'observabilité, la gestion des clés, les exigences de conformité et l'effort d'ingénierie. LiteLLM nécessite PostgreSQL pour des fonctionnalités telles que les clés virtuelles. Obot nécessite une infrastructure pour la passerelle et les charges de travail MCP hébergées.
Pas tout à fait. Obot prend en charge un accès significatif aux modèles, bien que LiteLLM reste davantage axé sur le routage entre différents fournisseurs.
LiteLLM fournit une interface unifiée pour de nombreux fournisseurs de LLM. Les applications utilisent une URL de base de passerelle, une clé et un nom de modèle configuré. Le routage permet de répartir le trafic entre les fournisseurs, les régions et les identifiants, tout en appliquant des mécanismes de secours et de contrôle des coûts.
La passerelle LLM d'Obot suit un modèle différent. Elle expose des points de terminaison compatibles avec les fournisseurs pour les modèles OpenAI et Anthropic, des points de terminaison de réponses génériques, AWS Bedrock et Azure. Une clé API Obot avec une portée de proxy LLM remplace les identifiants directs des fournisseurs.
Les administrateurs appliquent ensuite des politiques d'accès aux modèles pour contrôler les modèles que chaque utilisateur final peut voir et appeler. La liste des modèles renvoyée ne contient que les choix approuvés. La passerelle conserve les identifiants en amont au sein d'Obot plutôt que de les distribuer entre les applications.
Obot peut également configurer Google Vertex comme fournisseur ailleurs sur la plateforme. Cependant, les routes de passerelle spécifiques aux fournisseurs externes actuels n'exposent pas Google Vertex.
LiteLLM reste le meilleur point de départ lorsque le basculement entre fournisseurs et le routage des requêtes sont les facteurs déterminants. Obot est plus pertinent lorsque la gouvernance d'entreprise concernant les utilisateurs, les agents, les modèles et les systèmes MCP est prioritaire.
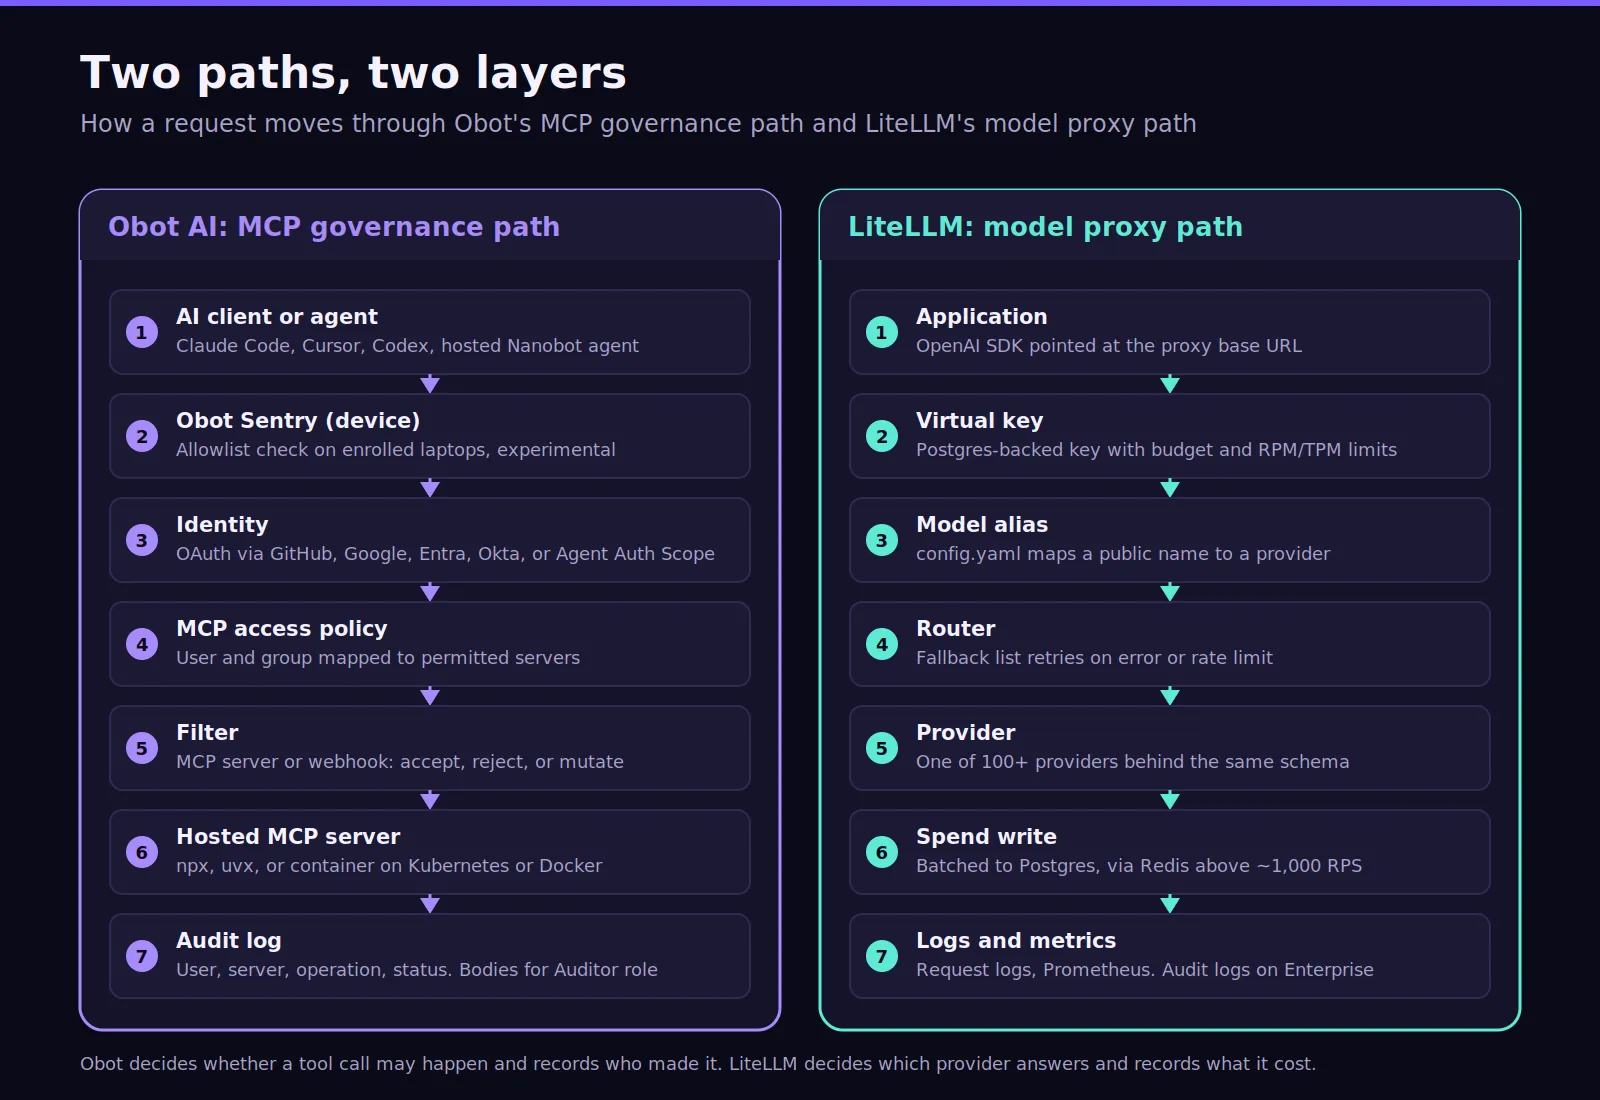
LiteLLM est le plus performant lorsque les applications génèrent principalement du trafic LLM. La décision change lorsqu'un agent IA commence à appeler des outils, à récupérer des données sensibles ou à agir sur les systèmes de l'entreprise. Le routage des modèles devient alors une couche de contrôle parmi d'autres.
LiteLLM mérite d'être reconnu ici, car ses capacités actuelles sont plus étendues que ce que suggèrent les anciennes comparaisons. Sa couche MCP présente un point de terminaison fixe pour les serveurs enregistrés. Les clients s'authentifient en utilisant le même modèle d'identifiants de passerelle, tandis que l'accès peut être attribué par clé ou par équipe.
La passerelle LiteLLM sépare également l'authentification client des flux OAuth en amont. Cela permet aux identifiants de la passerelle de rester distincts des identifiants OAuth côté serveur. Les outils de codage tels que Claude Code peuvent se connecter à la fois au routage de modèles de LiteLLM et aux points de terminaison MCP.
Obot va plus loin dans les opérations MCP. Son Passerelle MCP point de comparaison réside dans l'hébergement et la profondeur des politiques. Obot peut exécuter des charges de travail MCP via npx, uvx, en conteneur ou à distance, tout en imposant l'authentification et l'autorisation.
Les politiques d'accès d'Obot associent les serveurs approuvés à des utilisateurs ou à des groupes de fournisseurs d'identité spécifiques. Des filtres peuvent inspecter les appels d'outils individuels, puis accepter, rejeter ou modifier les requêtes avant qu'elles ne soient traitées. Des filtres personnalisés peuvent prendre en charge des contrôles tels que le masquage des données personnelles (PII) si nécessaire.
Obot Sentry étend également la gouvernance aux outils d'IA locaux. La gestion des appareils permet d'inventorier l'activité de Claude Code, Codex, Cursor et VS Code. Cela crée une intégration plus profonde lorsque l'activité locale des développeurs doit apparaître aux côtés des événements de la passerelle.
L'observabilité constitue une autre distinction pratique entre LiteLLM et Obot AI. Chaque plateforme observe la couche qu'elle gouverne principalement.
LiteLLM suit les dépenses, les budgets, l'utilisation par clé ou par équipe, le comportement des requêtes, les résultats des fournisseurs et l'activité de la passerelle. Il peut attribuer l'utilisation des jetons entre les clés, les utilisateurs, les équipes, les organisations, les outils, les agents et les charges de travail MCP.
Obot se concentre davantage sur les requêtes MCP, l'activité des clients locaux, les appels de modèles, les appareils et la gouvernance de la plateforme. Son système d'audit corrèle l'activité entre les serveurs MCP, les fournisseurs de modèles, les charges de travail hébergées et les appareils des utilisateurs. Les administrateurs peuvent filtrer l'activité par utilisateur, serveur, outil, fournisseur, modèle, client, appareil ou session.
Pour les équipes de plateforme, la différence est importante. L'observabilité des modèles répond à la question de savoir quel modèle a été appelé et quel en a été le coût. L'observabilité MCP répond à la question de savoir quelle identité a accédé à quel outil et ce qui s'est passé ensuite.
TrueFoundry l'analyse de l'observabilité de la passerelle explique comment la latence des modèles, les erreurs, les dépenses, les politiques et les traces peuvent être corrélées au niveau de la couche passerelle.
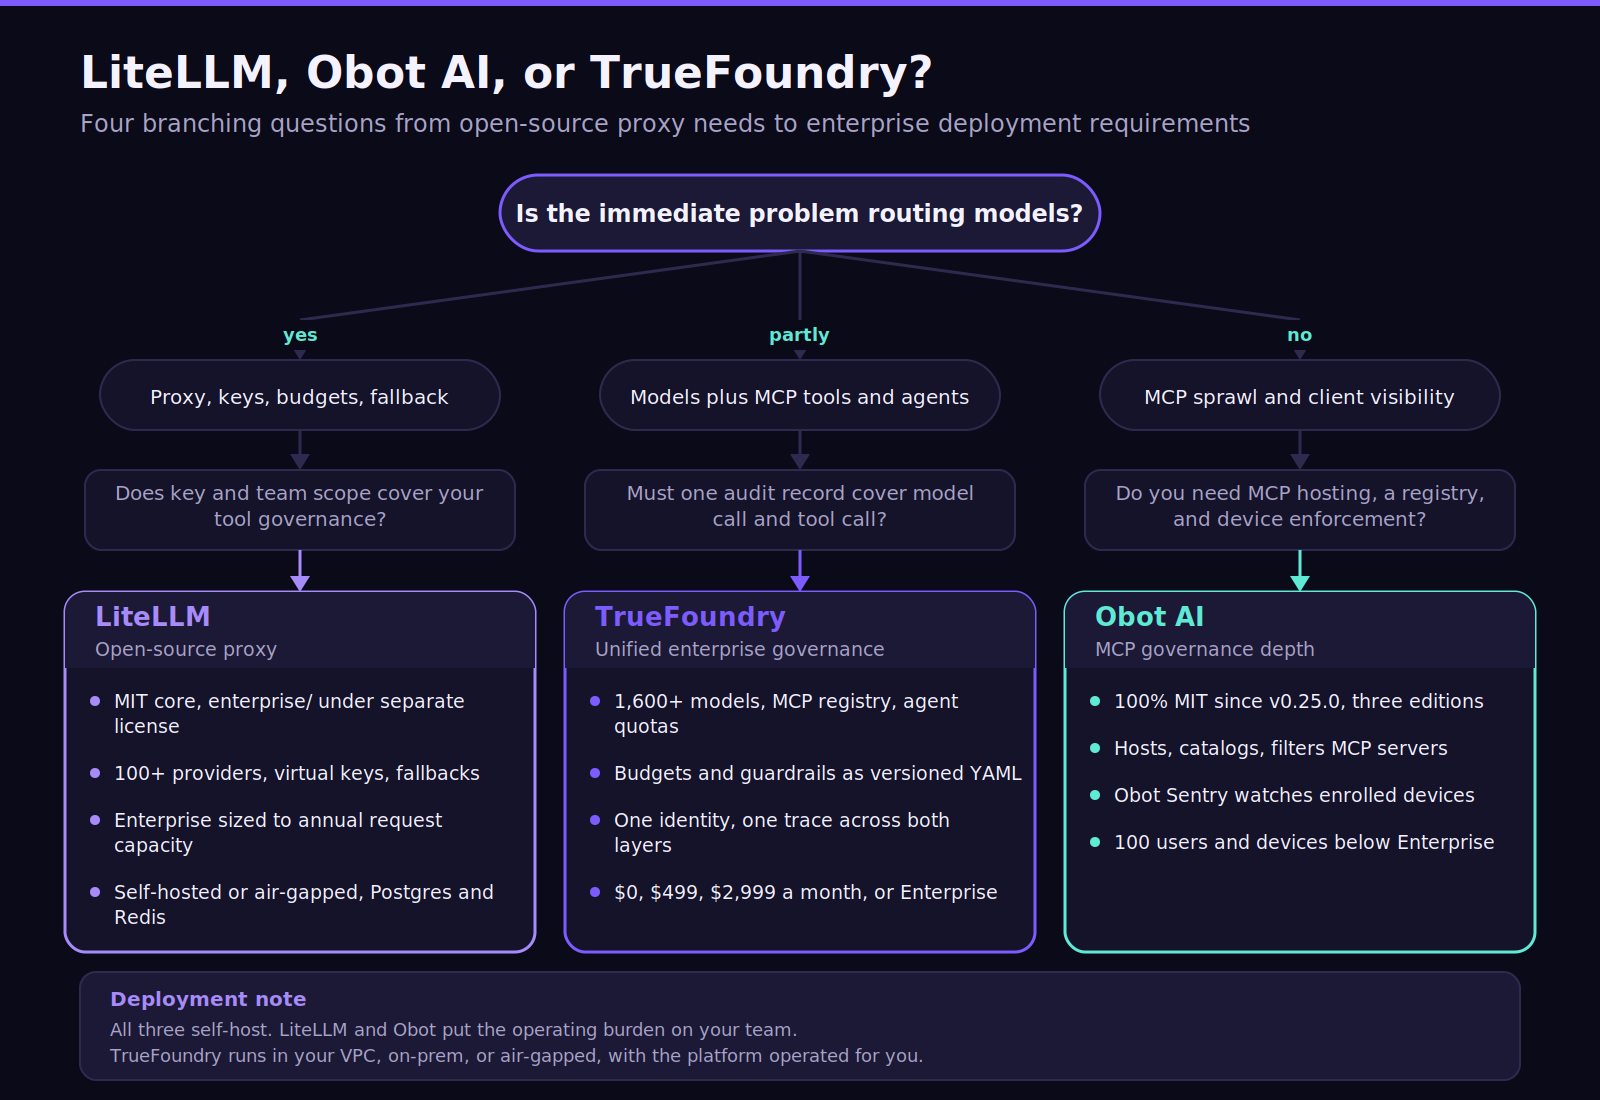
La migration d'un proxy est rarement l'étape la plus difficile. Le véritable défi réside dans la migration des hypothèses déjà intégrées au code de l'application. Avant de procéder, les équipes doivent vérifier :
Trois points nécessitent une attention particulière. Les applications LiteLLM peuvent utiliser des alias publics, tandis qu'Obot attend des noms natifs des fournisseurs pour les routes de passerelle prises en charge. Cela signifie que les identifiants de modèle peuvent entraîner un travail de migration sur les applications en production.
LiteLLM intègre également un comportement de secours qui ne correspond pas directement au modèle d'accès aux modèles d'Obot. Les variables d'environnement contenant les paramètres et les identifiants des fournisseurs peuvent nécessiter des mises à jour à mesure que les responsabilités sont transférées entre les passerelles.
Les modèles clés diffèrent également. LiteLLM utilise des identifiants de passerelle incluant des budgets et des accès. Obot peut émettre des identifiants à portée limitée via l'API Obot, tandis qu'un jeton Obot peut authentifier les flux de travail clients pris en charge. Ces modèles d'autorisation ne correspondent pas de manière biunivoque.
Les équipes peuvent donc conserver LiteLLM pour les modèles tout en ajoutant Obot pour le MCP. Une autre option se présente lorsque les flux de travail des agents nécessitent des politiques sur les deux couches. TrueFoundry Agent Gateway fournit des quotas de flux de travail, des traces et une identité centralisée pour les agents autonomes.
TrueFoundry sert de couche de consolidation pour l'entreprise. Sa passerelle d'IA d'entreprise assure le routage, l'observabilité, les garde-fous, la gestion budgétaire, l'application des politiques et la gouvernance des modèles. Elle peut être déployée via un modèle SaaS ou sous le contrôle du client.
La plateforme prend en charge le routage des fournisseurs, le basculement, la limitation de débit et la visibilité des coûts sur plus de 1 600 modèles. Les politiques peuvent également être définies au format YAML, permettant aux équipes de gérer la gouvernance via le contrôle de version plutôt que de maintenir des contrôles indépendants au sein des applications.
Les politiques budgétaires permettent de limiter l'utilisation par utilisateur, équipe, application, modèle ou environnement. Cela garantit une application en temps réel avant que des appels LLM coûteux ne se poursuivent.
name: budget-limiting-configtype: gateway-budget-configrules: - id: 'coding-agents-daily' when: subjects: ['team:platform'] metadata: environment: 'production' limit_to: 200 unit: cost_per_day budget_applies_per: ['user'] alerts: thresholds: [75, 90, 100] notification_target: - type: slack-bot notification_channel: 'budget-alerts-channel' channels: ['#ai-spend']Dès que le seuil de 200 $ par jour est dépassé, la passerelle répond par une erreur 429 contenant `error_origin_level: rate_limit_budget`, avec l'ID de la règle enfreinte dans l'en-tête `x-tfy-applied-rules`. Le mode audit permet de suivre la même règle sans bloquer les appels, ce qui constitue une méthode sécurisée pour introduire un plafond auprès d'une équipe qui n'en a jamais eu.
La passerelle MCP régit l'accès aux outils via un registre central, un contrôle d'accès basé sur les rôles (RBAC) par serveur, la gestion des jetons OAuth 2.0 avec rafraîchissement automatique, et des serveurs MCP virtuels qui exposent un sous-ensemble d'outils sélectionnés provenant de plusieurs serveurs sous un point de terminaison unique, sans nécessiter de nouveau déploiement. Des garde-fous sont appliqués aux appels d'outils MCP dans le même fichier de politique que celui régissant les appels LLM :
name: guardrails-controltype: gateway-guardrails-configrules: - id: github-tools-pii when: target: operator: or conditions: mcpServers: values: - github-mcp condition: in subjects: operator: and conditions: in: - team:platform llm_input_guardrails: [] llm_output_guardrails: [] mcp_tool_pre_invoke_guardrails: - pii/pii-detection mcp_tool_post_invoke_guardrails: []La couche MCP connecte la gouvernance des modèles à l'accès aux outils, plutôt que de traiter les outils comme une simple préoccupation applicative. L'identité fédérée, le RBAC, OAuth 2.0, l'observabilité et l'enregistrement des serveurs prennent en charge les charges de travail MCP en entreprise.
TrueFoundry constitue donc une option de plateforme unique là où des produits distincts de proxy et de MCP créeraient des politiques en double. Les équipes peuvent également comparer directement cette architecture via le comparatif TrueFoundry vs LiteLLM.
Choisissez TrueFoundry lorsque :
TrueFoundry propose actuellement une offre Developer à 0 $ par mois, Pro à 499 $ par mois, Pro Plus à 2 999 $ par mois, ainsi qu'une tarification Enterprise personnalisée. L'offre Enterprise prend en charge les déploiements de passerelles et de plans de contrôle en VPC et en environnement isolé (air-gapped).
Choisissez LiteLLM lorsque le besoin immédiat concerne l'accès aux modèles, le routage des fournisseurs, les budgets, les basculements et le suivi des dépenses. Cela reste un candidat solide lorsque les charges de travail en production nécessitent principalement une passerelle consciente des modèles.
Choisissez Obot AI lorsque la gouvernance MCP, la visibilité sur les clients IA, l'hébergement de serveurs, les politiques d'accès aux modèles et les contrôles basés sur l'identité sont les facteurs déterminants. Cette solution est adaptée aux équipes confrontées à la prolifération du MCP et aux connexions d'outils de développement non gérées.
Choisissez TrueFoundry lorsque vos modèles, outils, agents, budgets, garde-fous et capacités d'observabilité nécessitent une architecture de gouvernance unifiée. Cette approche offre un contrôle total sur les multiples couches de l'IA sans avoir à gérer des systèmes de politiques distincts.
Le choix entre Obot AI et LiteLLM revient donc à déterminer votre couche de démarrage. La bonne réponse dépend de la contrainte opérationnelle immédiate : le routage des modèles ou la gouvernance MCP.
Les équipes envisageant une autre passerelle API, comme Kong Gateway ou Kong AI Gateway, devraient évaluer cette catégorie séparément. Ces plateformes se concentrent initialement sur des problématiques plus larges de gestion du trafic IA et des API.
Réservez une démo gratuite dès aujourd'hui pour découvrir comment TrueFoundry connecte la gouvernance des modèles, du MCP et des agents au sein des environnements de production.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















