



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
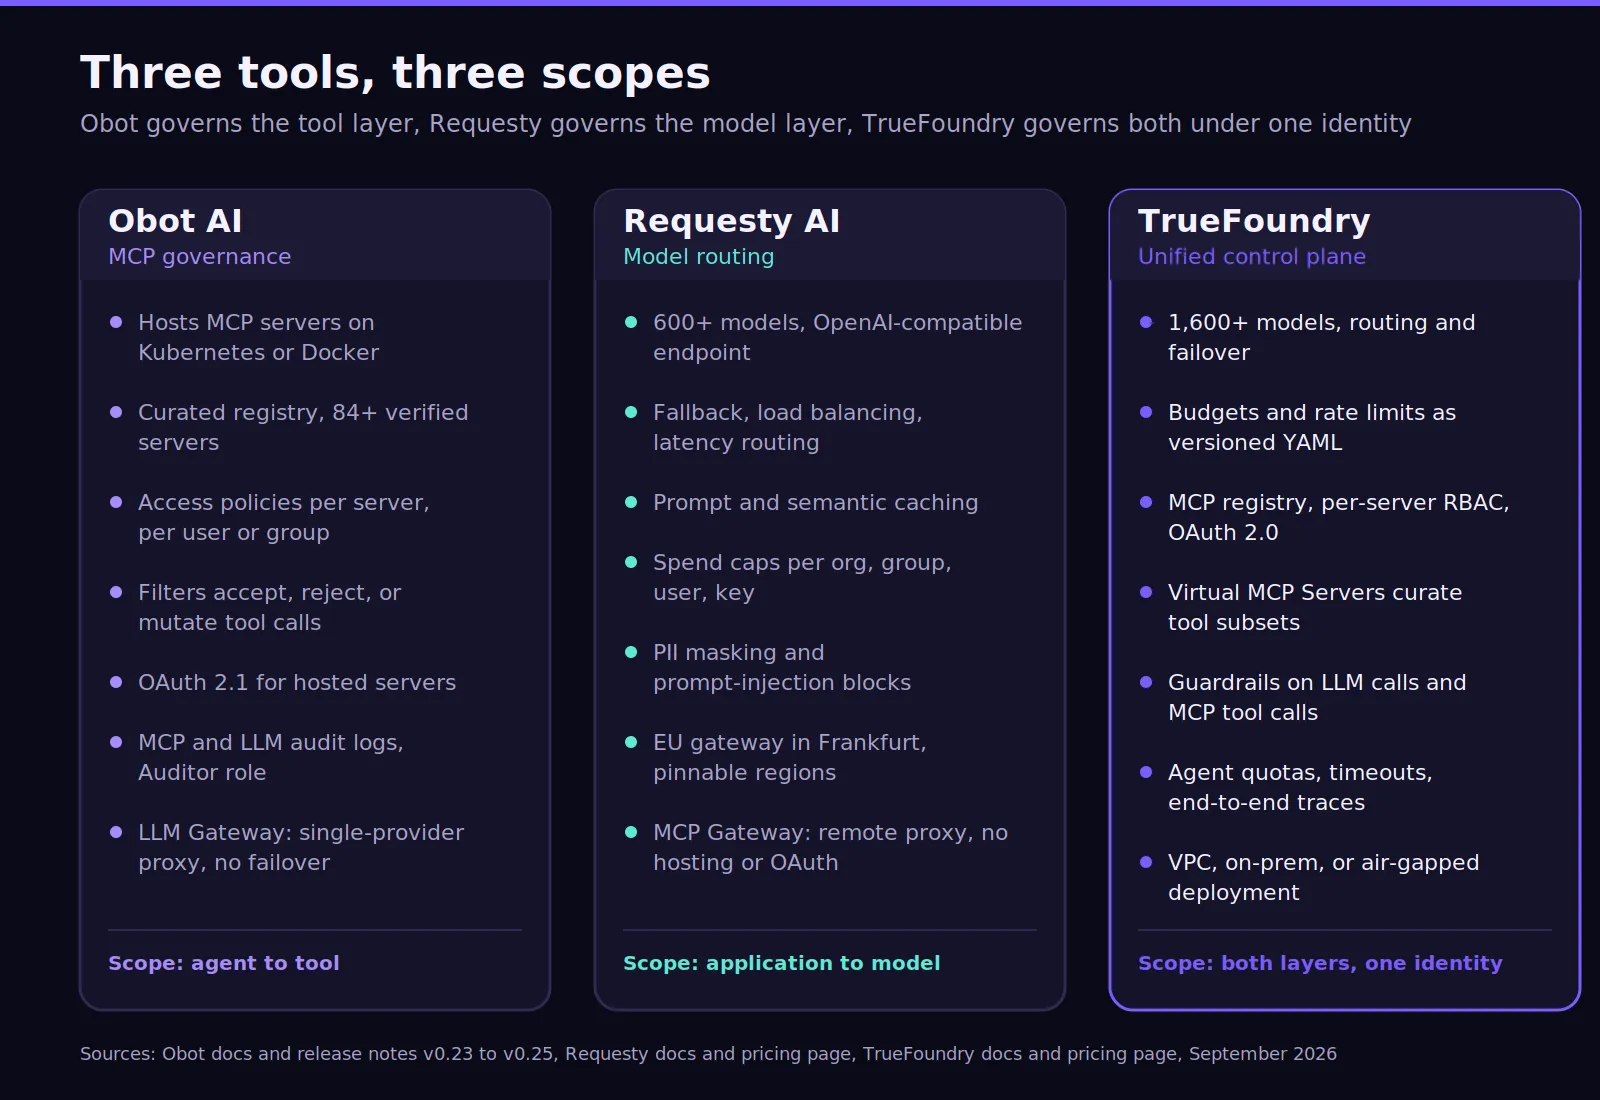
La comparaison entre Requesty AI et Obot AI commence par reconnaître que leurs rôles principaux diffèrent. Obot se situe à l'intersection des agents, des modèles et des outils. Requesty se place principalement entre les applications et les fournisseurs de LLM.
Obot AI centre sa plateforme sur l'Obot MCP Gateway. Elle peut héberger ou servir de proxy pour des serveurs MCP, gérer les identifiants, appliquer des politiques d'accès et enregistrer les requêtes. Son plan de contrôle inclut également une passerelle LLM, des politiques de modèles, des registres et des services d'agents.
Requesty se concentre davantage sur l'accès aux modèles. Les applications modifient l'URL de base pour pointer vers Requesty et accèdent à plus de 600 modèles via un point de terminaison compatible avec OpenAI. Les politiques de routage prennent en charge le basculement, l'équilibrage de charge, la sélection basée sur les coûts et le routage basé sur la latence entre les fournisseurs.
La distinction pratique reste pertinente. Obot aide les équipes informatiques à régir quelles identités accèdent à quels outils et modèles. Requesty aide les applications à sélectionner un fournisseur de modèles de manière fiable tout en contrôlant les coûts et la disponibilité.
Les équipes qui étudient l'architecture de passerelle de modèles peuvent également consulter l'analyse de TrueFoundry sur la passerelle LLM concernant le rôle de l'accès centralisé aux fournisseurs.
Les tableaux de fonctionnalités peuvent masquer des différences architecturales, c'est pourquoi les notes sous ce tableau sont importantes. Obot possède une plus grande partie de l'infrastructure MCP et peut s'exécuter dans des environnements contrôlés par le client. Requesty fonctionne comme un service cloud géré, déchargeant le client de la plupart des opérations de passerelle.
Les capacités principales d'Obot s'étendent désormais au-delà du MCP. Sa passerelle LLM prend en charge OpenAI, Anthropic, Amazon Bedrock, Azure et les points de terminaison compatibles. Les administrateurs définissent des politiques d'accès aux modèles, tandis qu'Obot stocke les identifiants en amont au lieu de les exposer aux utilisateurs.
La passerelle Obot gère également l'hébergement MCP sur Docker ou Kubernetes. Elle prend en charge les serveurs distants lorsque les organisations exploitent déjà leurs propres serveurs MCP. Des filtres permettent d'accepter, de rejeter ou de modifier le trafic avant de transmettre un appel d'outil approuvé.
Requesty résout un problème de routage différent. Son routage intelligent peut distribuer le trafic en fonction du coût, de la latence, de la qualité ou d'un ordre de basculement défini. Cela le rend plus performant pour la fiabilité multi-fournisseurs et l'optimisation des coûts lorsque les applications utilisent plusieurs modèles commerciaux.
La gestion des agents crée une autre différence claire. Obot traite un agent d'IA comme une identité de plateforme régie ayant accès à des modèles et à des outils. Requesty régit principalement les politiques de routage de modèles utilisées par un agent.
L'agent Obot prend en charge les conversations et les flux de travail planifiés, tandis que les portées d'autorisation d'agent fournissent des identifiants machine. Un administrateur peut restreindre une clé API à des serveurs MCP sélectionnés, à l'accès proxy LLM ou à d'autres capacités. Cela permet un accès sécurisé sans utiliser la connexion interactive d'une personne.
Au lieu que les développeurs intègrent des identifiants dans des outils d'IA locaux, Obot fournit une gestion centralisée des identifiants et de l'accès aux serveurs. Des filtres appliquent les politiques avant que les requêtes approuvées n'atteignent les systèmes en aval. La passerelle gère également les flux OAuth en amont et actualise le jeton OAuth nécessaire pour le compte de l'utilisateur.
La gestion des appareils étend la visibilité aux clients développeurs pris en charge tels que Claude Code, Codex et Cursor. L'application des appels d'outils reste expérimentale, tandis que l'activité locale peut toujours être auditée. Cela donne aux équipes d'ingénierie une visibilité sur l'activité de l'IA en dehors des charges de travail d'agents hébergées de manière centralisée.
Requesty ne propose pas le même modèle d'exécution par agent hébergé. Il permet plutôt aux organisations d'appliquer une politique de routage et un plafond de dépenses à des agents spécifiques. Cela s'avère utile lorsque la priorité est la fiabilité du modèle plutôt que l'exécution complète du flux de travail.
Les équipes qui évaluent des alternatives en matière de gouvernance des agents et du protocole MCP peuvent également consulter les alternatives à Obot AI.
Les deux plateformes offrent des capacités d'observabilité, bien qu'elles répondent à des besoins opérationnels différents. Obot se concentre sur l'activité des agents, des modèles et des outils. Requesty met davantage l'accent sur le comportement des fournisseurs, les coûts, le routage et les performances de la passerelle.
Obot enregistre les requêtes MCP, les utilisateurs, les horodatages, les résultats, les informations sur les modèles et la consommation de jetons. Ses journaux d'audit LLM incluent également le fournisseur, le modèle demandé, les détails du client et la durée. L'accès aux données sensibles des requêtes ou des réponses nécessite le rôle d'auditeur.
Les exportations d'audit peuvent être envoyées vers Amazon S3, Google Cloud Storage, Azure Blob Storage ou tout stockage d'objets compatible. Les organisations conservent ainsi un contrôle total sur leurs preuves à long terme et peuvent aligner le stockage sur leurs exigences en matière de confidentialité des données.
Requesty met l'accent sur la latence des requêtes, les performances du cache, le coût des modèles, les échecs et le routage des fournisseurs. Son tableau de bord offre une visibilité en temps réel sur les coûts et l'utilisation par clé, par équipe et par modèle. La passerelle prend également en charge le routage régional basé sur des politiques et des points de terminaison sans conservation de données.
Cette distinction est importante pour les exigences de conformité. Obot fournit une piste d'audit détaillée des actions des agents et du protocole MCP. Requesty offre aux équipes une meilleure visibilité sur les résultats du routage des modèles, l'application des politiques et les coûts liés au trafic des modèles en production.
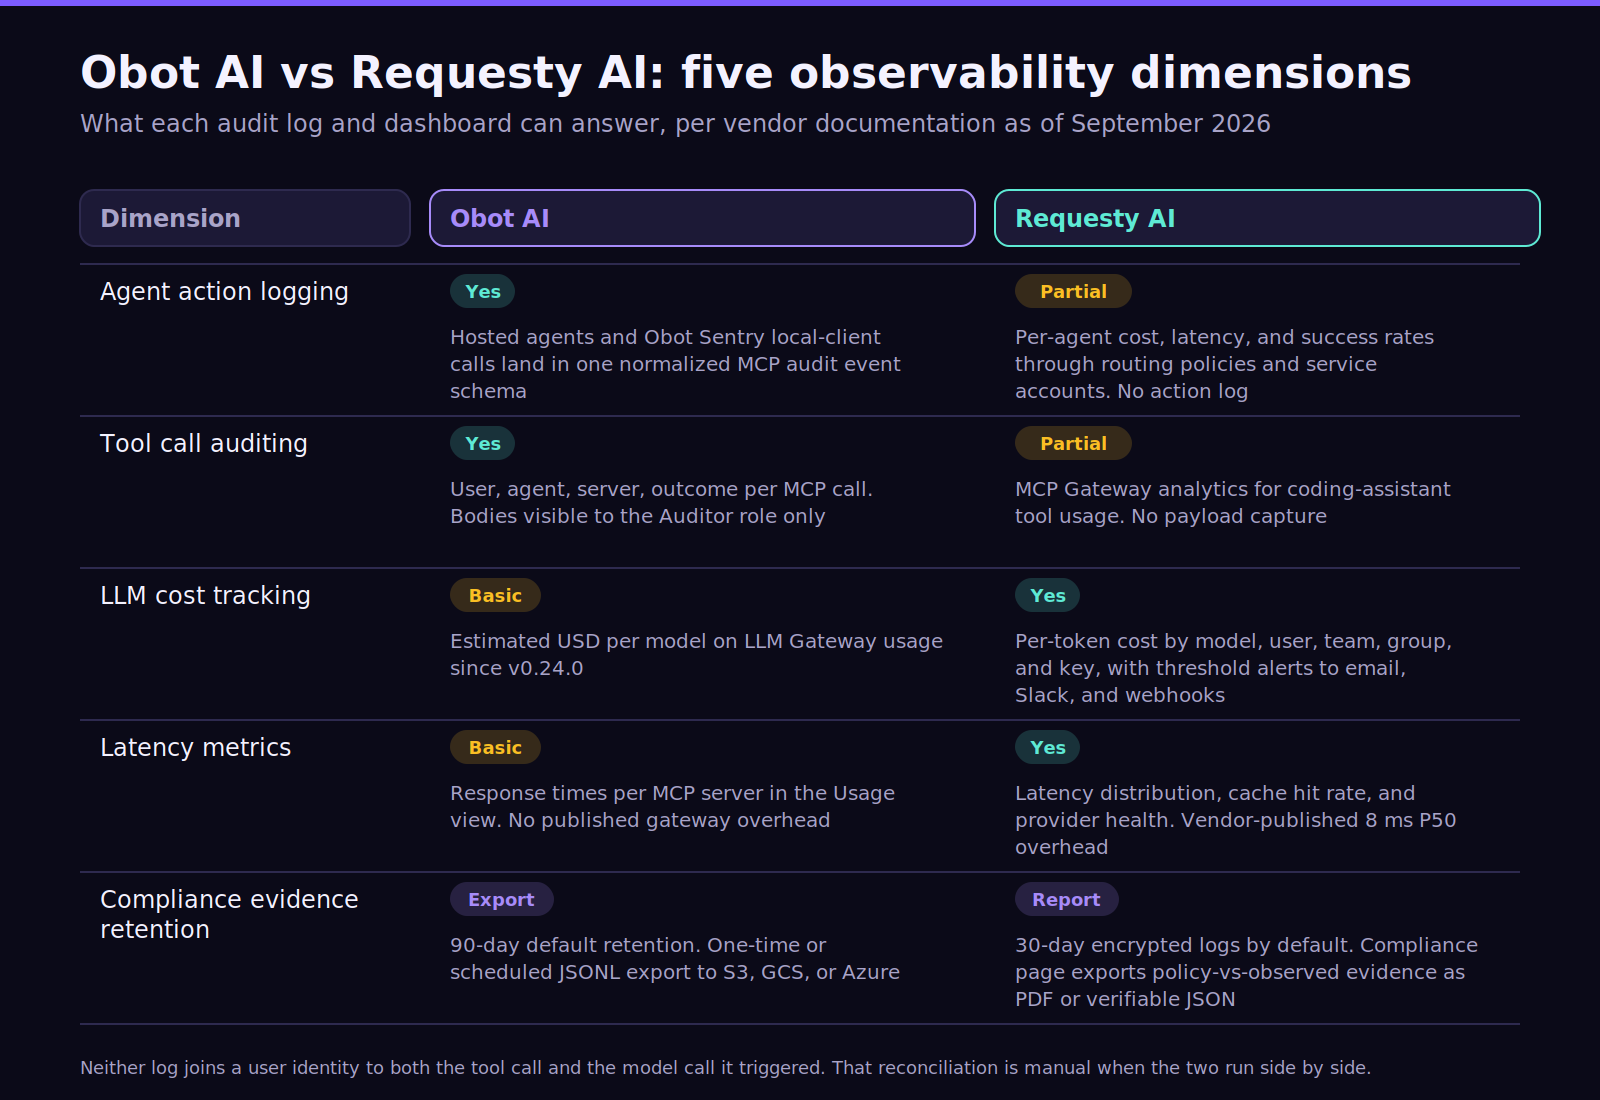
Texte alternatif: Comparaison de l'observabilité entre Obot AI et Requesty AI selon cinq dimensions de surveillance en entreprise
Les modèles de tarification et de déploiement reflètent des philosophies de propriété différentes. Obot offre aux clients un contrôle accru sur leur infrastructure. Requesty facture une passerelle entièrement gérée, éliminant ainsi la majeure partie de la charge opérationnelle.
Obot propose actuellement trois éditions basées sur la même image de conteneur. L'édition par défaut prend en charge jusqu'à 100 utilisateurs et 100 appareils. L'édition Community reste gratuite et ajoute la prise en charge d'Entra, Okta, JumpCloud et Auth0. L'édition Enterprise supprime ces limites et inclut un support dédié.
Un déploiement Kubernetes ou Docker permet de maintenir Obot au sein de l'infrastructure du client. Les charges de travail MCP hébergées s'exécutent dans des conteneurs séparés ou des environnements Kubernetes. Cette structure est adaptée aux organisations ayant des exigences strictes en matière de cloud privé, d'identifiants internes ou de stockage local des journaux d'audit.
Requesty propose une offre d'entrée gratuite et une tarification à l'usage. La tarification actuelle ajoute 5 % aux coûts des modèles en amont, tandis que les clés de fournisseur appartenant au client ne font l'objet d'aucune majoration. Le plan gratuit prend en charge 200 requêtes quotidiennes sur les modèles gratuits disponibles.
La tarification entreprise de Requesty est personnalisée. L'offre entreprise inclut le SSO, le RBAC, une assistance à la conformité, des SLA sur mesure et des contrôles organisationnels approfondis. Sa période d'observation SOC 2 Type II est en cours, et la résidence des données dans l'UE est disponible à Francfort.
Pour les charges de travail à grande échelle, les équipes doivent comparer les licences avec la gestion opérationnelle. L'auto-hébergement signifie que le patching, la mise à l'échelle, le stockage et le support restent des responsabilités internes. Le SaaS élimine une grande partie de ce travail, tout en obligeant le client à accepter les options de déploiement et le périmètre de sécurité du fournisseur.
À lire également: Guide des coûts des passerelles IA
Obot AI est adapté aux équipes ayant besoin d'une couche de gouvernance MCP dédiée. Il est utile lorsque des agents internes, des assistants de codage et des clients IA doivent accéder de manière approuvée à des serveurs MCP locaux, distants ou hébergés. Il prend également en charge les organisations qui privilégient l'infrastructure open source et le contrôle via l'auto-hébergement.
Une mise en garde s'impose : le plafond de 100 utilisateurs et 100 appareils pour Obot Enterprise, introduit dans la version v0.25.0, s'applique désormais aux déploiements avec authentification GitHub et Google qui étaient auparavant illimités. Les utilisateurs existants continuent de fonctionner au-delà de cette limite, mais vous ne pouvez plus en ajouter de nouveaux. Dimensionnez votre projet pilote en tenant compte de ce chiffre.
Requesty AI convient aux équipes qui ont besoin d'un accès rapide à de nombreux modèles via une passerelle gérée. Sa valeur ajoutée réside dans la fiabilité des fournisseurs de LLM, les politiques de routage, la mise en cache, l'analyse et le contrôle des dépenses, sans avoir à gérer d'infrastructure auto-hébergée.
La plateforme est également adaptée aux prototypes où les équipes souhaitent expérimenter rapidement des modèles. Une fois que l'utilisation atteint un niveau de RPS modéré ou des pics plus élevés, les équipes doivent tester la fiabilité des fournisseurs et les scénarios de latence élevée en utilisant un trafic de production réaliste plutôt que des requêtes isolées.
La passerelle de Requesty peut contourner les fournisseurs dégradés et appliquer des restrictions de modèle de manière centralisée. Cela améliore l'expérience des développeurs qui, autrement, devraient gérer des identifiants et des intégrations séparés. Son interface compatible avec OpenAI minimise également les modifications au niveau des applications.
Choisir Obot AI ou Requesty AI sur la seule base d'une démonstration peut mener à une conclusion erronée. Une plateforme peut démontrer un accès aux outils bloqué, tandis que l'autre démontre un basculement réussi. Les deux scénarios sont importants, bien que chacun mesure une couche différente de la production.
La comparaison entre Obot AI et Requesty AI révèle une limite commune lorsqu'un flux de travail traverse les deux couches. Obot régit les modèles, les agents et l'accès MCP au sein de sa plateforme. Requesty offre un routage inter-fournisseurs plus approfondi. Aucun des deux ne combine toutes les commandes d'entreprise avec la même profondeur.
Un flux de travail de support peut appeler un modèle, interroger un CRM via MCP, mettre à jour un dossier et déclencher un autre agent. Cela crée une exposition potentielle des données lorsque l'identité, les autorisations, les budgets et les journaux sont répartis entre des systèmes indépendants.
Requesty a également étendu ses propres intégrations MCP. Sa passerelle MCP prend en charge l'authentification centralisée, la liste blanche d'outils, l'analyse d'utilisation et les identifiants partagés ou par utilisateur pour les serveurs MCP distants. Elle ne remplace pas l'hébergement MCP complet ni la gouvernance complète de l'exécution des agents.
Les éléments manquants deviennent plus visibles lorsque les équipes souhaitent une politique unique pour les modèles et les outils :
Une couche d'agent dédiée devient pertinente lorsque ces actions se transforment en flux de travail multi-étapes. L'Agent Gateway de TrueFoundry Agent Gateway fournit des tentatives, des délais d'attente, des contrôles de politique, une traçabilité et une exécution gouvernée des outils à travers ces flux de travail.
Bannière CRO :
Titre: Dépassez la simple tarification de passerelle pour une exécution d'IA agentique gouvernée à travers vos équipes
Sous-texte: Lancez-vous avec TrueFoundry pour appliquer l'identité, les budgets, les politiques MCP et les pistes d'audit avant toute exécution
CTA: Démarrer
Texte alternatif: TrueFoundry permet une exécution d'IA agentique gouvernée à travers les équipes
Lien: https://www.truefoundry.com/book-demo?ref=obot_ai_vs_requesty_ai
TrueFoundry est la solution idéale pour les entreprises souhaitant une plateforme unique reliant la gouvernance des modèles, des outils et des agents. Son plan de contrôle IA intègre le routage des modèles, l'identité, les politiques, les budgets, les garde-fous et l'observabilité au sein d'une même architecture de production.
La couche modèle prend en charge le routage multi-fournisseurs et le déploiement de modèles sur des points de terminaison hébergés ou auto-hébergés. Les politiques budgétaires peuvent être appliquées aux utilisateurs, aux équipes, aux modèles ou aux métadonnées avant l'exécution de toute requête supplémentaire.
Une règle budgétaire est un objet YAML versionné, ce qui lui permet d'être stockée dans Git aux côtés du reste de la configuration de la plateforme :
name: budget-limiting-config
type: gateway-budget-config
rules :
- id: 'support-rag-monthly'
when:
subjects: ['team:support']
metadata:
environment: 'production'
limit_to: 5000
unit: cost_per_month
budget_applies_per: ['user']
alerts:
thresholds: [75, 90, 100]
notification_target:
- type: slack-bot
notification_channel: 'budget-alerts-channel'
channels: ['#ai-spend']
Lorsque le pipeline RAG de l'équipe de support dépasse 5 000 $ par mois, la passerelle renvoie une erreur 429 avec `error_origin_level: rate_limit_budget` dans le corps de la réponse et l'identifiant de la règle enfreinte dans l'en-tête `x-tfy-applied-rules`, évitant ainsi toute mauvaise surprise sur la facture. Cela couvre le cas d'usage de gouvernance des coûts et d'accès multi-fournisseurs que propose Requesty AI, avec l'avantage architectural supplémentaire d'un déploiement natif VPC.
La passerelle MCP TrueFoundry fournit un contrôle d'accès basé sur les rôles (RBAC) par serveur, des abstractions de serveurs MCP virtuels, une gestion des jetons OAuth 2.0 avec rafraîchissement automatique, ainsi que des pistes d'audit liées à l'identité de l'utilisateur pour chaque invocation d'outil.
Un serveur MCP virtuel sélectionne un sous-ensemble d'outils provenant de plusieurs serveurs enregistrés (par exemple, GitHub sans `delete_pr` et Slack sans `delete_message`) et les expose via un point de terminaison unique ne nécessitant aucun déploiement. Les garde-fous s'appliquent au même niveau de politique, et un seul fichier YAML régit les appels LLM ainsi que les appels d'outils MCP :
name: guardrails-control
type: gateway-guardrails-config
rules:
- id: kubernetes-tools-pii
when:
target:
operator: or
conditions:
mcpServers:
values:
- kubernetes-mcp
condition: in
subjects:
operator: and
conditions:
in:
- team:platform
llm_input_guardrails: []
llm_output_guardrails: []
mcp_tool_pre_invoke_guardrails:
- pii/pii-detection
mcp_tool_post_invoke_guardrails: []
Cette architecture est utile lorsque des produits de passerelle distincts créeraient des politiques redondantes. Elle permet également de simplifier la gouvernance lorsque plusieurs équipes partagent des modèles, des agents et des outils MCP au sein de différents environnements.
Choisissez TrueFoundry lorsque :
TrueFoundry propose actuellement une offre Developer à 0 $, une offre Pro à 499 $ par mois, une offre Pro Plus à 2 999 $ et une tarification Enterprise personnalisée. L'offre Enterprise prend en charge les plans de contrôle et de passerelle VPC et isolés (air-gapped).
Pour les équipes comparant des architectures de production plus larges, TrueFoundry fournit une couche de contrôle unique pour les modèles, les outils, les agents et l'exécution gouvernée en entreprise.
Réservez une démo avec TrueFoundry pour découvrir comment un plan de contrôle d'entreprise unique peut gouverner en toute sécurité les modèles, les outils MCP, les agents, les budgets, les politiques et les preuves d'audit dans votre environnement d'IA en production dès aujourd'hui.
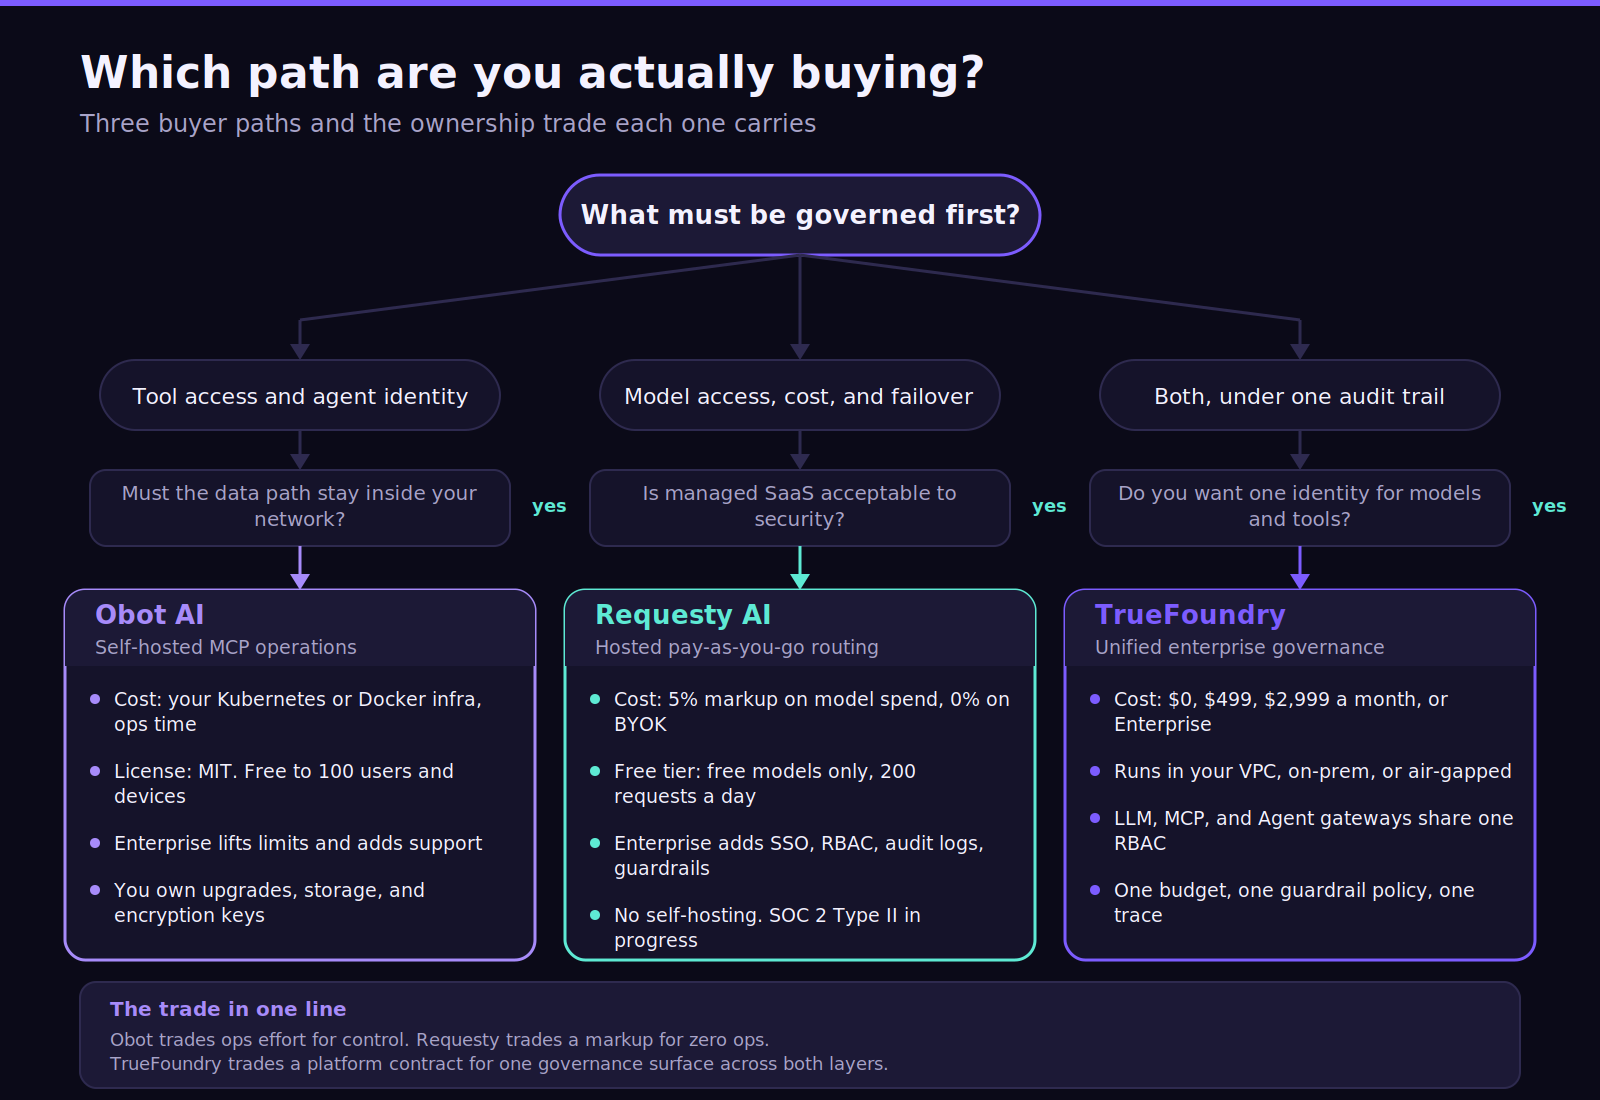
Texte alternatif : Flux de décision tarifaire illustrant les compromis entre les opérations open-source, l'utilisation de passerelles avec paiement à l'usage et la gouvernance en entreprise
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















