



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 10, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les techniques de prompt engineering aident les équipes à rédiger de meilleures instructions pour les modèles de langage, à améliorer la qualité des résultats et à réduire les erreurs évitables. OpenAI définit le prompt engineering comme la rédaction d'instructions efficaces permettant aux modèles de produire un contenu conforme aux exigences. Anthropic souligne que le prompt engineering est d'autant plus efficace que les critères de réussite sont contrôlables par le biais des prompts.
Pour les équipes en entreprise, le prompt engineering n'est plus une simple compétence de productivité individuelle. Il influe désormais sur les coûts, la latence, la fiabilité, la conformité et l'expérience utilisateur des modèles. Un prompt qui ajoute trois phrases de raisonnement peut doubler la consommation de jetons sur un mois comptant un million de requêtes. Un prompt qui accorde à un agent un accès non sécurisé à des outils peut constituer un incident de contrôle d'accès.
Ce guide explique les méthodes de prompt engineering les plus utiles, quand les appliquer, et comment la rigueur au niveau du prompt doit s'articuler avec la gouvernance des passerelles IA. Il explique également comment TrueFoundry aide les équipes à gérer les prompts, les modèles, les outils MCP, les budgets et les agents en production.
Le prompt engineering est la pratique consistant à concevoir des prompts pour les LLM afin d'obtenir des résultats fiables, précis et correctement formatés. Il constitue l'interface principale entre l'intention humaine et le comportement du modèle d'IA. La qualité de cette interface affecte directement la fiabilité, le coût, la sécurité et l'utilité de l'application pour diverses tâches.
La discipline a évolué, passant de la rédaction d'instructions concises pour des questions simples à la création d'architectures de prompts pour des flux de travail agentiques. Un prompt moderne peut inclure des variables d'entrée, des règles de sortie structurées, des contextes supplémentaires, des paramètres de modèle, des garde-fous et des exigences de politique pour une utilisation en production.
L'implication pratique est claire. Les équipes qui traitent les prompts comme du texte jetable livrent souvent des applications d'IA de moindre qualité. Celles qui appliquent des techniques de prompt engineering systématiques, avec gestion de versions, évaluation et gouvernance, disposent d'un chemin plus sûr vers des réponses précises et de meilleurs résultats.
La solution de gestion des prompts de TrueFoundry reflète ce changement. Un prompt enregistré stocke le message système, le message utilisateur, les variables d'entrée, les garde-fous et la configuration de sortie structurée dans un objet versionné. Les applications peuvent y faire référence par un nom complet au lieu d'intégrer le texte du prompt directement dans le code.
Sept techniques fondamentales de prompt engineering couvrent la majeure partie du travail en production. Considérez-les comme une progression. Chacune apporte précision, structure ou contrôle, mais chacune impose également aux équipes des coûts en termes de jetons, de latence, d'effort de maintenance ou de complexité de gouvernance.
Le prompt engineering zero-shot consiste à demander au modèle de langage d'accomplir une tâche spécifique sans lui fournir d'exemples. Le modèle s'appuie sur ses données d'entraînement et son bon sens pour déduire le format, le contenu et le ton appropriés de la réponse à partir de la seule instruction.
Idéal pour : Les tâches bien définies pour lesquelles le modèle comprend déjà le modèle. Exemples : résumé, traduction, classification simple, réponse à des FAQ et extraction d'informations pertinentes à partir de textes courts.
Limitation : La fiabilité du « zero-shot » diminue lorsque la tâche requise impose un formatage strict ou un comportement spécifique au domaine. L'échec est souvent silencieux. Un classifieur « zero-shot » renvoie une étiquette plausible plutôt qu'une erreur ; le défaut n'apparaît donc que plus tard, sous la forme d'analyses médiocres ou d'une baisse de satisfaction des utilisateurs.
Le prompting « few-shot » consiste à fournir un ou plusieurs exemples d'entrées-sorties avant la requête proprement dite. Ces exemples détaillés donnent au modèle un modèle concret à suivre, surtout lorsque le résultat souhaité exige un ton, un schéma, un ensemble d'étiquettes ou une structure de rédaction spécifiques.
Idéal pour : Les tâches où la forme du résultat est importante. Utilisez-le pour la classification avec des étiquettes fixes, l'extraction de données structurées, l'adaptation au style, le ton spécifique à un domaine et les exigences de format répétables.
Combien d'exemples : Deux ou trois exemples suffisent souvent pour de nombreuses tâches de production. Davantage d'exemples peuvent améliorer la qualité du prompt, bien que chaque requête soit facturée en fonction de ces jetons. Les équipes doivent évaluer le compromis avant d'utiliser des prompts plus longs sur des points de terminaison à fort volume.
Le prompting par chaîne de pensée demande au modèle de raisonner par étapes intermédiaires avant de produire la réponse finale. Cela peut améliorer les performances sur un problème mathématique, une tâche logique, un flux de dépannage ou un problème de codage où le raisonnement intermédiaire influe sur le résultat.
Idéal pour : Le raisonnement complexe, les arbres de décision, le diagnostic technique, l'analyse financière et les tâches de réflexion approfondie. Il fonctionne mieux lorsque le prompt demande une résolution de problème délibérée plutôt qu'une réponse courte.
CoT « zero-shot » : Ajouter une instruction de raisonnement étape par étape peut activer le comportement de chaîne de pensée sans fournir d'exemples de chaînes de raisonnement. Cela reste un moyen simple d'améliorer le raisonnement sur des tâches complexes.
Combinaison avec le « few-shot » : Les exemples « few-shot » incluant des chemins de raisonnement peuvent améliorer les performances pour les flux de travail spécifiques à un domaine. Les équipes doivent veiller à ce que la réponse affichée reste concise lorsque les utilisateurs n'ont besoin que du résultat final.
Une mise en garde opérationnelle est importante ici. Le résultat d'une chaîne de pensée est long, et les sorties longues sont précisément ce que les équipes diffusent en flux (streaming) pour maintenir une latence perçue faible. La documentation sur les garde-fous de TrueFoundry guardrails documentation indique que les garde-fous de sortie sont ignorés lorsqu'une requête définit `stream: true`, car il n'y a pas de réponse complète à évaluer. Le raisonnement que vous diffusez en flux est un raisonnement qu'aucune politique de sortie ne contrôle.
L'auto-cohérence étend le prompting par chaîne de pensée en générant plusieurs chaînes de raisonnement indépendantes pour la même question. Le système sélectionne ensuite la réponse finale la plus cohérente parmi les échantillons.
Idéal pour : Les raisonnements à enjeux élevés où la précision de la réponse prime sur le coût d'inférence. Cela inclut les analyses de risques, le support au raisonnement juridique, l'analyse financière, les études de cas et les recommandations sensibles en matière de sécurité.
Compromis de coût : L'auto-cohérence nécessite plusieurs appels au modèle par requête. Cinq chaînes échantillonnées transforment une requête facturable en cinq. L'application d'un budget par équipe via une passerelle IA est essentielle lorsque les équipes appliquent cette méthode à grande échelle.
Le prompting ReAct combine raisonnement et action. Le modèle alterne entre une étape de réflexion (Thought), une étape d'action (Action) et une étape d'observation (Observation). Ce modèle permet au modèle de raisonner, d'appeler des outils externes, de lire le résultat et de poursuivre jusqu'à ce que la tâche soit terminée.
Idéal pour : Les flux de travail d'agents nécessitant une récupération d'informations, l'exécution d'outils, un contexte en temps réel ou l'achèvement de tâches en plusieurs étapes. ReAct est utile lorsqu'un assistant IA doit interagir avec des bases de données, des API, des outils SaaS ou des systèmes internes.
ReAct modifie la question de sécurité. Le prompt ne façonne plus seulement le texte. Il influence également la sélection des outils et le séquençage des actions. Lorsque les outils interagissent avec les systèmes métier, la passerelle MCP sert de couche d'application pour les autorisations, la validation et la journalisation d'audit.
Le prompting basé sur les rôles attribue au modèle une personnalité, un domaine d'expertise ou un contexte comportemental spécifique au niveau du prompt système. « Vous êtes un analyste financier senior examinant un portefeuille client » produit des modèles de raisonnement et des styles de sortie différents de la même question sans attribution de rôle.
Idéal pour : Les applications spécifiques à un domaine, les agents de service client avec des personnalités définies, les bots de support technique et toute application où la cohérence du ton et du contexte comportemental est importante dans toutes les interactions.
Application en entreprise : Les prompts système basés sur les rôles sont un mécanisme principal pour appliquer des garde-fous comportementaux au niveau de l'application, avant que le filtrage des sorties ne soit appliqué au niveau de l'infrastructure.
Notez une limite qui surprend la plupart des équipes. La documentation sur les garde-fous de TrueFoundry confirme que les prompts système sont exclus par défaut de l'évaluation des garde-fous ; la définition du rôle elle-même n'est donc jamais inspectée, bloquée ou censurée. Les instructions de personnalité façonnent le comportement, mais elles n'agissent pas comme une politique vérifiée par l'infrastructure.
Le méta-prompting utilise le LLM pour analyser, critiquer et améliorer les prompts plutôt que d'exécuter directement les tâches de l'utilisateur final. Un ingénieur de prompts peut s'en servir pour générer des variantes, comparer des modèles courants et affiner les instructions en un temps réduit.
Idéal pour : Les équipes qui itèrent fréquemment sur la conception de prompts et souhaitent accélérer l'optimisation. Cette approche est utile pour les activités complexes, la planification stratégique et les prompts de systèmes d'agents comportant de nombreux éléments clés.
Note de production : Le méta-prompting génère des prompts candidats qui doivent impérativement être évalués par rapport à un jeu de test avant leur mise en production. Il accélère l'étape de génération des candidats, mais pas celle de la validation.
Un flux de travail systématique d'amélioration des prompts garantit l'objectivité de cette distinction en notant les candidats par rapport à un jeu d'évaluation fixe plutôt que sur la simple impression d'un relecteur.
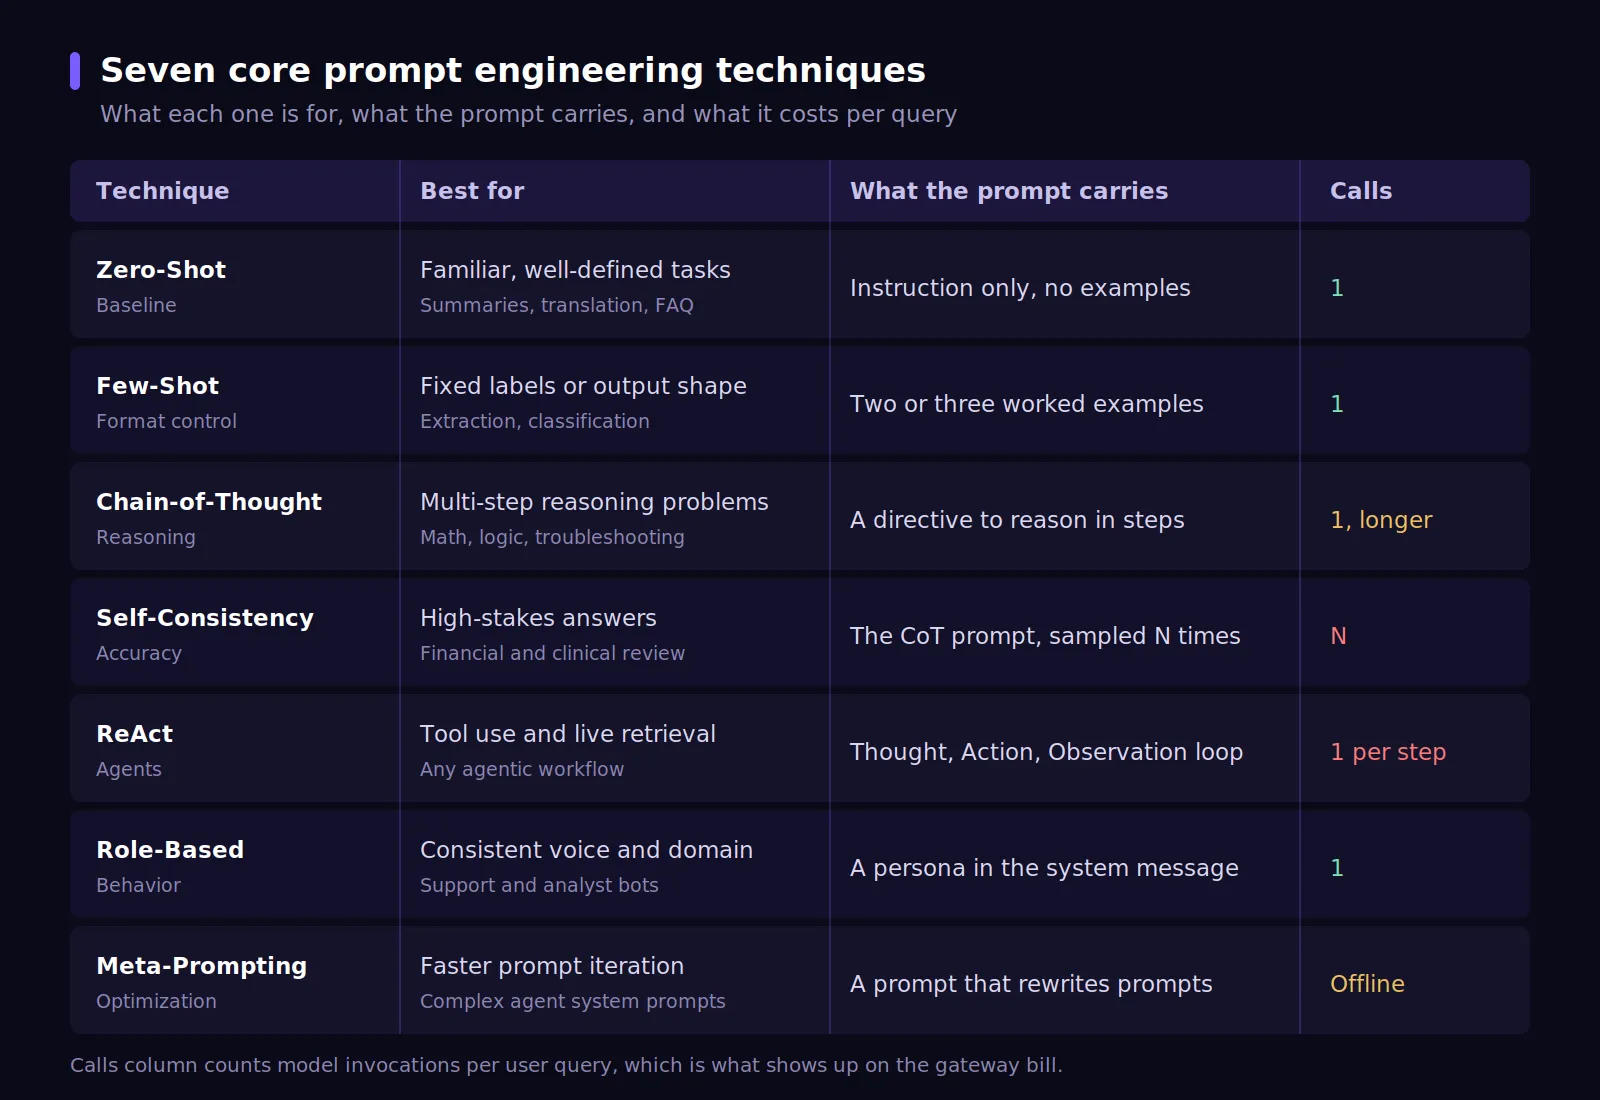
Les techniques avancées ci-dessous nécessitent davantage de ressources de calcul ou de conception pour résoudre des problèmes que les méthodes plus simples traitent difficilement. Utilisez-les lorsqu'un jeu d'évaluation démontre que la méthode simple a atteint ses limites.
L'arbre de pensée étend le raisonnement linéaire (chaîne de pensée) en une structure arborescente. Le modèle explore plusieurs pistes de réflexion, évalue les solutions potentielles et sélectionne la branche la plus prometteuse pour poursuivre.
Idéal pour : Les problèmes où le chemin vers la solution n'est pas évident dès l'énoncé initial. Cela inclut la synthèse de recherche, le travail créatif comme l'écriture de nouvelles, l'élaboration de stratégies, le débogage complexe et la planification ouverte.
L'arbre de pensée peut améliorer les résultats sur des tâches de raisonnement difficiles. Il augmente également les coûts en fonction du facteur de branchement et de la profondeur. Il est donc important de définir des plafonds budgétaires avant d'intégrer cette technique dans des interfaces destinées aux clients.
Le prompting constitutionnel intègre un ensemble de principes dans le prompt système. Le modèle utilise ces principes pour s'auto-évaluer et réviser sa propre réponse avant de la soumettre.
Idéal pour : Les applications d'IA où l'alignement constant avec les valeurs organisationnelles, les règles de sécurité ou les normes de conformité est essentiel. Cela permet d'orienter le comportement du modèle avant même l'application de filtres post-génération.
Considérez la constitution comme un outil de contrôle qualité, et non comme un audit. Les principes résident au sein du prompt système. Les preuves de conformité doivent provenir de garde-fous, de traces, de résultats de politiques et de journaux sur lesquels le modèle ne peut pas influer.
Le prompting par stimulus directionnel ajoute un bref indice, un mot-clé ou un signal d'orientation pour diriger le modèle vers les informations les plus pertinentes. Cette méthode est utile lorsque le prompt de base est clair, mais que le modèle a besoin d'une indication plus précise sur ce qui est important.
Idéal pour : Les tâches de classification, de résumé et d'extraction où un léger indice directionnel améliore la concentration. Par exemple, un résumé sur le changement climatique peut utiliser un stimulus tel que « impacts politiques » pour orienter l'attention.
Il s'agit d'une technique avancée, car de petits indices peuvent modifier la réponse de manière inattendue. Les équipes doivent comparer les performances par rapport à une référence et confirmer que le stimulus améliore le résultat souhaité sans nuire aux autres cas.
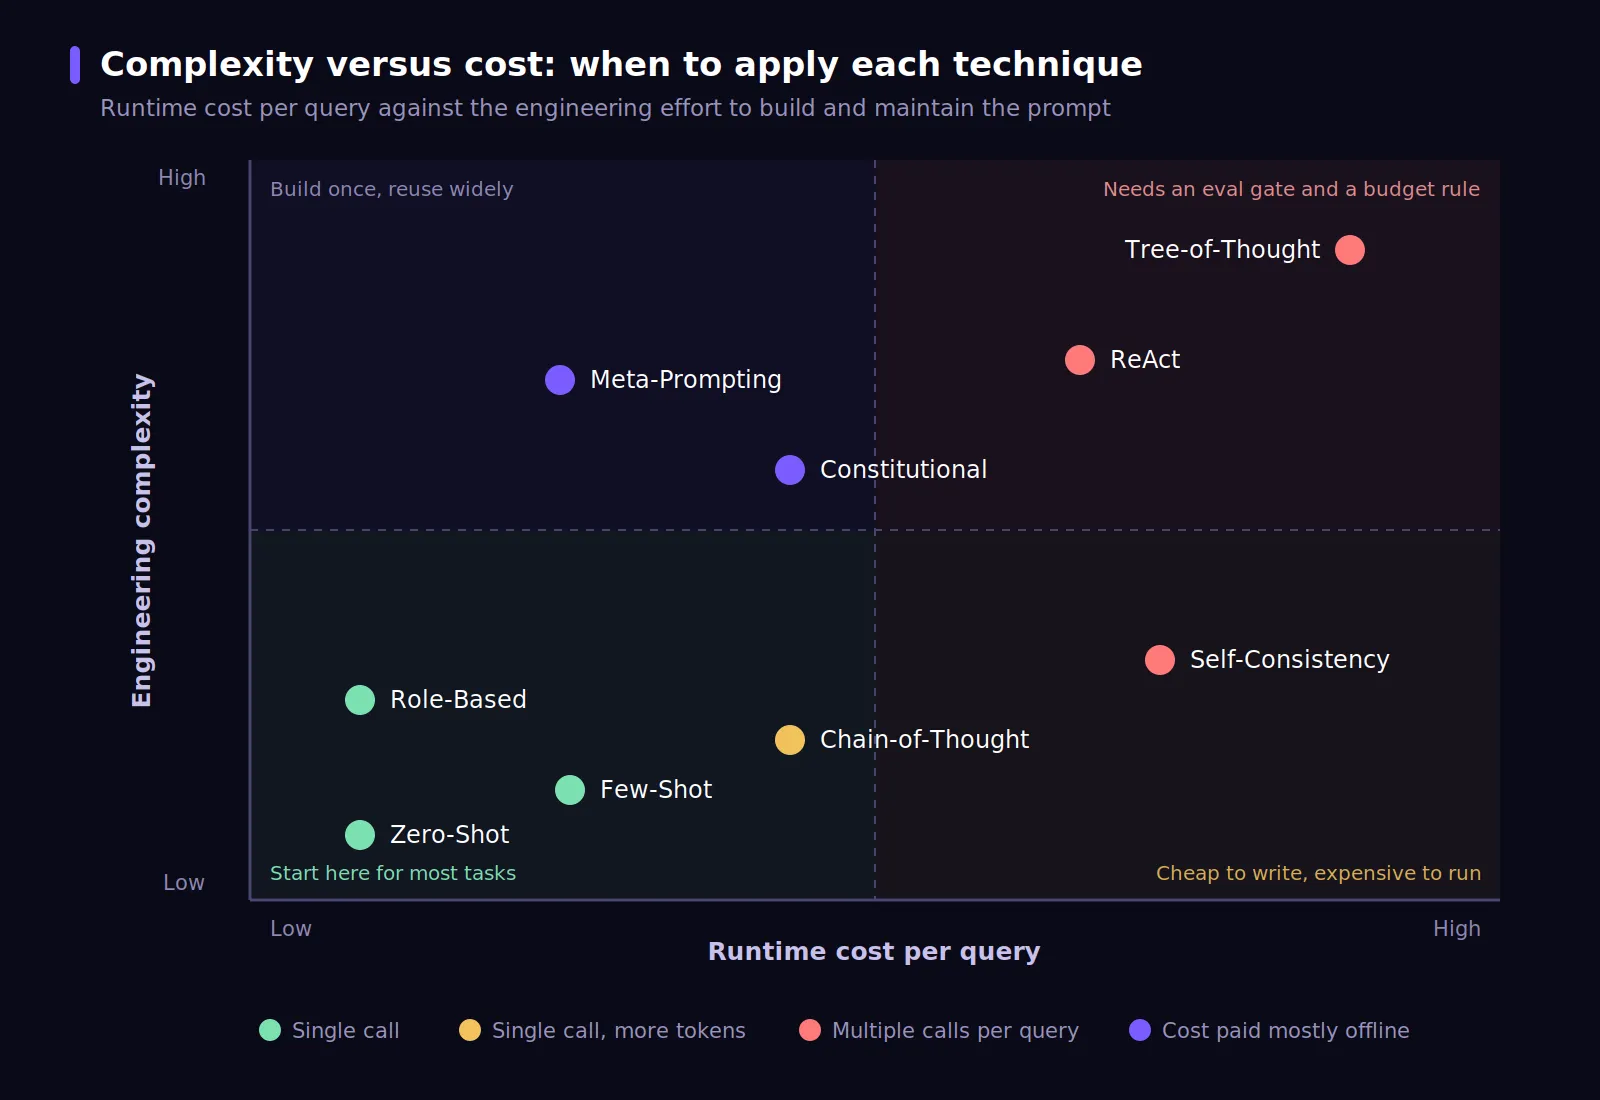
Les méthodes individuelles de prompt engineering fonctionnent différemment lors de tests contrôlés et dans des environnements de production avec de vrais utilisateurs. Plusieurs réalités opérationnelles influencent la viabilité des techniques à mesure que le trafic, les coûts, les risques et la gouvernance augmentent.
Le garde-fou d'injection de prompt intégré de TrueFoundry fonctionne uniquement en mode validation et analyse le prompt utilisateur ainsi que tout document ou contenu contextuel comme deux surfaces distinctes. Cette séparation de l'analyse est cruciale, car l'injection indirecte se produit au sein des documents récupérés plutôt que dans le message de l'utilisateur lui-même.
Les techniques d'ingénierie de prompt déterminent la capacité d'un LLM à comprendre et à exécuter une tâche. La couche de gouvernance détermine si cette exécution se déroule en toute sécurité, dans le respect des limites budgétaires, et avec les contrôles d'accès et les preuves d'audit requis par la production en entreprise.
L'AI Gateway de TrueFoundry applique un filtrage des entrées avant que les prompts n'atteignent un modèle, interceptant les tentatives d'injection de prompt, quelle que soit la sophistication des méthodes d'ingénierie de prompt du système. Les garde-fous de sortie appliquent la politique de contenu avant que les réponses ne soient renvoyées aux applications, complétant ainsi le « constitutional prompting » au niveau du modèle plutôt que de le remplacer.
Le modèle d'exécution récompense une lecture attentive. Les garde-fous de validation des entrées s'exécutent en parallèle de la requête du modèle ; si la validation échoue en cours de route, la passerelle annule la requête afin que le prompt bloqué ne soit pas facturé. Les garde-fous de mutation des entrées, comme la rédaction de données PII, s'exécutent en amont de la requête, car ils réécrivent la charge utile reçue par le modèle.
Chaque garde-fou apparaît dans la trace de la requête sous forme d'intervalle (span) avec sa latence, son verdict, sa portée et l'entité à laquelle il s'applique. Le déploiement suit les preuves : commencez par les règles en mode Audit, passez à Enforce, But Ignore On Error, puis basculez sur Enforce une fois que les résultats sont concluants.
Les garde-fous peuvent être associés à chaque requête via l'en-tête `X-TFY-GUARDRAILS`, ou de manière centralisée en tant que politiques sous AI Gateway → Controls → Guardrails pour une application à l'échelle de l'organisation.
{
  "llm_input_guardrails": ["my-group/prompt-injection"],
  "llm_output_guardrails": ["my-group/secrets-detection"],
  "mcp_tool_pre_invoke_guardrails": ["my-group/sql-sanitizer"],
  "mcp_tool_post_invoke_guardrails": ["my-group/code-safety"]
}
Les budgets de jetons par équipe, appliqués via la passerelle LLM , permettent de prévenir les dépassements de coûts que les techniques de cohérence automatique (self-consistency) et de réflexion (tree-of-thought) engendrent à grande échelle en l'absence de gouvernance des coûts. Les règles de limitation de débit (rate limiting) acceptent aussi bien des unités de jetons que des unités de requête, et `rate_limit_applies_per` crée un compteur indépendant par utilisateur, par modèle ou par clé de métadonnée.
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap the reasoning-heavy service that runs self-consistency
  - id: "reasoning-service-hourly"
    when:
      metadata:
        service: "risk-analysis"
    limit_to: 200000
    unit: tokens_per_hour

  # Give every user an independent daily token ceiling
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
Les règles budgétaires permettent de définir des plafonds financiers par utilisateur, équipe, modèle, compte virtuel ou clé de métadonnée. Les alertes de jalon et le mode audit aident les équipes à calibrer les seuils avant que l'application des règles ne bloque le trafic.
Les applications peuvent appeler un prompt gouverné par son FQN de version au lieu d'intégrer le texte directement dans l'application. Cela permet de sortir les modifications de prompts du cycle de publication. La passerelle génère le modèle et exécute l'appel.
from openai import OpenAI

client = OpenAI(
    api_key="your-tfy-api-key",
    base_url="{GATEWAY_BASE_URL}"
)

response = client.chat.completions.create(
    messages=[],
    model="",
    extra_headers={
        "X-TFY-METADATA": '{"service":"risk-analysis","env":"production"}',
    },
    extra_body={
        "prompt_version_fqn": "chat_prompt:truefoundry/default/cot-risk-review:3",
        "prompt_variables": {
            "portfolio_id": "PF-4471",
            "review_window": "Q3"
        }
    },
)

print(response.choices[0].message.content)
Deux détails dans cet appel sont importants. L'épinglage de version signifie qu'un retour en arrière (rollback) de prompt ne nécessite jamais de redéploiement, et l'en-tête `X-TFY-METADATA` est ce qui permet aux budgets par service, aux limites de débit et à l' imputation des coûts de se rapporter à un propriétaire réel.
L' Agent Gateway gouverne chaque appel d'outil effectué par les agents basés sur ReAct, de sorte que les étapes de raisonnement et d'exécution restent gouvernées indépendamment, et que chaque invocation d'outil comporte le contexte d'identité de l'utilisateur dans son journal.
La passerelle MCP fournit les hooks de pré-invocation et de post-invocation qui assurent cette application, et les garde-fous évaluent chaque appel d'outil séparément plutôt qu'une seule fois par conversation. Un agent qui appelle cinq outils à la suite fait l'objet de cinq séries de vérifications.
Les hooks de pré-invocation bloquent l'action avant son exécution, couvrant la validation des paramètres, la désinfection SQL et les contrôles d'autorisation rédigés sous forme de politiques Cedar ou OPA. Les hooks de post-invocation inspectent la sortie de l'outil, détectant les injections indirectes et les fuites de secrets avant que l'étape d'observation ne les réinjecte dans le contexte du modèle.
Créez des flux de travail de prompts qui restent gouvernés en production. Réserver une démo pour découvrir comment TrueFoundry connecte le registre de prompts, les garde-fous, le contrôle budgétaire et les journaux d'audit au sein de votre passerelle IA.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















