



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le serveur MCP Snowflake est un point de terminaison MCP géré par Snowflake qui s'exécute au sein d'un compte Snowflake. Le Model Context Protocol est le standard ouvert qui permet à un agent IA de découvrir et d'appeler des outils sur un système externe, et l'implémentation de Snowflake transforme les fonctionnalités Cortex et le SQL brut en outils appelables.
La différence structurelle par rapport à un serveur MCP SaaS hébergé : vous définissez vous-même la surface des outils. Le serveur est créé avec la commande CREATE MCP SERVER ... FROM SPECIFICATION, où la spécification est un fichier YAML listant chaque outil, son type et sa configuration. Rien n'apparaît dans tools/list si vous ne l'avez pas explicitement défini.
Cinq types d'outils sont pris en charge :
Une spécification minimale est simple : une entrée SYSTEM_EXECUTE_SQL avec read_only: true, un délai d'expiration et le nom d'un entrepôt, et vous disposez d'un serveur MCP pour entrepôt de donnéesfonctionnel. Les types d'outils Cortex nécessitent des prérequis, soit un service Cortex Search existant, soit une vue sémantique.
Trois limites à garder à l'esprit : un maximum de 50 outils par serveur, des réponses tronquées à 250 Ko, et les objets serveur MCP sont non répliqué dans les groupes de basculement.
Les cas d'usage pertinents enchaînent les outils plutôt que de lancer une seule requête :
La distinction entre lecture et écriture prend ici une autre dimension. Sur un entrepôt de données, la lecture est le côté risqué. Une écriture erronée corrompt généralement une table que l'on peut restaurer. Une lecture erronée peut silencieusement exposer les données personnelles de tous les clients et coûter des centaines de dollars en ressources de calcul avant que quiconque ne s'en aperçoive.
Qu'un analyste connecte un client MCP à son propre compte, c'est acceptable. Que trente le fassent, c'est une autre paire de manches.
Le coût de calcul devient une décision prise par l'agent. Snowflake facture le calcul de l'entrepôt à la seconde près pendant son exécution, avec une facturation minimale à chaque reprise. Un agent qui rédige son propre SQL décide, sans supervision, s'il doit scanner une partition ou un pétaoctet, et une clause WHERE manquante sur une grande table de faits est une erreur d'une ligne qui peut entraîner une facture à quatre chiffres. Les agents effectuent également des tentatives de nouvelle tentative : un appel qui expire au bout de 600 secondes et qui est relancé cinq fois correspond à cinq scans complets, sans aucun protocole pour l'arrêter. C'est le seul serveur où les métriques d'outils et les limites de débit sont une question de contrôle budgétaire, et non une simple commodité opérationnelle.
Ampleur de la lecture. Un entrepôt est le seul système où toutes les données sensibles ont déjà été regroupées. Votre dépôt contient des secrets ; votre système de tickets contient des noms de clients. Votre entrepôt contient des commandes associées à des utilisateurs, eux-mêmes associés à des paiements, dans un schéma accessible à un rôle étendu. Une seule requête SELECT trop large représente une exposition plus importante que tout ce qu'un agent pourrait faire dans Git ou Jira, et elle ne laisse aucune trace des dommages. Les données s'échappent tout simplement.
Les identifiants partagés détruisent l'imputabilité. Si chaque agent s'authentifie en tant qu'utilisateur de service unique avec un rôle unique, chaque ligne de l'historique des requêtes de Snowflake affiche le même acteur. Vous ne pouvez pas répondre à la question « quel agent, agissant pour le compte de qui, a lu la table des paiements à 2 heures du matin », et une politique par utilisateur est impossible car il n'existe qu'un seul utilisateur.
Personne ne possède la spécification. Deux équipes rédigeront deux versions, l'une prudente et l'autre avec read_only: false et sans délai d'expiration, et personne ne contrôle les agents de production utilisés.
C'est un argument en faveur d'un plan de contrôle en amont, ce à quoi sert une passerelle MCP .
Snowflake n'est pas une entrée de catalogue en un clic. Le point de terminaison réside dans votre compte et son URL est spécifique au compte ; vous devez donc d'abord effectuer la configuration côté Snowflake, puis enregistrer l'URL obtenue via Connecter n'importe quel serveur MCP distant.
Vous avez besoin d'un compte Snowflake sur un forfait payant, étant donné que l'exécution SQL est bloquée sur les versions d'essai, et qu'il vous faut les privilèges ACCOUNTADMIN ou CREATE INTEGRATION global, un entrepôt de données (warehouse) activable, l'URL de votre compte écrite avec des traits d'union plutôt que des traits de soulignement, ainsi qu'un TrueFoundry Groupe de serveurs MCP.
Étape 1 : créer l'objet serveur MCP. Dans une feuille de calcul SQL Snowsight (Projets > Feuilles de calcul, et non sur l'écran d'ingestion), exécutez CREATE OR REPLACE MCP SERVER avec votre spécification d'outil. La base de données, le schéma et le nom du serveur font partie de l'URL du connecteur ; choisissez donc un schéma inscriptible qui n'est pas un schéma système et évitez d'utiliser le caractère $ dans les noms.
Étape 2 : créer l'intégration de sécurité OAuth. Seul un ACCOUNTADMIN peut le faire. Utilisez TYPE = OAUTH, OAUTH_CLIENT = CUSTOM, OAUTH_CLIENT_TYPE = 'CONFIDENTIAL' pour que le secret reste côté serveur, OAUTH_ISSUE_REFRESH_TOKENS = TRUE, une durée de validité du jeton d'actualisation en secondes, et OAUTH_ENFORCE_PKCE = TRUE. L'URI de redirection est le rappel indiqué sur le formulaire Ajouter un serveur MCP de TrueFoundry :
https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback
Un piège à éviter : ne pas ajouter une BLOCKED_ROLES_LIST contenant ACCOUNTADMIN ou SECURITYADMIN. OAUTH_ADD_PRIVILEGED_ROLES_TO_BLOCKED_LIST les bloque déjà par défaut ; les lister explicitement provoquerait une erreur. Récupérez les identifiants avec SYSTEM$SHOW_OAUTH_CLIENT_SECRETS('<INTEGRATION_NAME>'), en majuscules.
Étape 3 : créer un rôle non administrateur et accorder les accès. Les rôles d'administration étant bloqués pour OAuth, l'utilisateur doit disposer d'un rôle par défaut sans privilèges élevés. Accordez le droit USAGE sur l'entrepôt, la base de données, le schéma et le serveur MCP, puis accordez les privilèges par outil séparément, comme USAGE ON CORTEX SEARCH SERVICE ou SELECT ON SEMANTIC VIEW. L'accès au serveur ne pas donne accès à ses outils. Définissez DEFAULT_ROLE et DEFAULT_WAREHOUSE pour l'utilisateur ; la session OAuth ne s'initialisera pas sans eux.
Étape 4 : autoriser la sortie (egress) de la passerelle. Si des politiques réseau sont activées, ajoutez les adresses IP de sortie de TrueFoundry à votre liste blanche. La passerelle établit une connexion serveur à serveur depuis l'infrastructure TrueFoundry, et non depuis le navigateur de l'utilisateur ; une session de navigation active ne prouve donc rien. Pour les comptes PrivateLink, enregistrez l' URL publique du compte et maintenez le point de terminaison du jeton public.
Étape 5 : enregistrement dans TrueFoundry. Dans votre groupe de serveurs MCP, cliquez sur Ajouter un serveur MCP et choisissez Connecter tout serveur MCP distant.
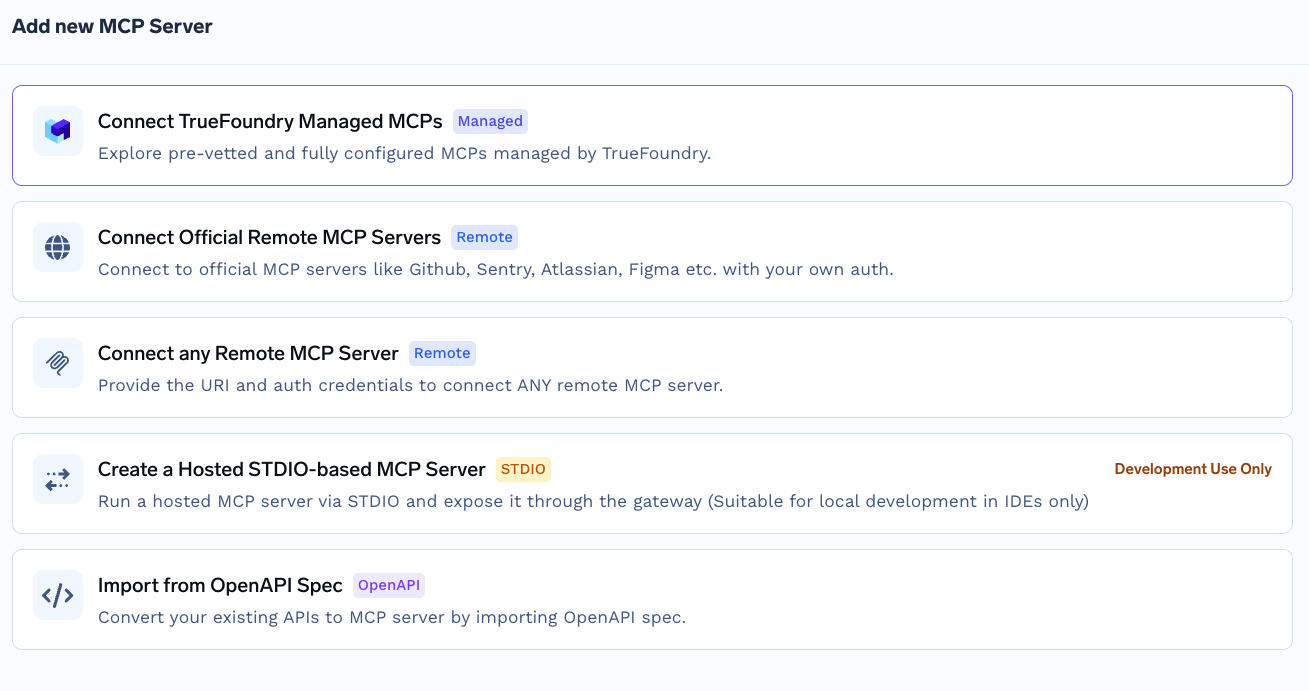
Saisissez l'URL du serveur MCP, qui suit ce format :
https://<account_url>/api/v2/databases/<database>/schemas/<schema>/mcp-servers/<server_name>
Sélectionnez OAuth2 avec le type d'octroi Code d'autorisation, puis renseignez l'URL d'autorisation https://<account_url>/oauth/authorize, l'URL du jeton https://<account_url>/oauth/token-request, ainsi que votre identifiant client et votre secret, Méthodes de défi de code prises en charge S256, Source JWT Jeton d'accès, et Portées refresh_token. Configurez le contrôle d'accès, puis Enregistrer. Stockez l'identifiant client et le secret dans le coffre-fort de secrets TrueFoundry et référencez le FQN plutôt que de les intégrer directement.
Concernant les portées : conservez refresh_token, car sans lui, les sessions expirent environ toutes les dix minutes. Supprimez l'autre option, session:role:<role> : le serveur l'ignore, puisqu'il résout le rôle à partir de DEFAULT_ROLE, et cela ajoute un risque d'erreur lié à la casse.
TrueFoundry maintient l' authentification entrante , c'est-à-dire la manière dont un client s'authentifie auprès de la passerelle, séparément de l' authentification sortante, c'est-à-dire la manière dont la passerelle s'authentifie auprès de Snowflake. Ces deux couches sont indépendantes.
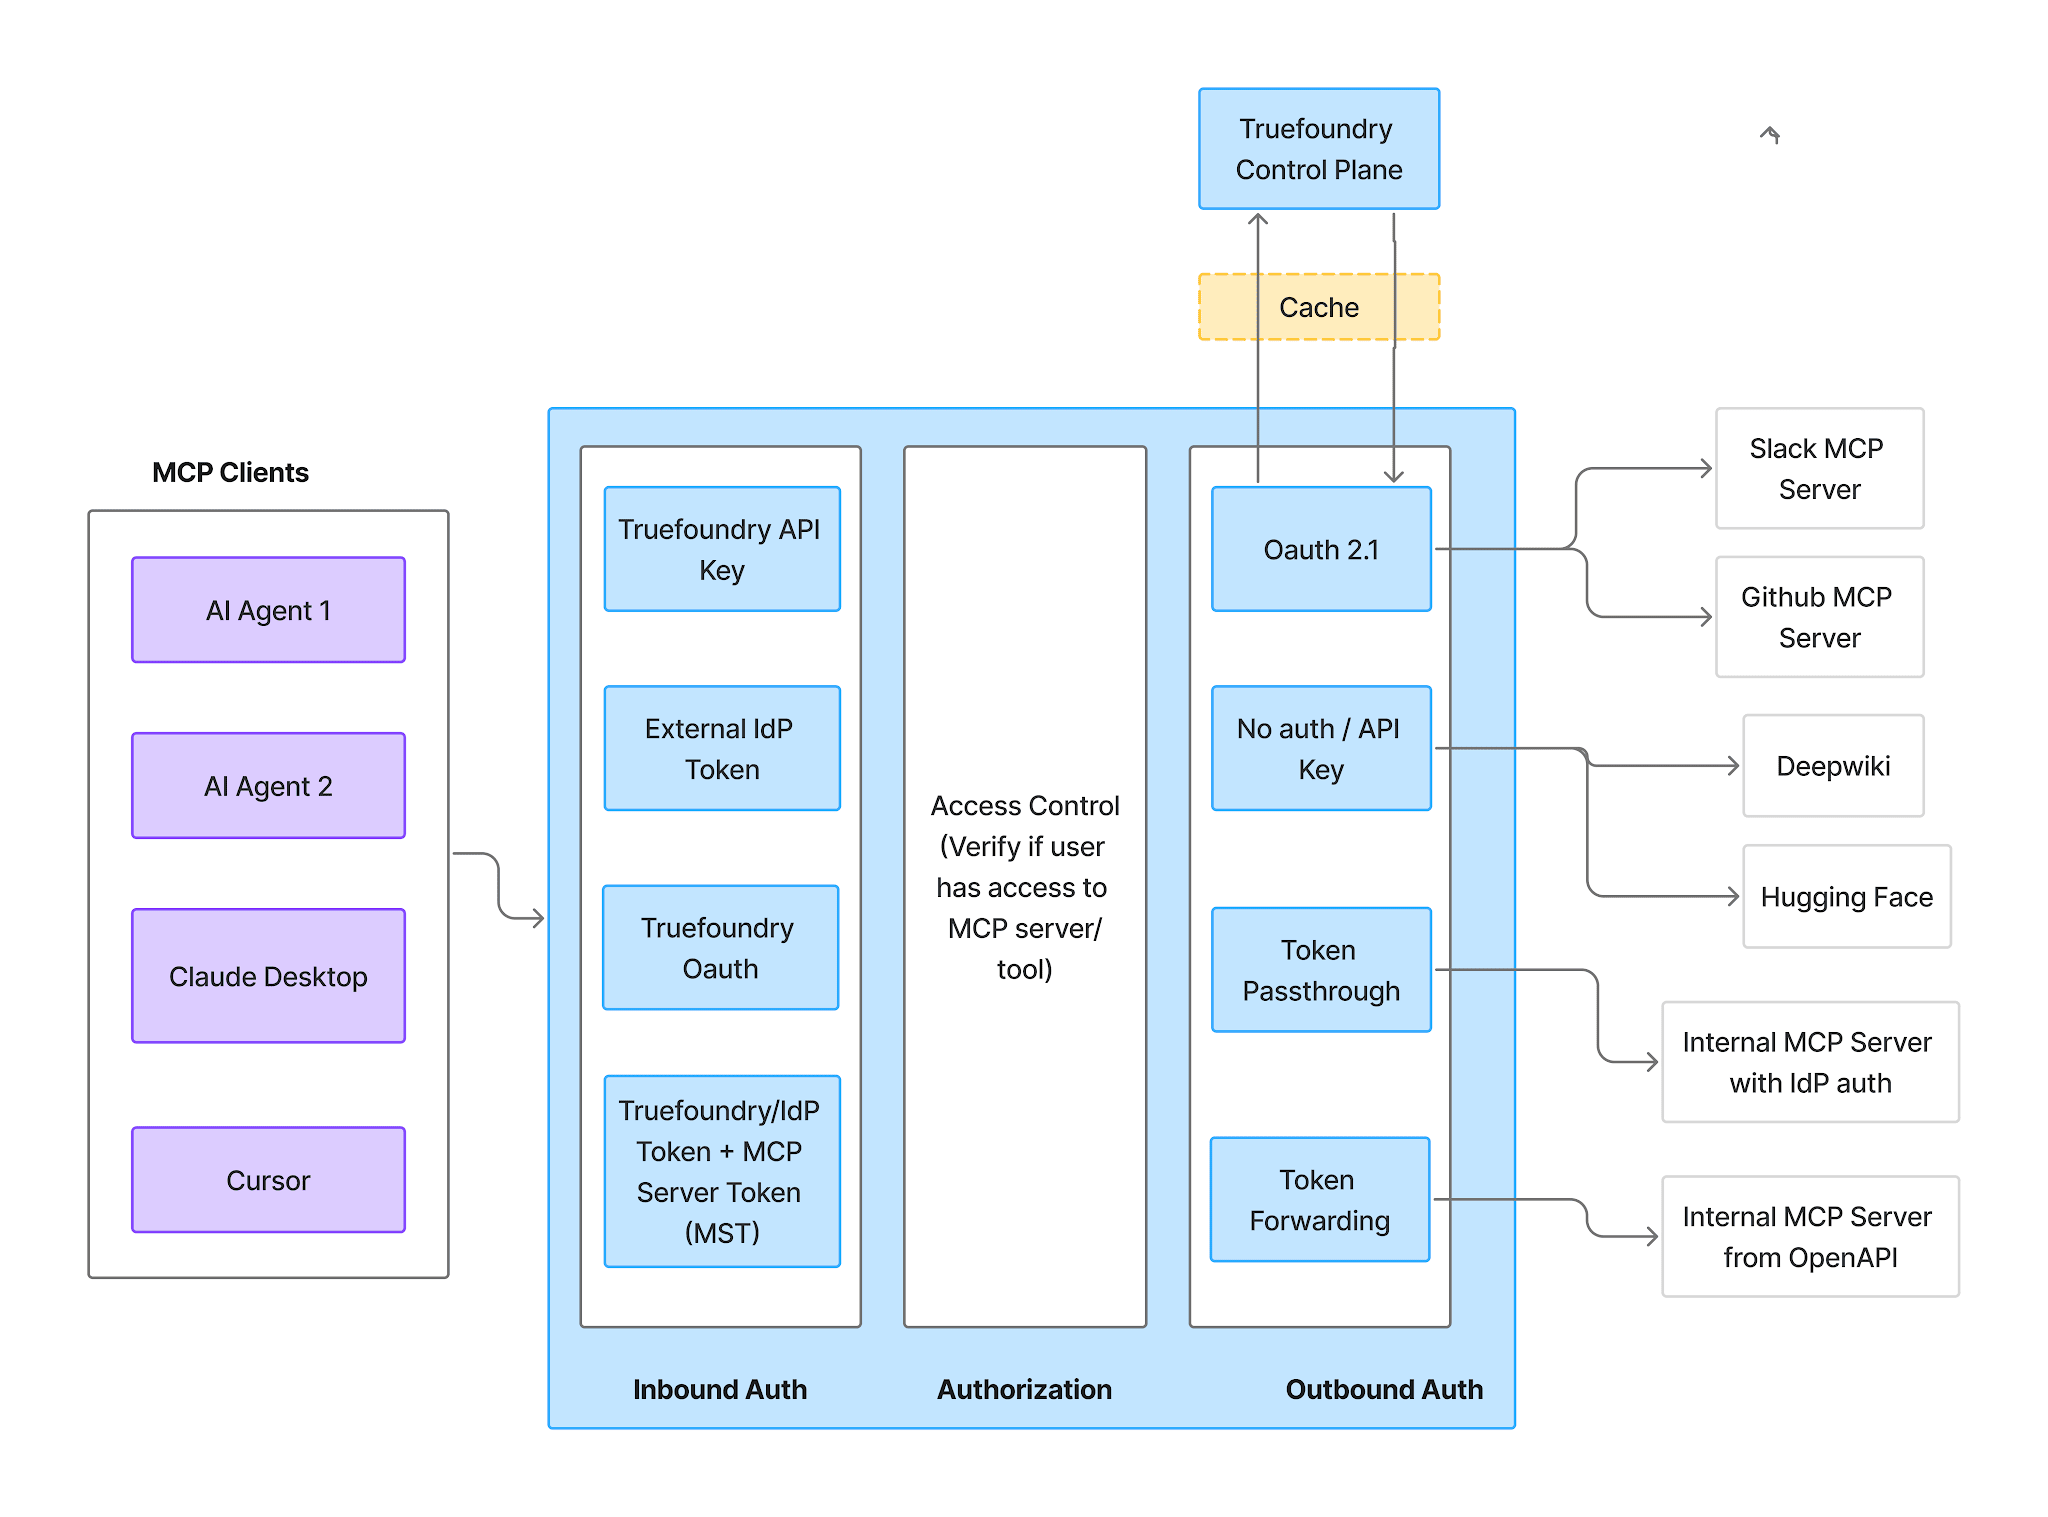
L'authentification entrante prend en charge quatre méthodes :
Les jetons de compte virtuel accordent un accès identique à chaque requête, ils sont donc inutilisables ici. Pour un entrepôt, où tout l'argument de sécurité repose sur le fait que chaque personne hérite de son propre rôle, utilisez un PAT ou un jeton IdP en entrée.
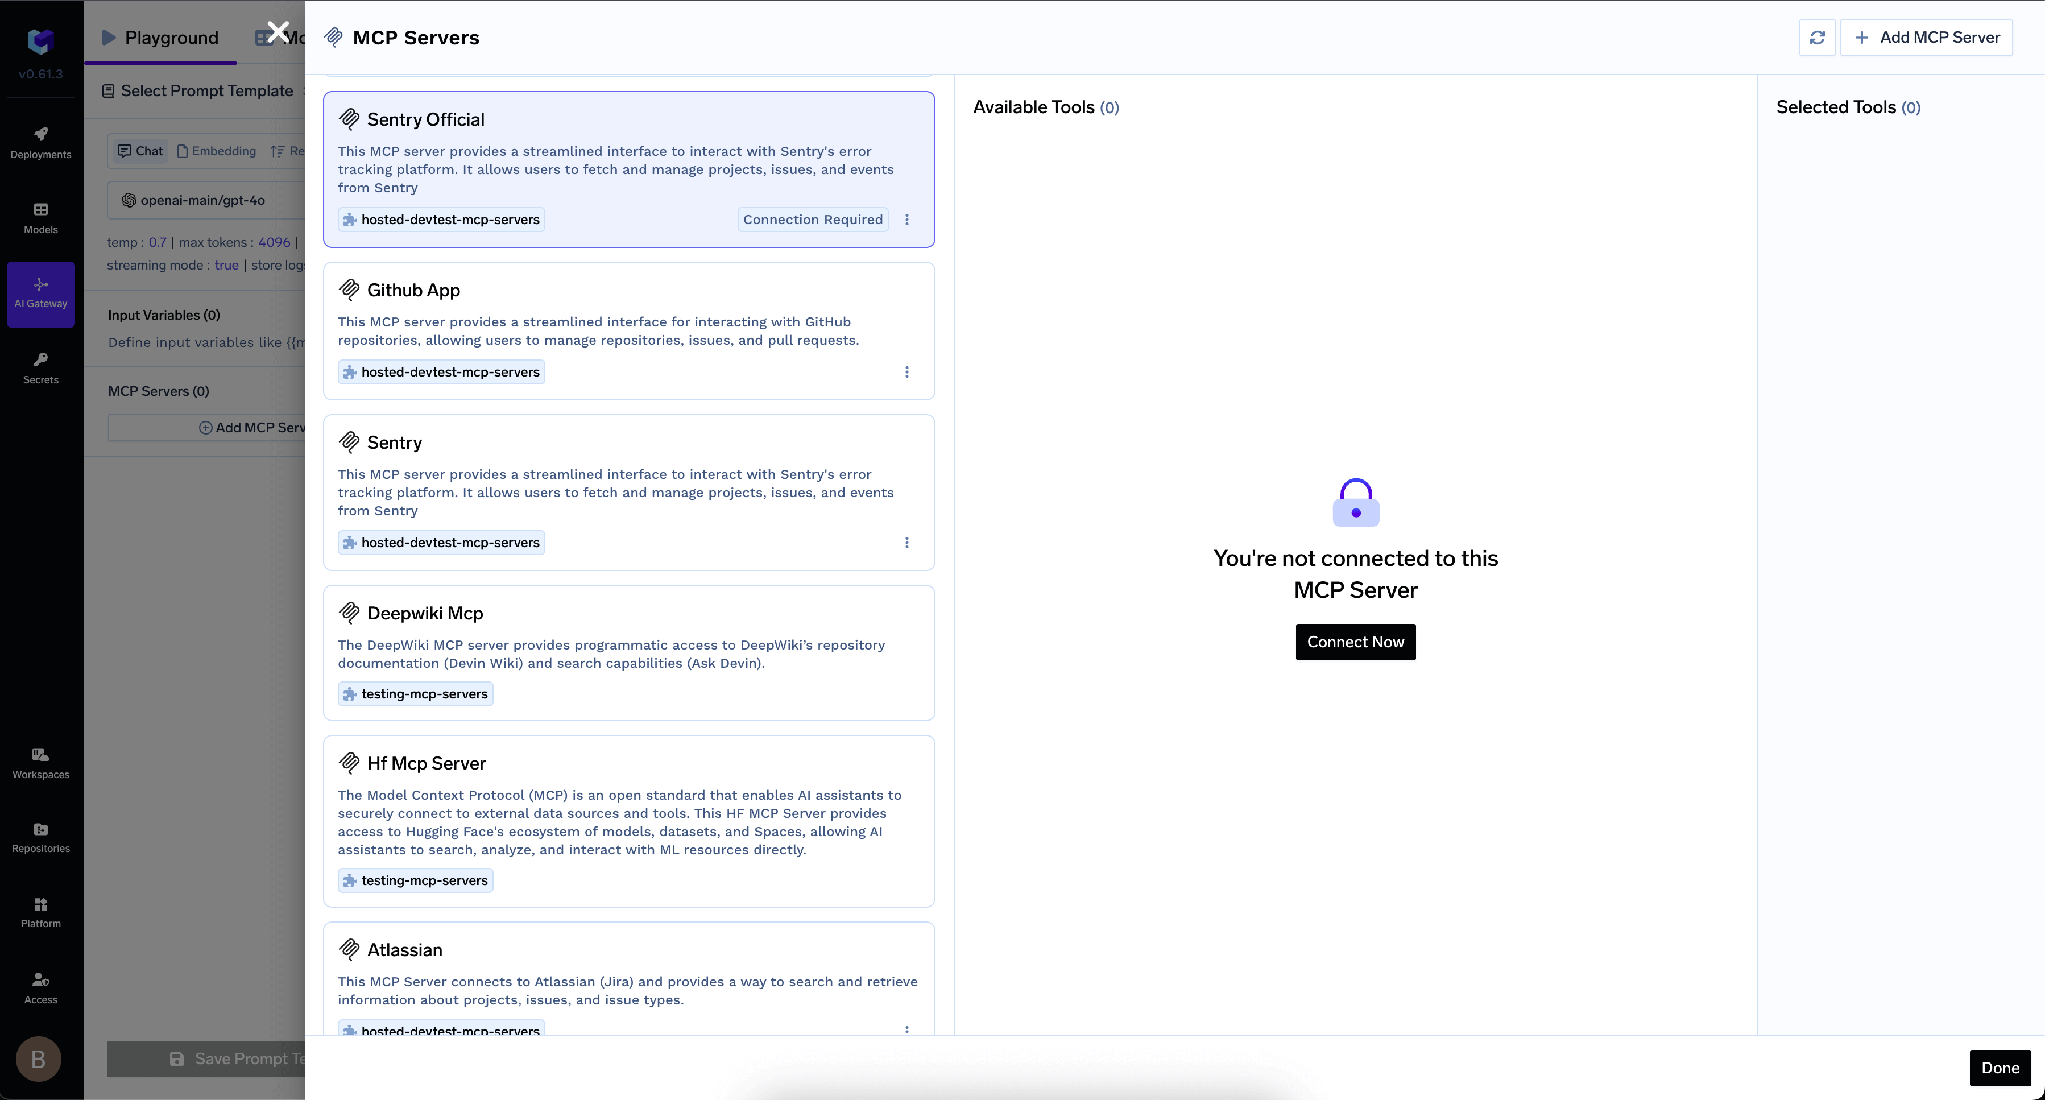
L'authentification sortante est basée sur Snowflake OAuth via l'intégration que vous avez créée. Pour autoriser, ouvrez le serveur Outils section, ou Ajouter des serveurs d'outils/MCP dans le Playground, puis cliquez sur Connecter maintenant. Vous êtes redirigé vers Snowflake pour donner votre consentement, et TrueFoundry ne voit jamais vos identifiants.
C'est cette partie qui protège vos données. Chaque utilisateur opère selon ses propres autorisations RBAC Snowflake, résolues via son DEFAULT_ROLE. La passerelle ne décide pas des lignes que vous pouvez voir. C'est Snowflake qui le fait. Tout ce que vous avez déjà configuré s'applique sans changement : attributions de rôles sur les bases de données, schémas et tables, ainsi que les politiques d'accès aux lignes et le masquage dynamique des données si vous les utilisez, ces deux derniers nécessitant Snowflake Enterprise Edition ou une version supérieure [À VÉRIFIER]. Un agent agissant pour un analyste junior voit exactement ce que cet analyste voit.
Clarifions la répartition des tâches : la passerelle définit quels outils existent, Snowflake définit quelles lignes sont renvoyées. Désactiver un outil ne peut pas empêcher la lecture d'une table à laquelle un rôle avait déjà accès, et restreindre un rôle ne peut pas empêcher un agent d'utiliser un outil d'écriture que vous avez laissé activé. Consultez l'authentification MCP pour en savoir plus sur ces deux couches.
Si chaque client possède son propre compte Snowflake, un identifiant client unique ne peut pas les couvrir ; vous devez donc enregistrer une entrée distincte par compte.
Une fois connecté, l'onglet Outils liste tout ce que le serveur expose.
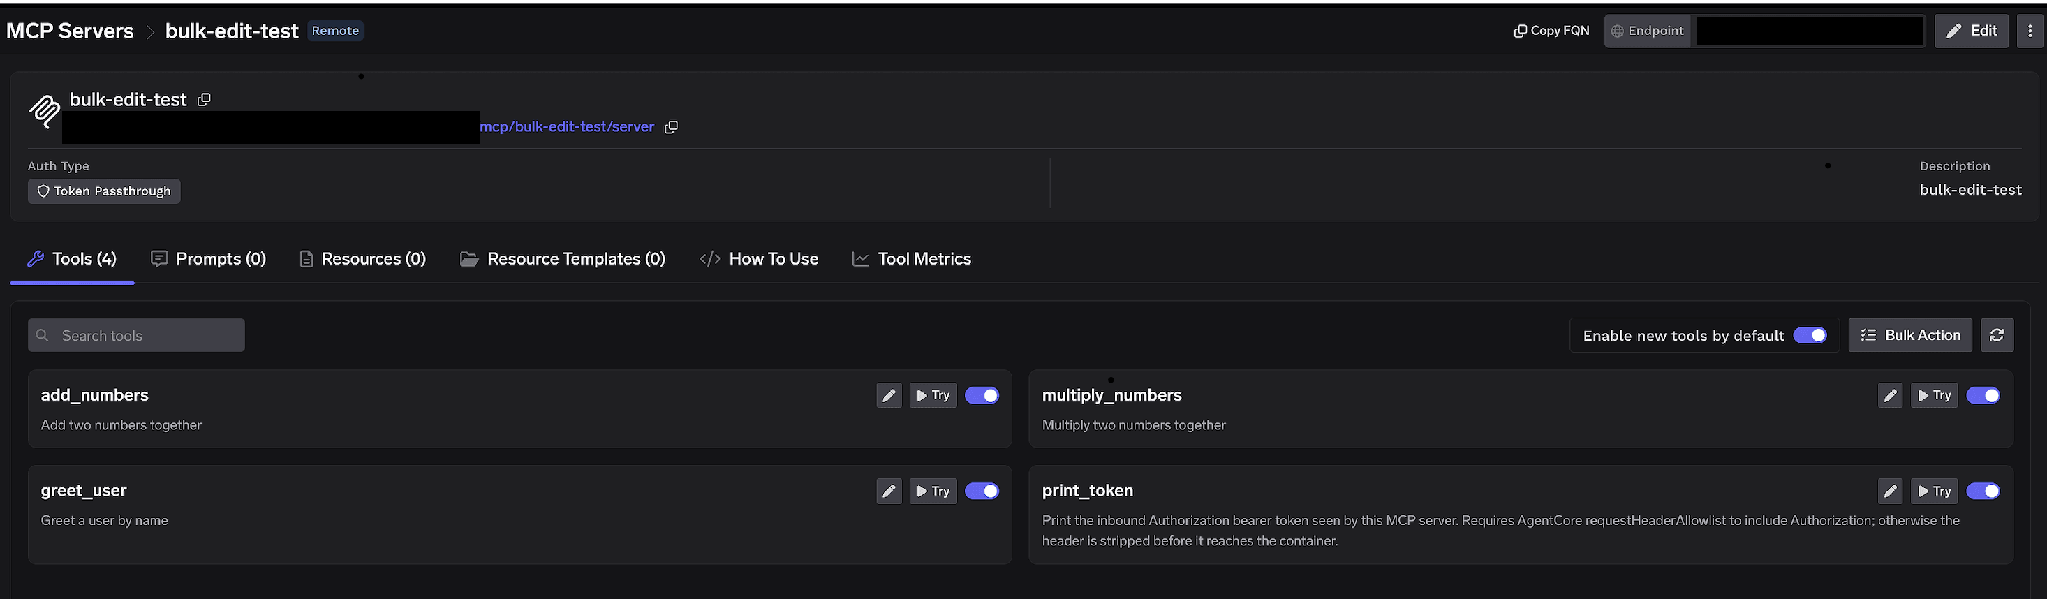
Commutateurs par outil. Désactivez un outil pour qu'il soit entièrement omis de la liste des outils. Les clients ne le voient jamais et ne peuvent pas l'appeler ; il ne s'agit pas d'un filtrage au niveau du prompt. Le modèle courant dans les entrepôts de données consiste à laisser Cortex Analyst et Cortex Search activés tout en désactivant SYSTEM_EXECUTE_SQL brut. Les analystes conservent l'interrogation en langage naturel via une vue sémantique que vous avez organisée, et l'agent perd la capacité de composer du SQL arbitraire sur des tables arbitraires. C'est à la fois plus économique et plus sûr.
Activer les nouveaux outils par défaut. Si cette option est activée, les outils ajoutés à la spécification Snowflake sont automatiquement accessibles aux agents. Si elle est désactivée, seuls les outils que vous avez explicitement activés sont accessibles. Étant donné que la spécification est modifiée par toute personne disposant des privilèges Snowflake plutôt que par le propriétaire de la passerelle, la désactivation est la solution appropriée : une modification de la spécification ne peut alors pas élargir silencieusement les capacités des agents en production. Action groupée transforme chaque ligne en case à cocher pour vous permettre d'en modifier plusieurs à la fois.
Cliquez sur le crayon sur n'importe quel outil pour remplacer la façon dont il est présenté au modèle :
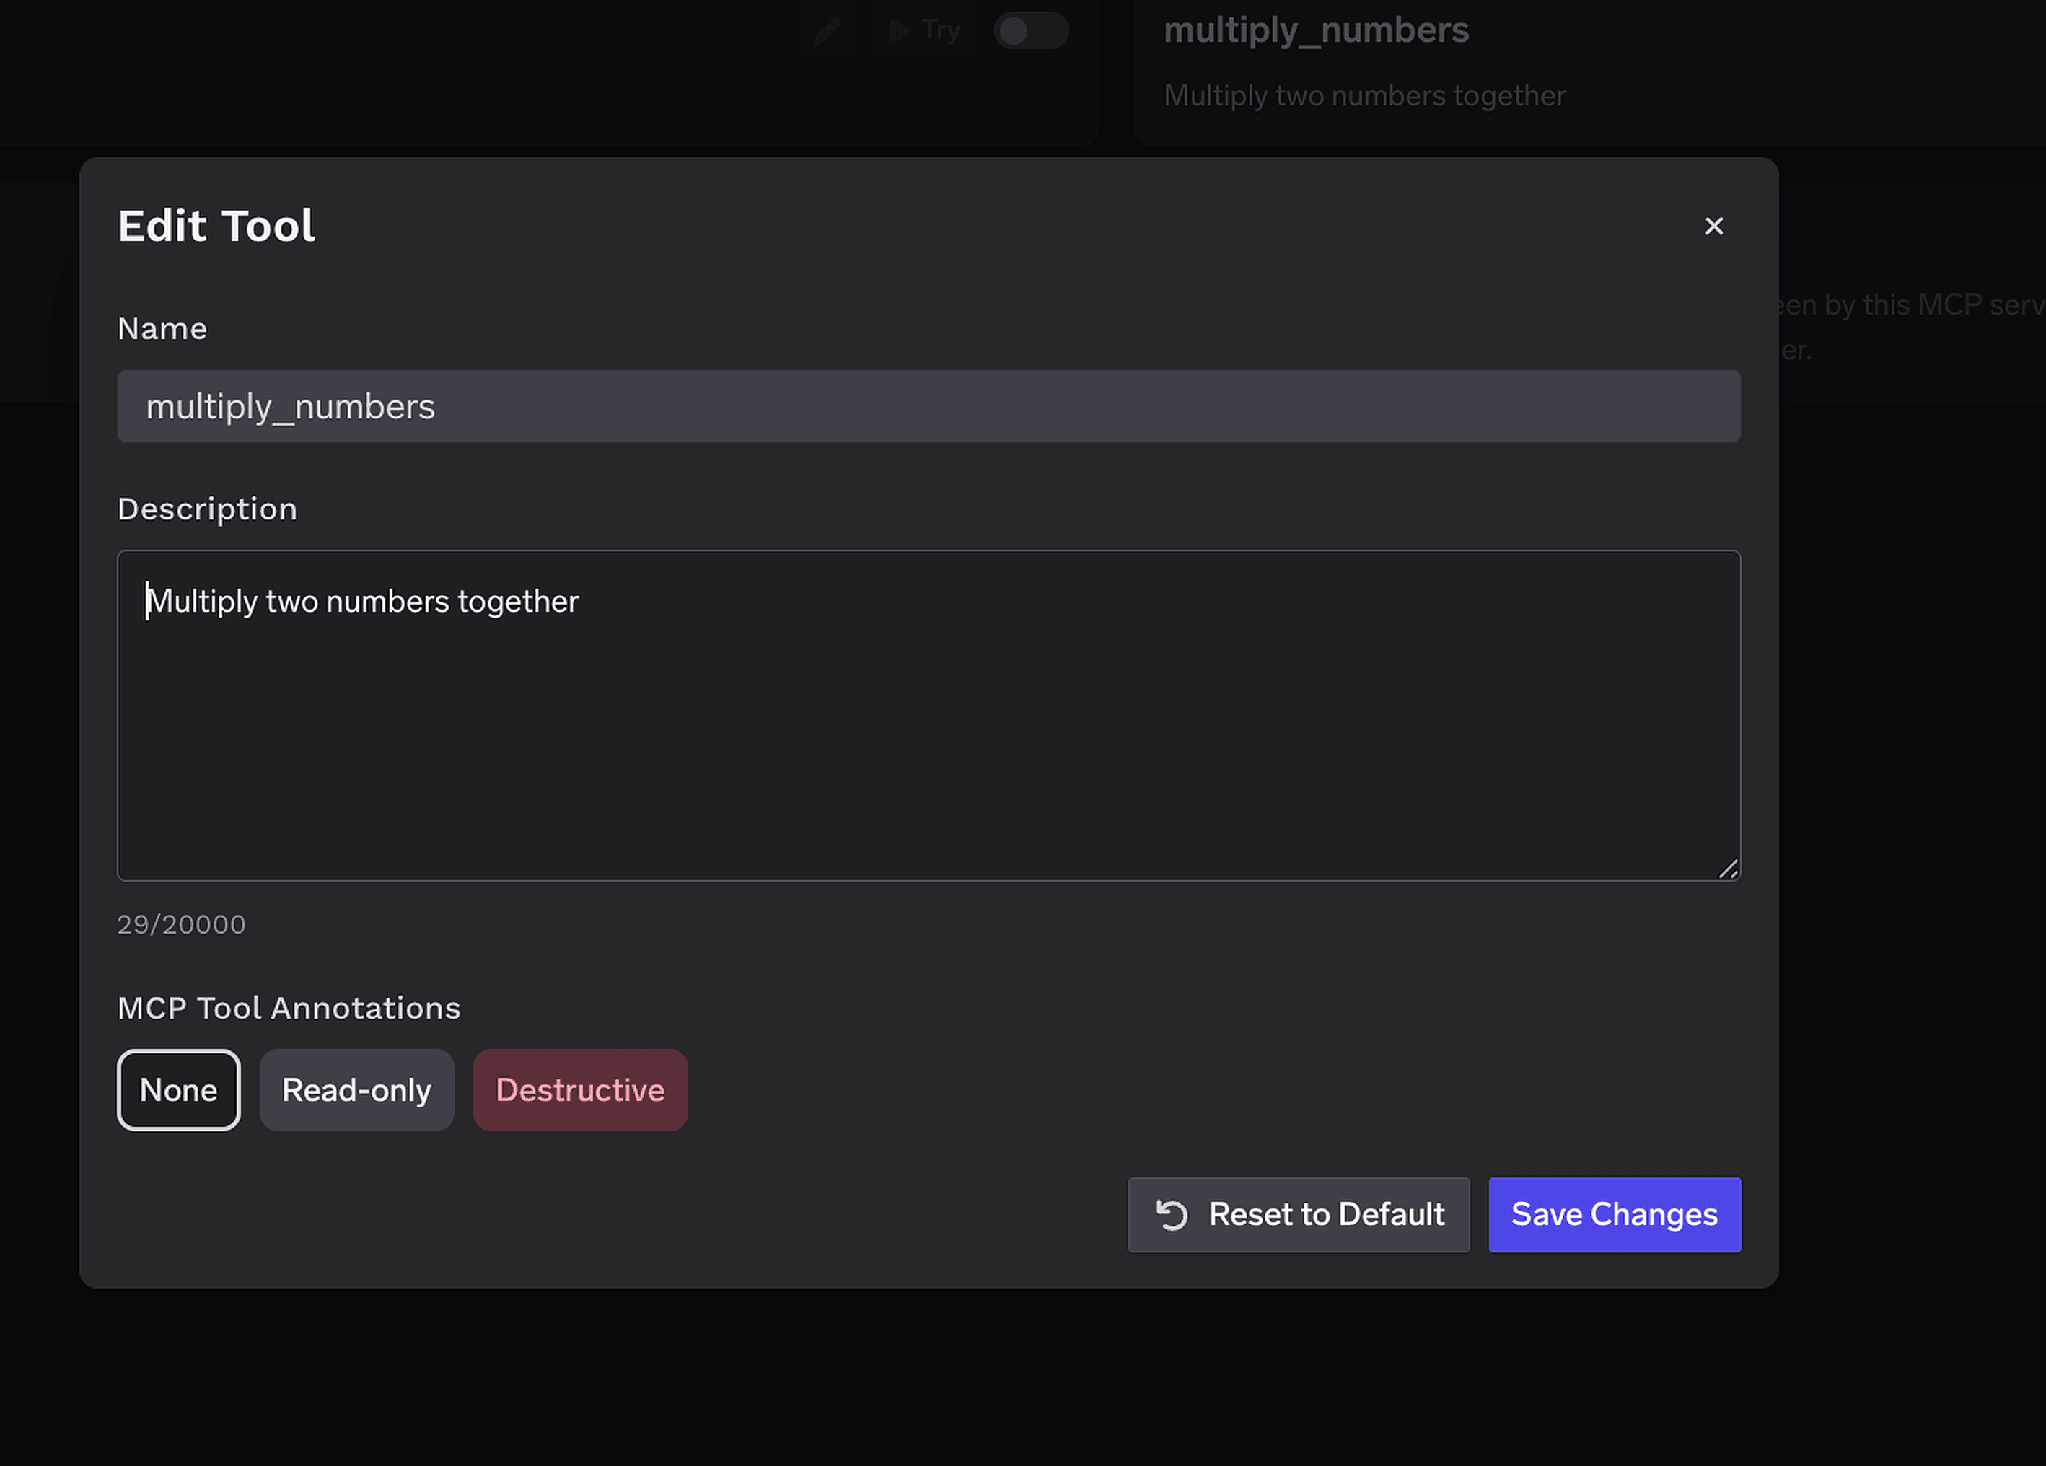
Le Description de remplacement, pouvant aller jusqu'à 20 000 caractères, est particulièrement utile ici. Les descriptions des outils Snowflake correspondent à ce que vous avez saisi dans la spécification, et une description vague pousse le modèle à utiliser SYSTEM_EXECUTE_SQL alors qu'un outil d'analyse organisé aurait pu répondre à la question. Annotations d'outil MCP marquent un outil comme Lecture seule ou Destructif, définissant readOnlyHint ou destructiveHint, et alimentant les politiques d'approbation ci-dessous.
Le contrôle d'accès s'applique aux utilisateurs, aux équipes ou aux comptes virtuels, selon deux dimensions : les serveurs auxquels une identité peut accéder et les outils qu'elle peut invoquer.
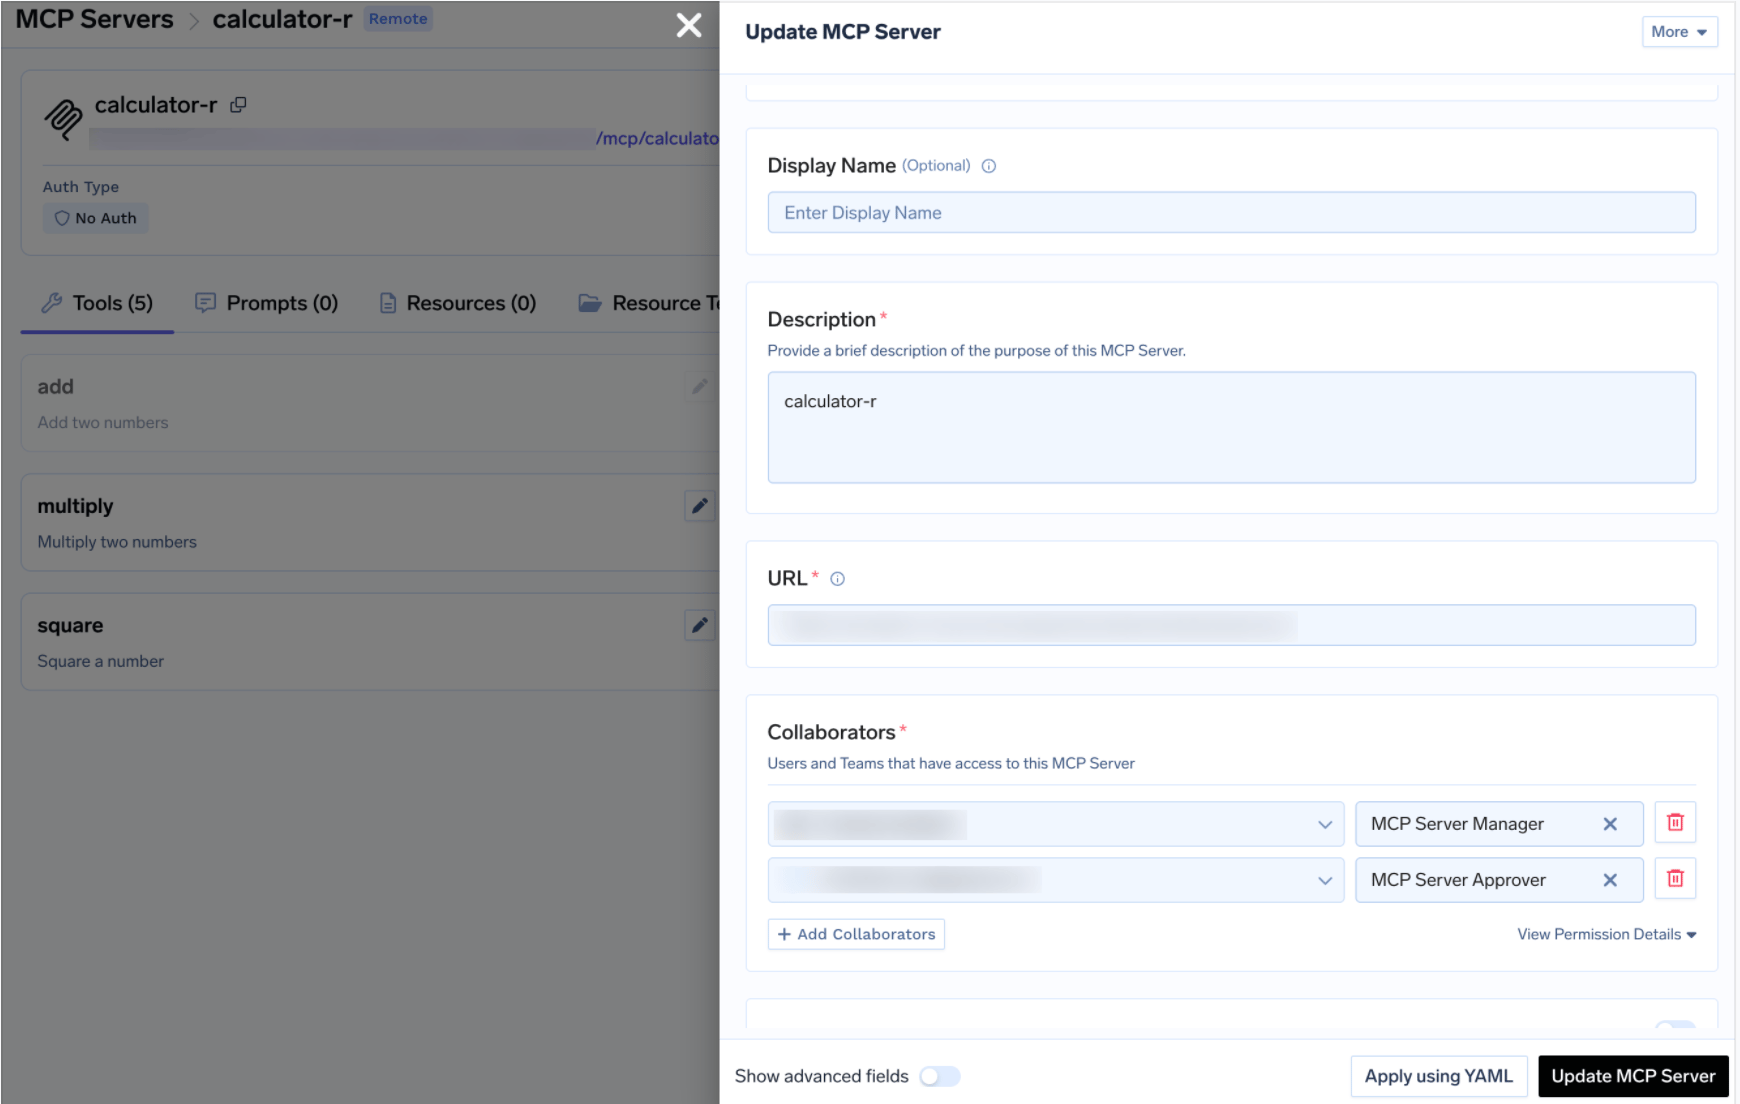
L'équipe plateforme détient le rôle Manager, les équipes analytiques le rôle User, et un responsable de la gouvernance le rôle Approver. Il s'agit du même contrôle d'accès MCP modèle utilisé sur chaque serveur du registre.
Désactiver les outils est une solution radicale. Parfois, vous souhaitez qu'un agent puisse écrire dans une table ou exécuter une requête illimitée, mais pas sans surveillance. Lorsqu'un outil soumis à approbation est appelé, l'appel est mis en attente, une demande d'approbation est créée et les approbateurs sont notifiés. Une fois l'approbation humaine obtenue, les appels réussissent pendant une fenêtre de temps configurable. Créez une politique sous AI Gateway > Policies > MCP Tool Approval, marquée comme Beta dans la console :
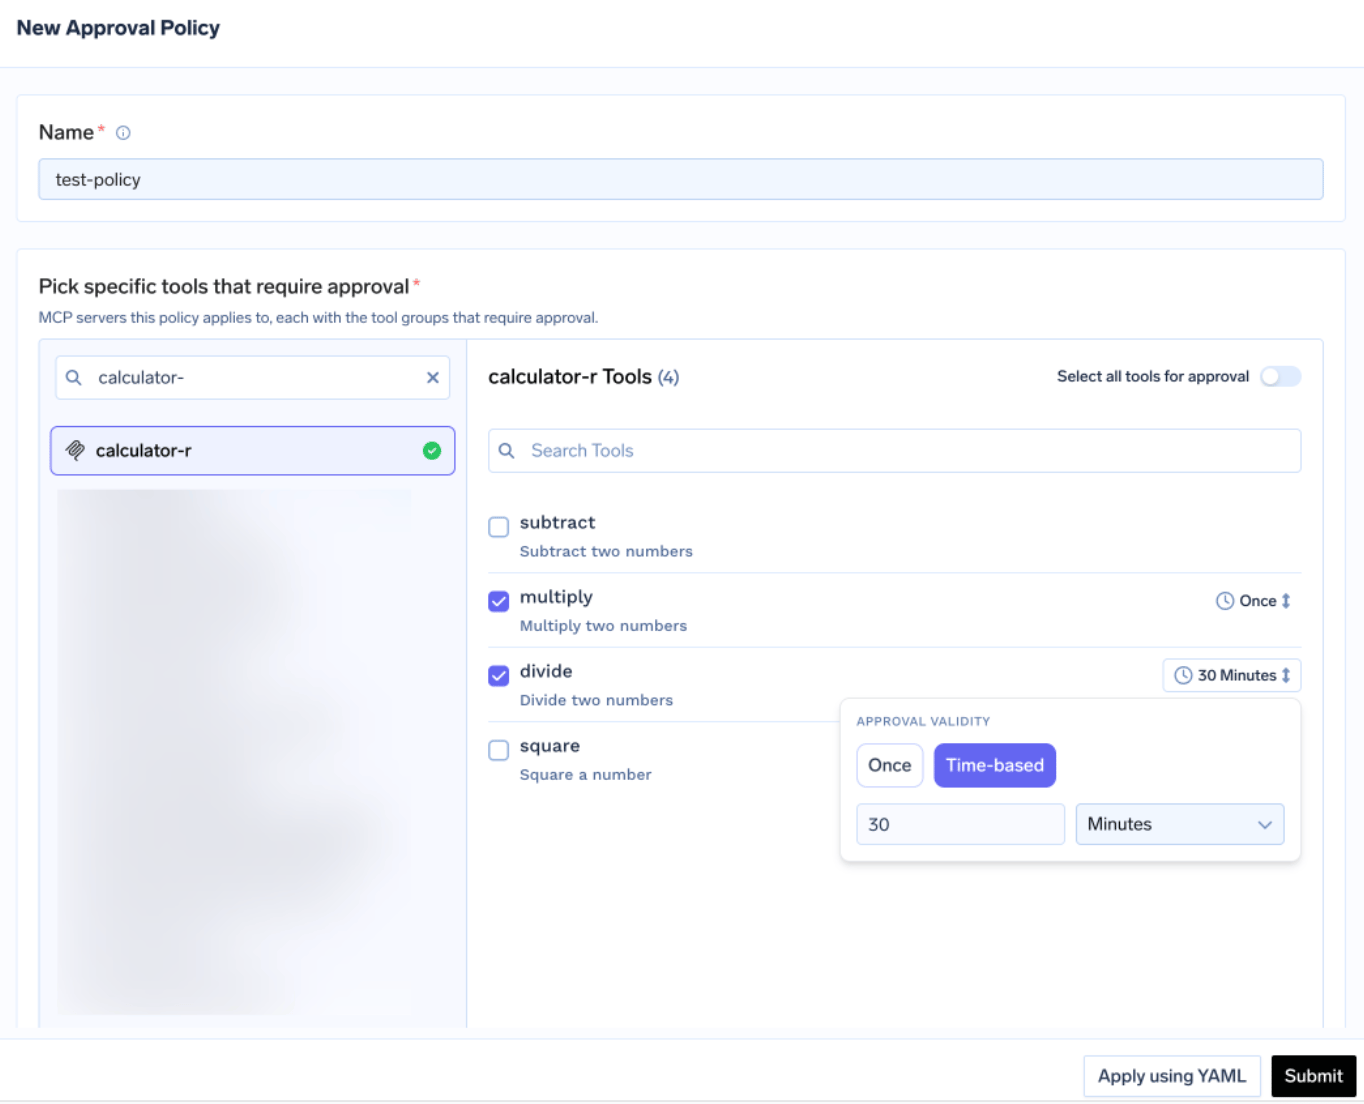
Chaque politique nomme les serveurs qu'elle contrôle et définit une portée d'approbation:
Pour Snowflake, cibler l'outil d'exécution SQL est généralement la bonne approche : laissez les outils Cortex sélectionnés fonctionner librement et soumettez chaque appel SQL brut à une vérification humaine. Lorsque les portées se chevauchent, la plus spécifique l'emporte : le nom spécifique prime sur le destructif, qui prime sur tout le reste. La validité est soit « Une seule fois » ou basée sur une durée en minutes. En cas de conflit entre les politiques, la plus restrictive l'emporte : « Une seule fois » prime sur une fenêtre de 10 minutes, qui prime elle-même sur une fenêtre de 30 minutes.
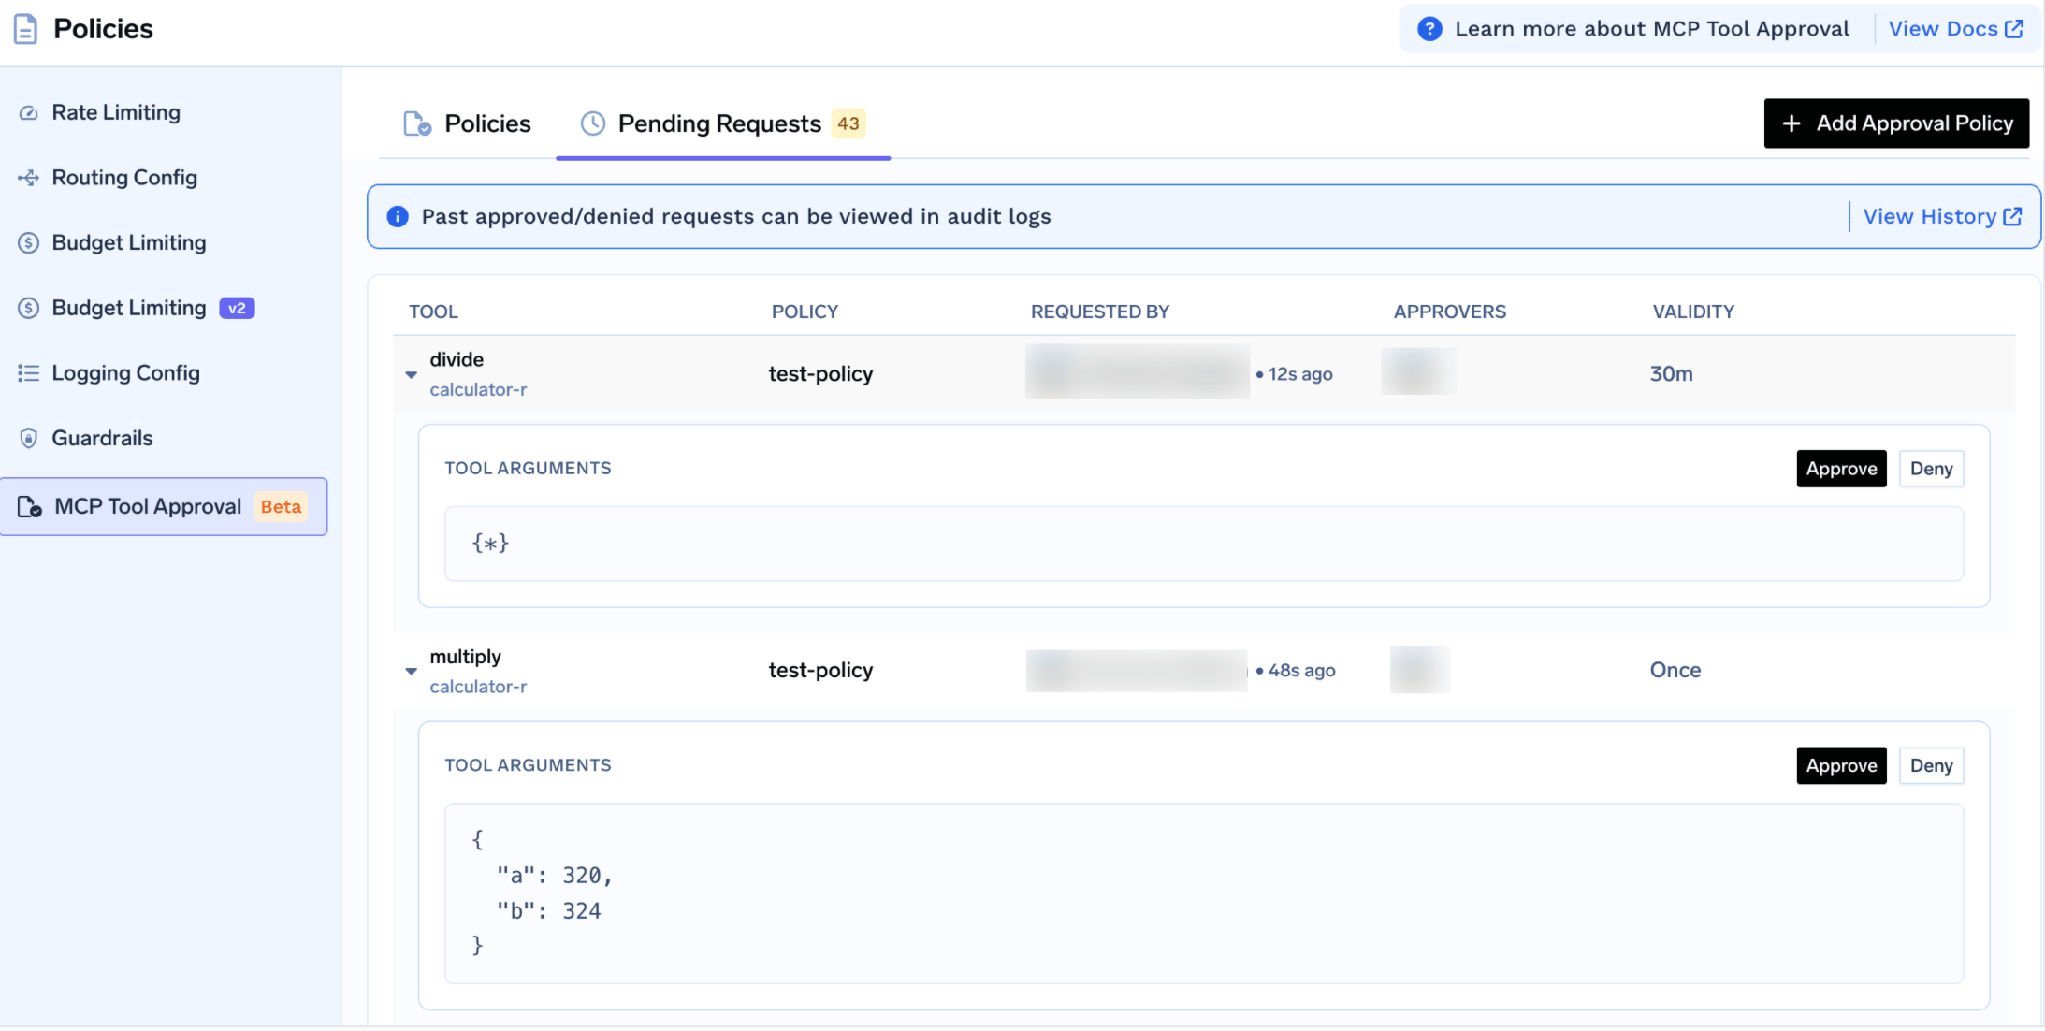
Les approbateurs sont notifiés par e-mail, Slack, PagerDuty ou MS Teams, et chaque demande affiche l'outil, la politique, le demandeur et les arguments réels de l'outil. Sur un entrepôt de données, cette dernière partie est essentielle : un approbateur lit la chaîne SQL littérale avant son exécution, ce qui permet à un humain de détecter une jointure croisée illimitée avant qu'elle n'apparaisse sur la facture du mois suivant. Pendant l'attente, l'appelant reçoit un résultat JSON-RPC contenant _meta.approval_status: "pending" au lieu d'une erreur, permettant ainsi à un agent bien conçu de patienter plutôt que de planter.
Les autorisations sont définies par demandeur ; ainsi, l'approbation pour un analyste ne vaut pas approbation pour toute l'équipe.
Avant de configurer un agent, testez les outils manuellement. Cliquez sur Essayer à côté d'un outil, renseignez les paramètres, puis cliquez sur Exécuter l'outil pour lire le JSON brut. Essayer est désactivé pour les outils que vous avez désactivés.
C'est ici que les erreurs de configuration sont identifiées à moindre coût. Un outil qui génère une erreur est presque toujours dû à une autorisation manquante, car USAGE ON MCP SERVER permet la découverte mais pas l'exécution. Un outil qui ne répond plus signifie généralement qu'aucun entrepôt par défaut n'est défini, ou que celui-ci ne peut pas être réactivé.
Ouvrez l'onglet Comment utiliser pour obtenir l'URL de passerelle spécifique à votre locataire et des extraits de code prêts à l'emploi.
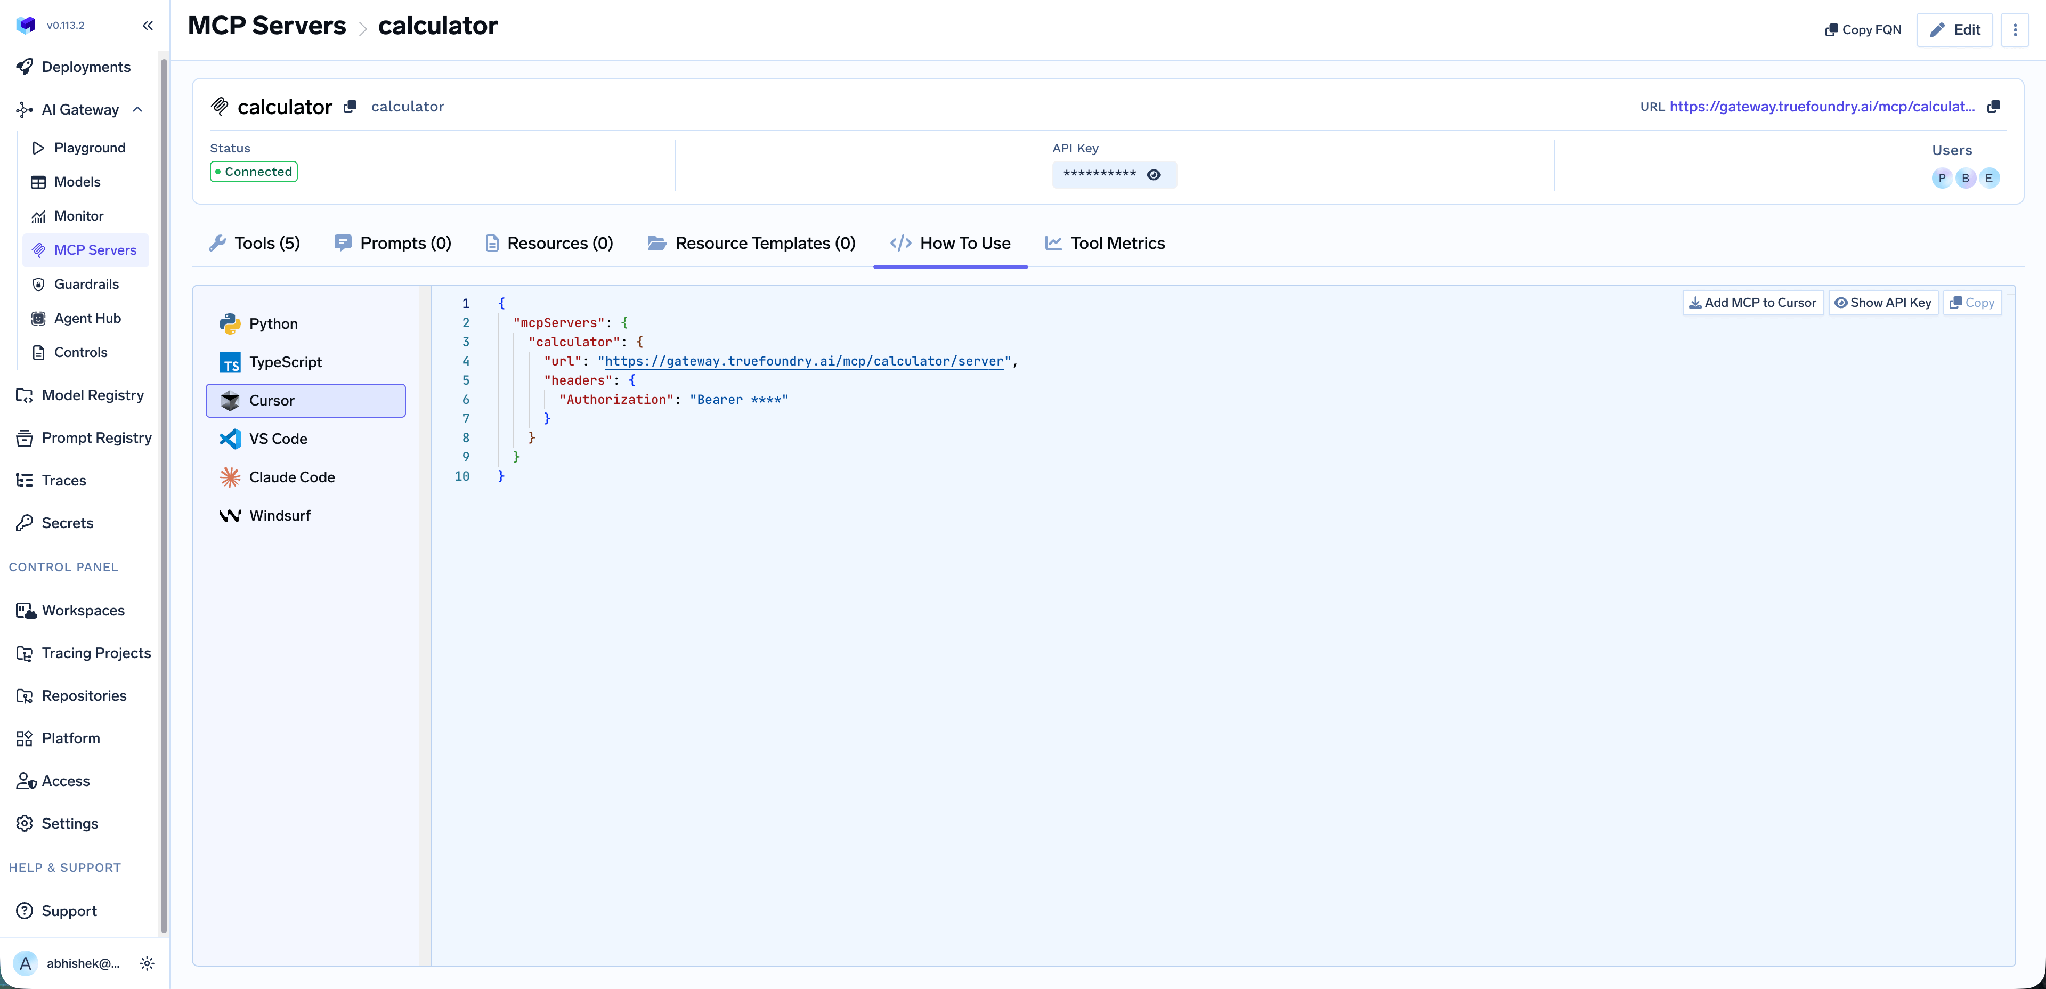
Cela couvre Claude Code, VS Code, Claude Desktop, Cursor, Windsurf, Codex, ainsi que les SDK MCP pour Python et TypeScript. Utilisez l'URL fournie dans cet onglet plutôt que de la composer vous-même ; un point de terminaison créé manuellement est la cause la plus fréquente d'un client qui se connecte mais n'affiche aucun outil.
Sur un entrepôt, la couche opérationnelle est le moyen de savoir ce que vos agents vous coûtent.
Métriques au niveau des outils. Le tableau de bord des métriques MCP détaille les requêtes par seconde, la latence aux percentiles P50/P75/P90/P99, le taux d'échec par type d'erreur et un classement du nombre de requêtes par outil.
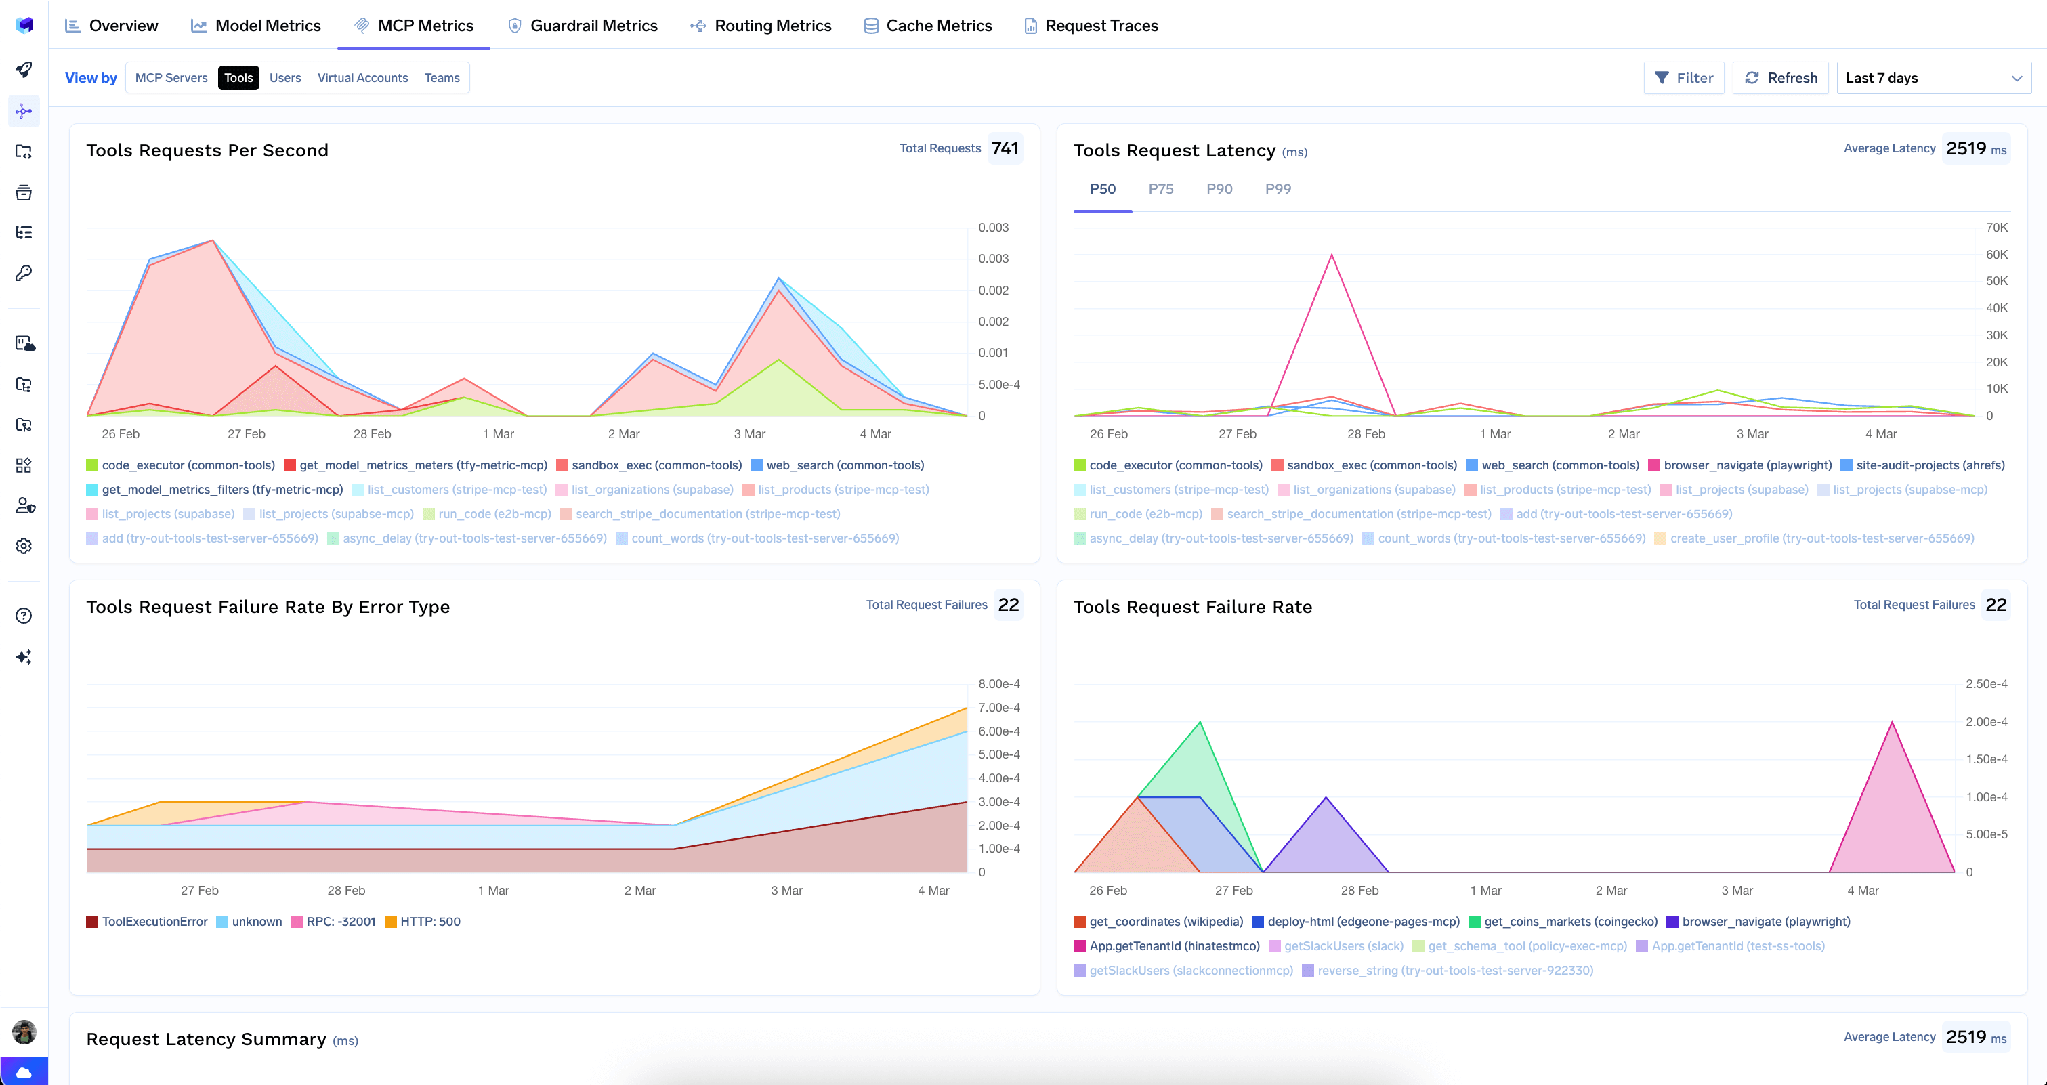
Considérez ceci comme un tableau de bord de dépenses, et non de latence. La latence P99 sur un outil SQL est un indicateur de la puissance de calcul consommée par une longue traîne de requêtes, et un taux d'échec croissant associé à une augmentation du nombre d'appels est le signe d'une boucle de tentatives épuisant vos crédits. Rien de tout cela ne remplace les contrôles natifs de Snowflake : maintenez un moniteur de ressources sur l'entrepôt utilisé par les outils et gardez un query_timeout strict.
Observabilité complète des requêtes. Chaque appel d'outil est tracé avec l'identité de l'appelant, le nom de l'outil, les entrées et la latence, puis exporté via OpenTelemetry vers Grafana, Datadog ou Prometheus. Comme l'authentification sortante est basée sur OAuth par utilisateur, l'identité de l'appelant correspond à celle de l'utilisateur dans l'historique des requêtes de Snowflake, ce qui permet d'identifier sans ambiguïté l'auteur de chaque action.
Garde-fous. Les garde-fous appliqués avant et après l'utilisation des outils exécutent des politiques sur les appels, ce qui consiste ici à inspecter les ensembles de résultats à la recherche de modèles de données personnelles (PII) avant qu'ils n'atteignent le modèle.
Faible surcharge. La passerelle ajoute environ 3-4 ms de latence et gère plus de 350 requêtes par seconde sur un seul vCPU. Pour une requête mesurée en secondes, c'est négligeable.
Un registre unique. Une fois plusieurs serveurs enregistrés, vous pouvez regrouper un sous-ensemble d'outils sélectionnés derrière un point de terminaison unique avec un serveur MCP virtuel, permettant ainsi à un agent de reporting d'accéder à un outil d'analyse Snowflake et à un outil de publication Slack.
Les administrateurs de locataires peuvent supprimer toutes les informations d'identification stockées sur le serveur en une seule action, depuis le menu à trois points situé à côté de Modifier:
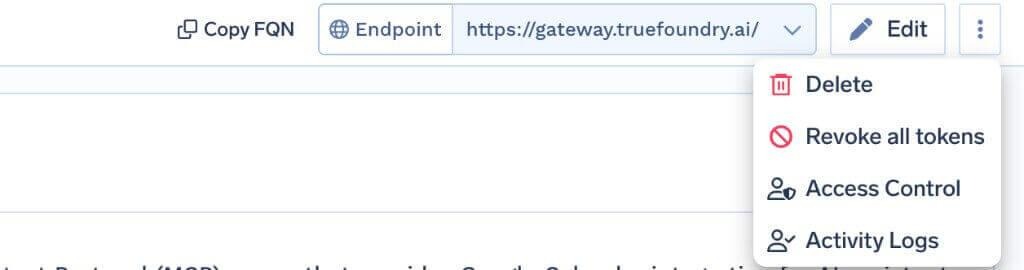
Révoquer tous les jetons supprime tous les remplacements d'authentification et les jetons OAuth stockés pour tous les utilisateurs et comptes virtuels sur ce serveur, prend effet à la prochaine requête et est consigné dans les journaux d'activité. Cette action est irréversible et n'est visible que par les administrateurs du tenant.
La limite est importante : cela efface les jetons uniquement au niveau de la passerelle, et non l'autorisation dans Snowflake. En cas d'incident réel, désactivez également l'intégration de sécurité et renouvelez le secret client.
Les comptes d'essai ne peuvent pas exécuter de SQL. L'outil d'exécution SQL est bloqué sur les comptes d'essai. Si votre preuve de concept utilise un compte d'essai et que l'outil apparaît mais ne s'exécute jamais, c'est la raison.
L'accès au serveur n'est pas l'accès à l'outil. GRANT USAGE ON MCP SERVER permet à un rôle de se connecter et de découvrir des outils. Leur exécution nécessite les autorisations sous-jacentes : USAGE sur le service Cortex Search, SELECT sur la vue sémantique, et les privilèges de table pour le SQL.
Vues sémantiques, pas modèles sémantiques. CORTEX_ANALYST_MESSAGE accepte un identifiant de vue sémantique. Pointer vers un modèle sémantique ne fonctionnera pas, et l'erreur n'est pas explicite.
Le serveur MCP Snowflake est l'outil le plus puissant que vous puissiez confier à un agent, mais c'est aussi celui dont les erreurs peuvent coûter le plus cher. La plupart des serveurs d'un registre risquent une écriture malencontreuse. Celui-ci expose à une facture salée et à une lecture étendue de données déjà consolidées pour plus de facilité.
Vous ne partez pas de zéro face à ce second risque. Le contrôle d'accès basé sur les rôles (RBAC), les politiques d'accès aux lignes et les politiques de masquage de Snowflake constituent votre premier rempart. L'authentification OAuth par utilisateur permet à l'agent d'hériter de ces restrictions au lieu de les contourner via un compte de service partagé. Le rôle de la passerelle est de compléter ce dispositif : elle détermine quels outils sont disponibles, réserve les plus sensibles à une intervention humaine et vous fournit un journal d'appels ainsi qu'un suivi des métriques pour que les coûts ne soient plus une surprise.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Un point de terminaison Model Context Protocol géré par Snowflake et hébergé dans votre propre compte. Vous le créez avec CREATE MCP SERVER et une spécification YAML qui énumère les outils qu'il expose. Les agents y accèdent via une URL propre au compte et s'authentifient avec Snowflake OAuth.
Ceux que vous déclarez, jusqu'à 50 par serveur, répartis en cinq types : SYSTEM_EXECUTE_SQL, CORTEX_ANALYST_MESSAGE, CORTEX_SEARCH_SERVICE_QUERY, CORTEX_AGENT_RUN et GENERIC pour les UDF. Sur TrueFoundry, la liste résolue apparaît dans l'onglet Tools après l'OAuth, où chaque outil peut être activé, désactivé, redécrit ou annoté.
Procédez par couches. Préférez les outils Cortex Analyst sélectionnés au SQL brut et désactivez SYSTEM_EXECUTE_SQL lorsque c'est possible. Sinon, définissez un query_timeout serré, placez un resource monitor sur le warehouse, soumettez l'outil SQL à une politique d'approbation pour qu'une personne lise d'abord la requête, et surveillez dans le tableau de bord des métriques la signature caractéristique des boucles de nouvelles tentatives.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















