



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 10, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Partie 1 a nommé le problème : le tokenmaxxing, la nouvelle métrique des lignes de code, où les ingénieurs optimisent le volume d'utilisation de l'IA parce que c'est le chiffre mesuré. Partie 2 a prescrit le remède architectural : l'identité, la politique, la sécurité et l'observabilité attachées à chaque requête au niveau de la passerelle. Cette dernière partie transforme cette architecture en quelque chose qu'une organisation peut réellement opérer semaine après semaine.
La décision de conception la plus importante à ce niveau est aussi la plus facilement négligée. Le tableau de bord que vous construirez influencera les comportements. Un tableau de classement crée une pression sociale pour consommer des jetons. Une salle de contrôle aide les responsables des plateformes, de la sécurité, des finances et de l'ingénierie à répondre à des questions plus complexes et à agir en fonction des réponses.
Les questions qui comptent vraiment : Quels flux de travail créent de la valeur par dollar ? Quels agents tournent en boucle ? Quelles équipes sous-utilisent l'IA là où elle serait réellement utile ? Quelle utilisation des modèles premium est justifiée, et laquelle est décorative ? Quels événements de garde-fou sont du bruit et lesquels signalent un risque réel ?
Si les panneaux sont bien conçus, ces questions deviennent des questions opérationnelles de routine auxquelles on répond lors du stand-up du lundi. Si vous les concevez mal, votre tableau de bord le plus précis formera discrètement le même comportement manipulable que vous cherchiez à prévenir.
Avant les panneaux, les règles de conception. Chaque principe est la réponse directe à un mode de défaillance introduit par les tableaux de classement.
Le panneau d'adoption répond à une question d'une simplicité trompeuse : combien d'ingénieurs utilisent réellement les outils d'IA un jour donné ?
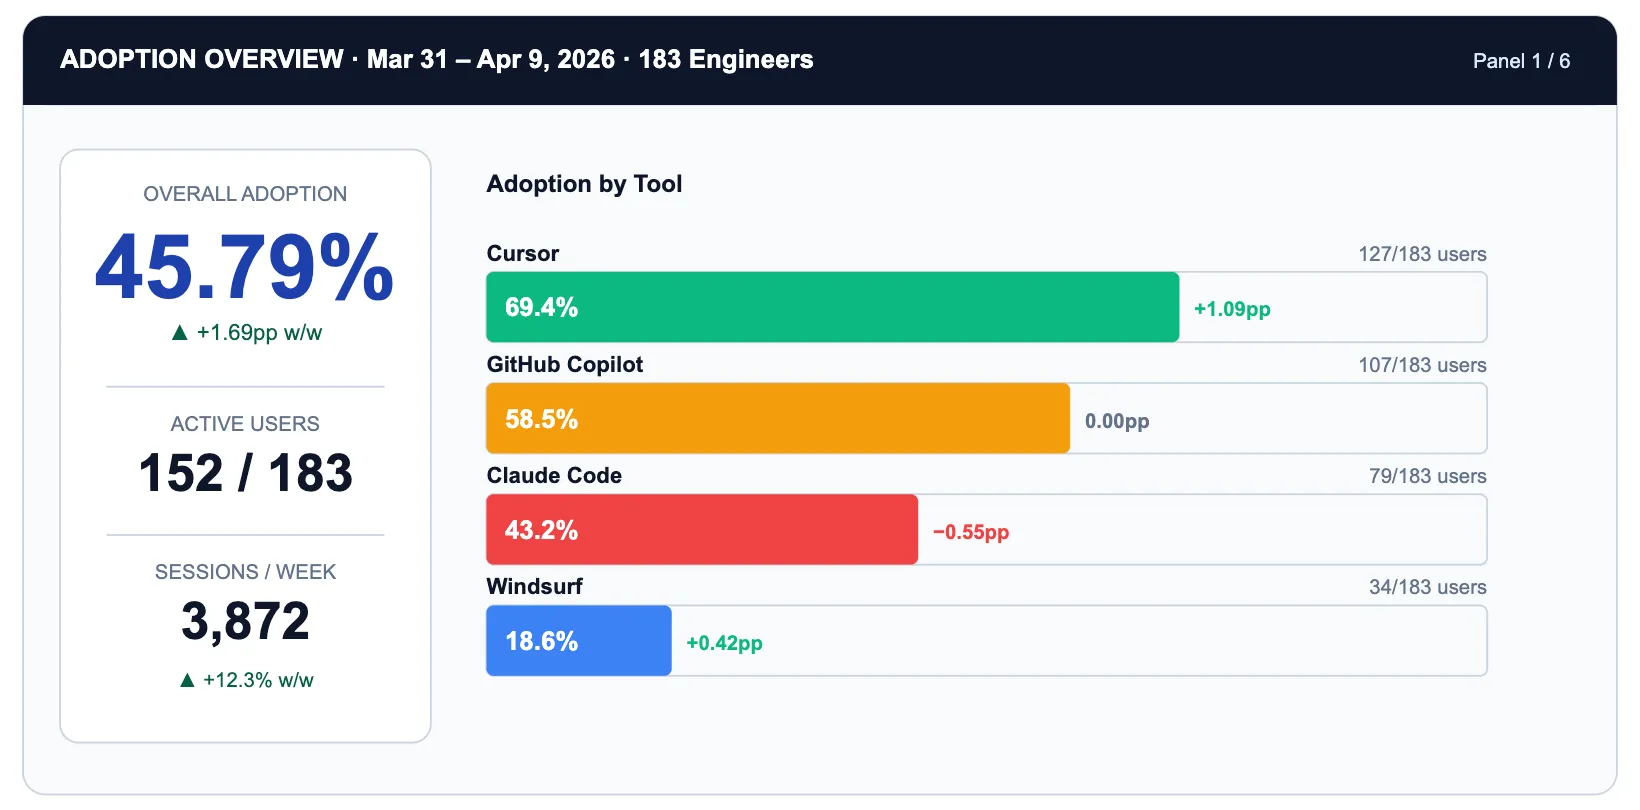
Remarquez ce que le panneau ne montre pas : les classements individuels. L'unité est fournisseur x équipe x jour. L'action qu'il produit n'est pas « féliciter Alex » mais « L'adoption de Claude Code est inférieure de 26 points de pourcentage à celle de Cursor. S'agit-il d'un problème de friction lié aux outils ou d'un problème d'adéquation au cas d'utilisation ? » C'est une question qui mérite un sprint.
TrueFoundry rend cela possible via l'en-tête X-TFY-METADATA attaché à chaque requête de passerelle. L'en-tête contient un objet JSON sérialisé dont les champs incluent l'identité de l'utilisateur, l'appartenance à l'équipe, le nom de l'outil, l'étiquette du projet et l'ID de session.
→ Référence des en-têtes de requête et de réponse TrueFoundry
→ Aperçu du tableau de bord analytique
L'adoption vous indique qui utilise l'IA. Le taux de consommation vous indique où va l'argent. Ce sont des questions différentes et elles appartiennent à des panneaux différents.
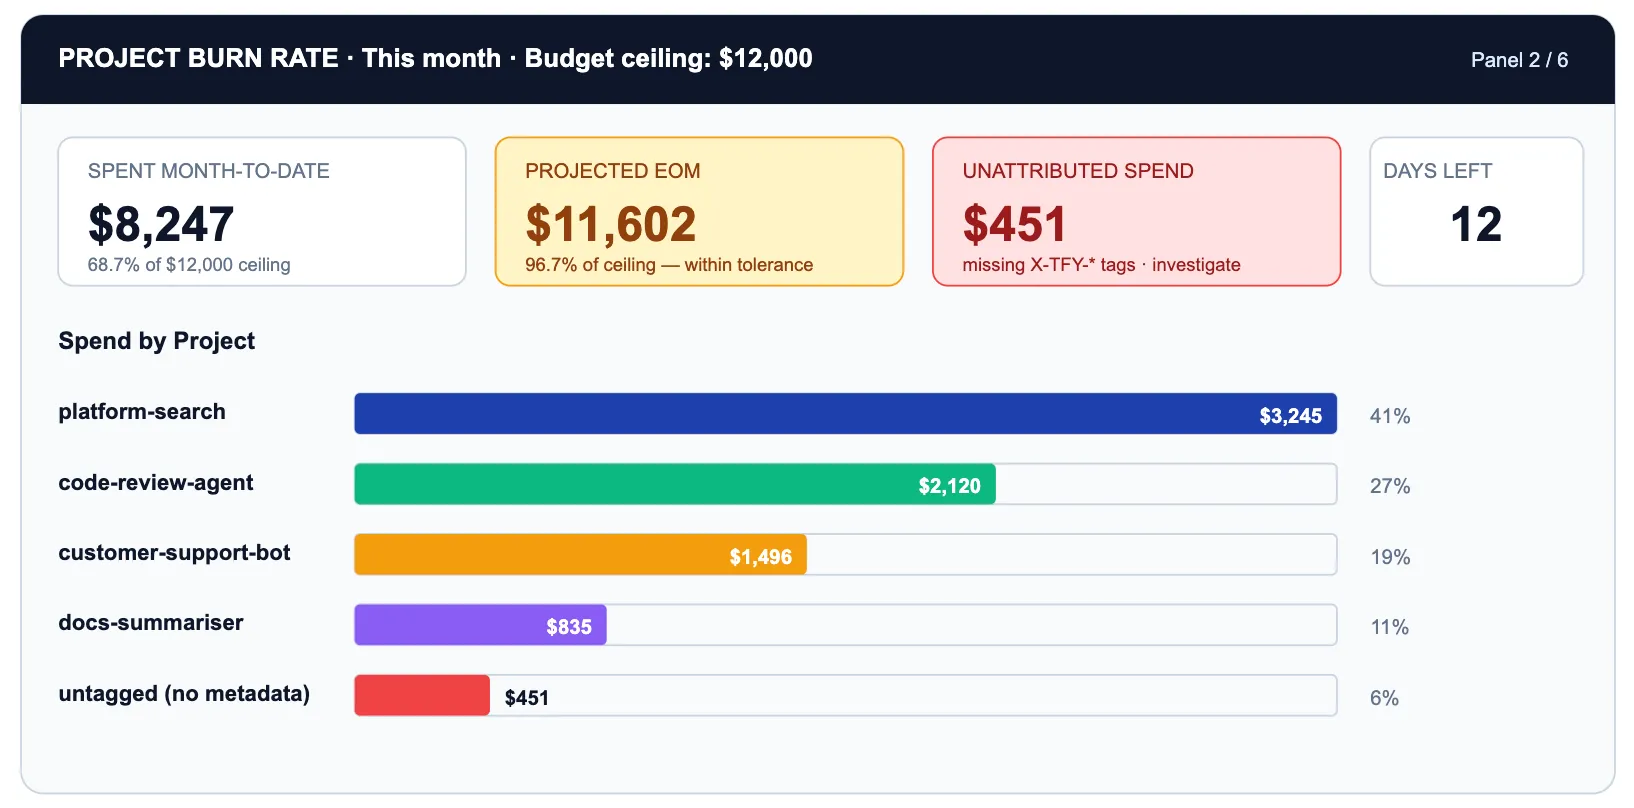
La ligne critique est NON ÉTIQUETÉE. 451 $ de dépenses n'ont pas de métadonnées de projet. C'est un problème de configuration de passerelle, pas un problème de dépenses. Chaque requête non étiquetée ne peut pas être attribuée à un résultat commercial, régie par une politique budgétaire, ou apparaître dans un graphique de taux de consommation utile.
La limitation budgétaire de TrueFoundry vous permet de définir des plafonds stricts par projet, par équipe, par famille de modèles ou par fenêtre temporelle. Lorsque la recherche de plateforme atteint 100 % de son plafond mensuel de 4 000 $, les requêtes commencent à renvoyer des 429 ou reviennent à un modèle moins cher basé sur votre politique configurée.
→ Limitation budgétaire — fenêtres, plafonds et alertes
→ Limitation de débit — par utilisateur, par modèle, par étiquette de métadonnées
Le nouveau mode de défaillance le plus coûteux dans un monde agentique est la boucle : un agent qui réessaie indéfiniment parce que sa condition de sortie n'est jamais remplie, ou parce que l'outil qu'il appelle continue de renvoyer des erreurs. Un seul agent en boucle peut consommer autant de jetons en une heure qu'une équipe d'ingénieurs en une journée.
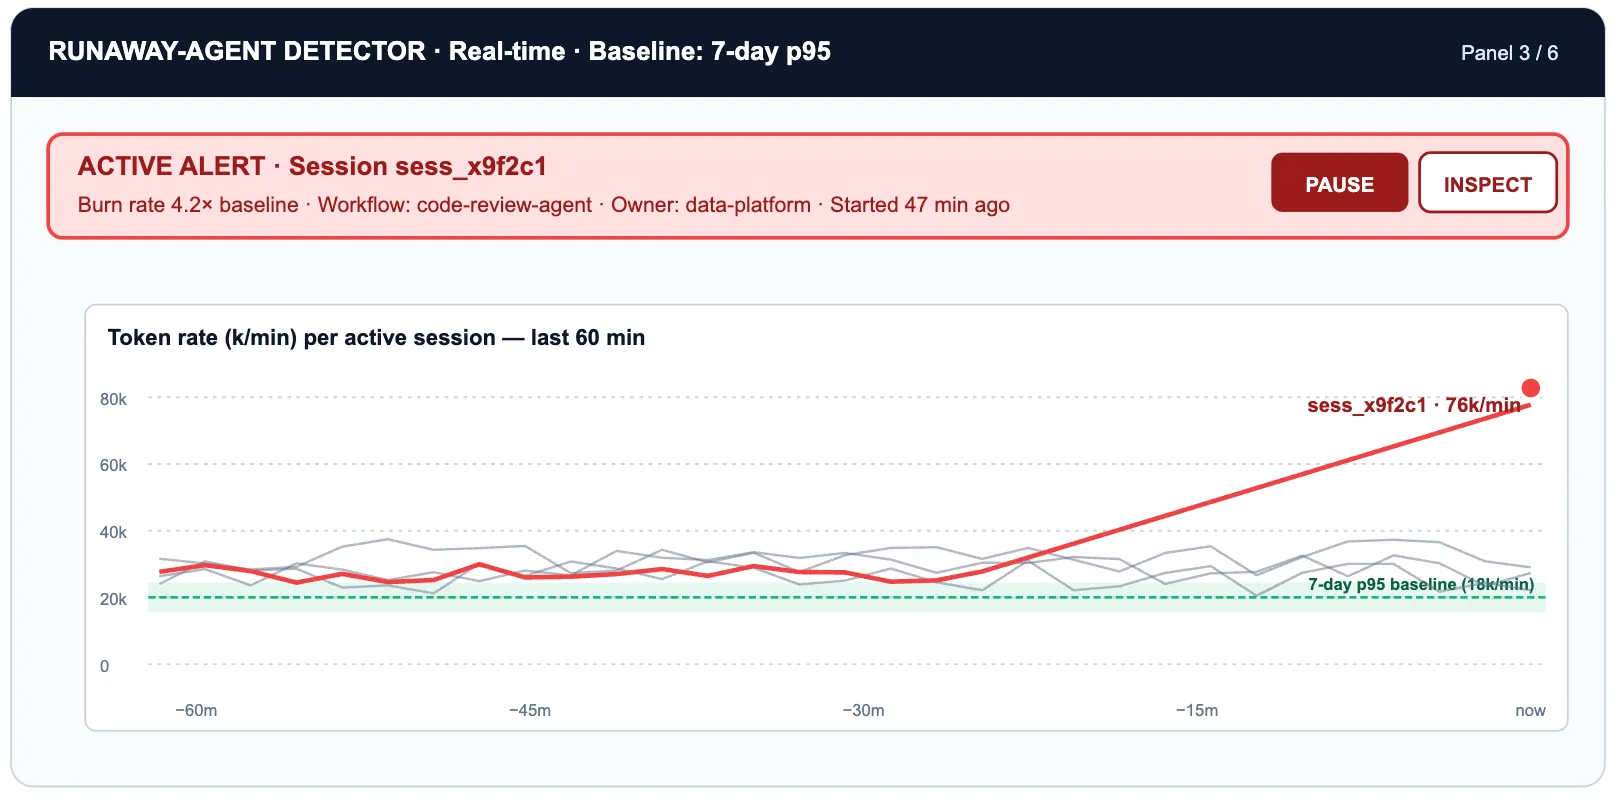
Ce panneau nécessite le signal OTEL que TrueFoundry exporte : le taux de jetons par session au fil du temps, et non seulement le nombre de requêtes. La base de référence p95 est calculée à partir des sept jours précédents de sessions pour chaque étiquette de flux de travail. Tout ce qui dépasse 3x cette base de référence déclenche un événement de téléavertisseur et, éventuellement, l'arrêt d'une session via le chemin d'application de la limite de débit.
→ Exportation des données OpenTelemetry — traces, spans, compteurs de jetons
→ Limitation de débit — application de plafonds par session
Toutes les tâches qui atteignent un modèle de pointe ne méritent pas un modèle de pointe. Acheminer une tâche de classification d'e-mail vers Claude Opus 4.7 à 5 $/25 $ par million de jetons alors que Haiku 4.5 à 1 $/5 $ la gérerait avec une précision à 2 points de pourcentage près, revient à payer 5 fois plus cher pour une capacité que vous n'utilisez pas. Ce choix est invisible tant qu'il n'est pas agrégé sur des milliers de requêtes quotidiennes — ce que ce panneau fait précisément.
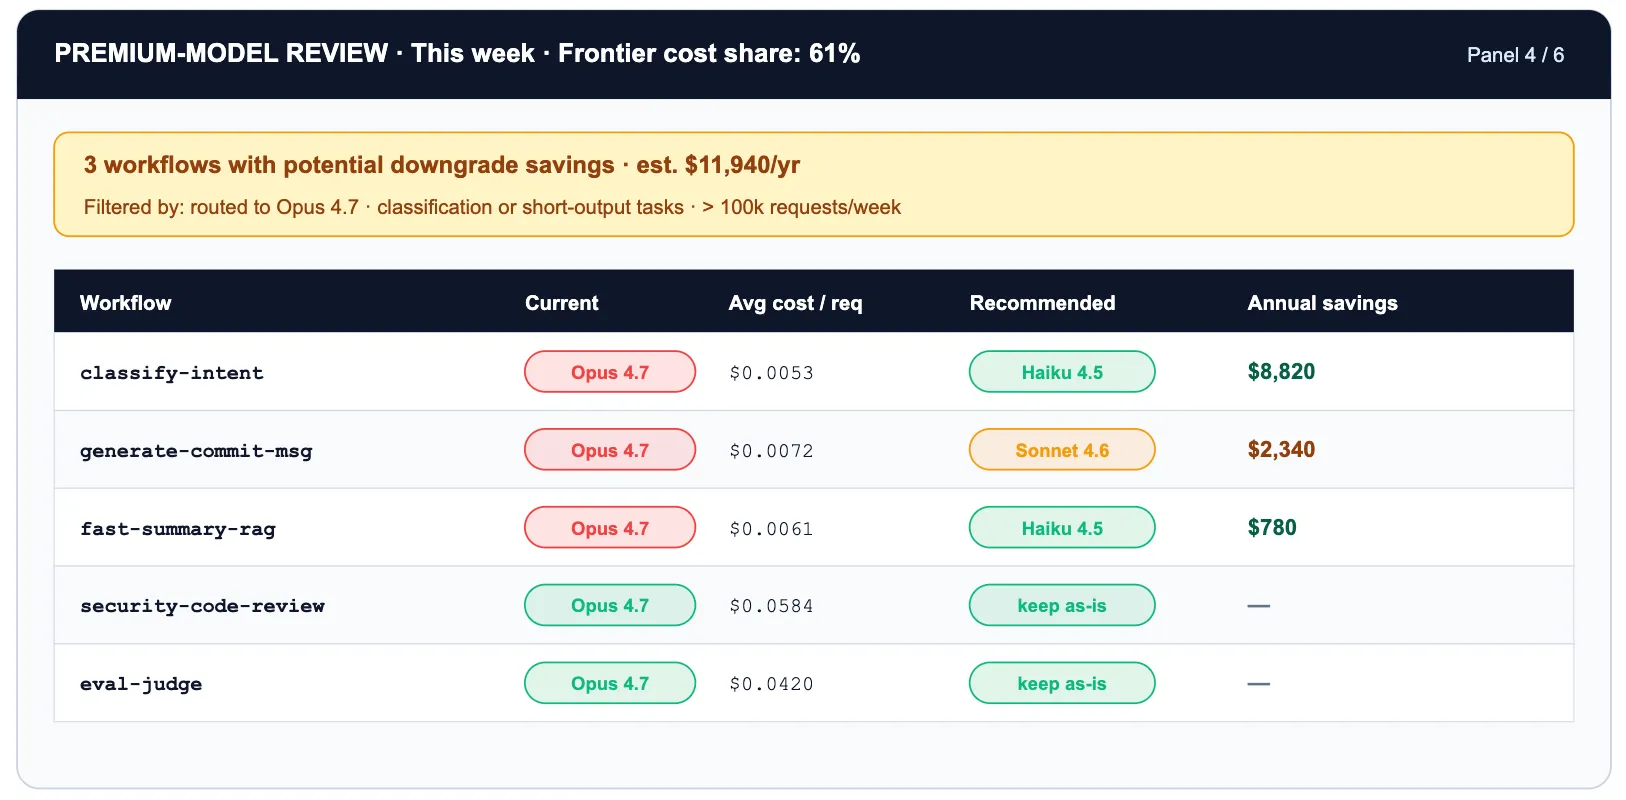
Deux optimisations superposées s'appuient sur ce panneau. L'acheminement de la classification d'intention d'Opus 4.7 vers Haiku 4.5 représente une réduction de 5x du coût des jetons. De plus, l'activation de la mise en cache des invites sur l'invite système réduit les jetons d'entrée mis en cache de 90 % supplémentaires — une réduction cumulée qui transforme un flux de travail de 3 200 $/mois en environ 50 $/mois sans changement de précision.
Il existe également une version cachée de ce panneau : la dérive du tokenizer. Lorsqu'Anthropic a lancé Opus 4.7, le nouveau tokenizer produit jusqu'à 35 % de jetons en plus pour la même entrée par rapport à Opus 4.6. La grille tarifaire principale n'a pas changé. Le coût effectif par requête, lui, a changé. La seule façon de le constater est la télémétrie des jetons par version de modèle sur la passerelle. La seule façon de réagir est de revenir à l'alias de modèle virtuel — ce qui, sur TrueFoundry, est une différence YAML, pas un sprint.
Le routage de modèles virtuels de TrueFoundry rend l'action sur ce panneau sans friction. Vous configurez un nom de modèle logique comme 'code-review-fast' qui achemine vers différents points de terminaison physiques par étiquette de flux de travail, heure de la journée ou charge — sans toucher au code de l'application. Tester un modèle moins cher par A/B testing est une différence YAML, pas un sprint.
→ Aperçu du routage — poids, priorité, repli, mise en cache des invites
Le rôle du panneau de sécurité est le triage. La plupart des événements de garde-fou sont du bruit : trafic de test, expérimentation par les développeurs, cas limites attendus en production. Une poignée représente un risque réel : fuite de PII via une invite, apparition d'un secret dans le code généré par l'agent, tentative d'injection d'invite dans une entrée fournie par l'utilisateur.
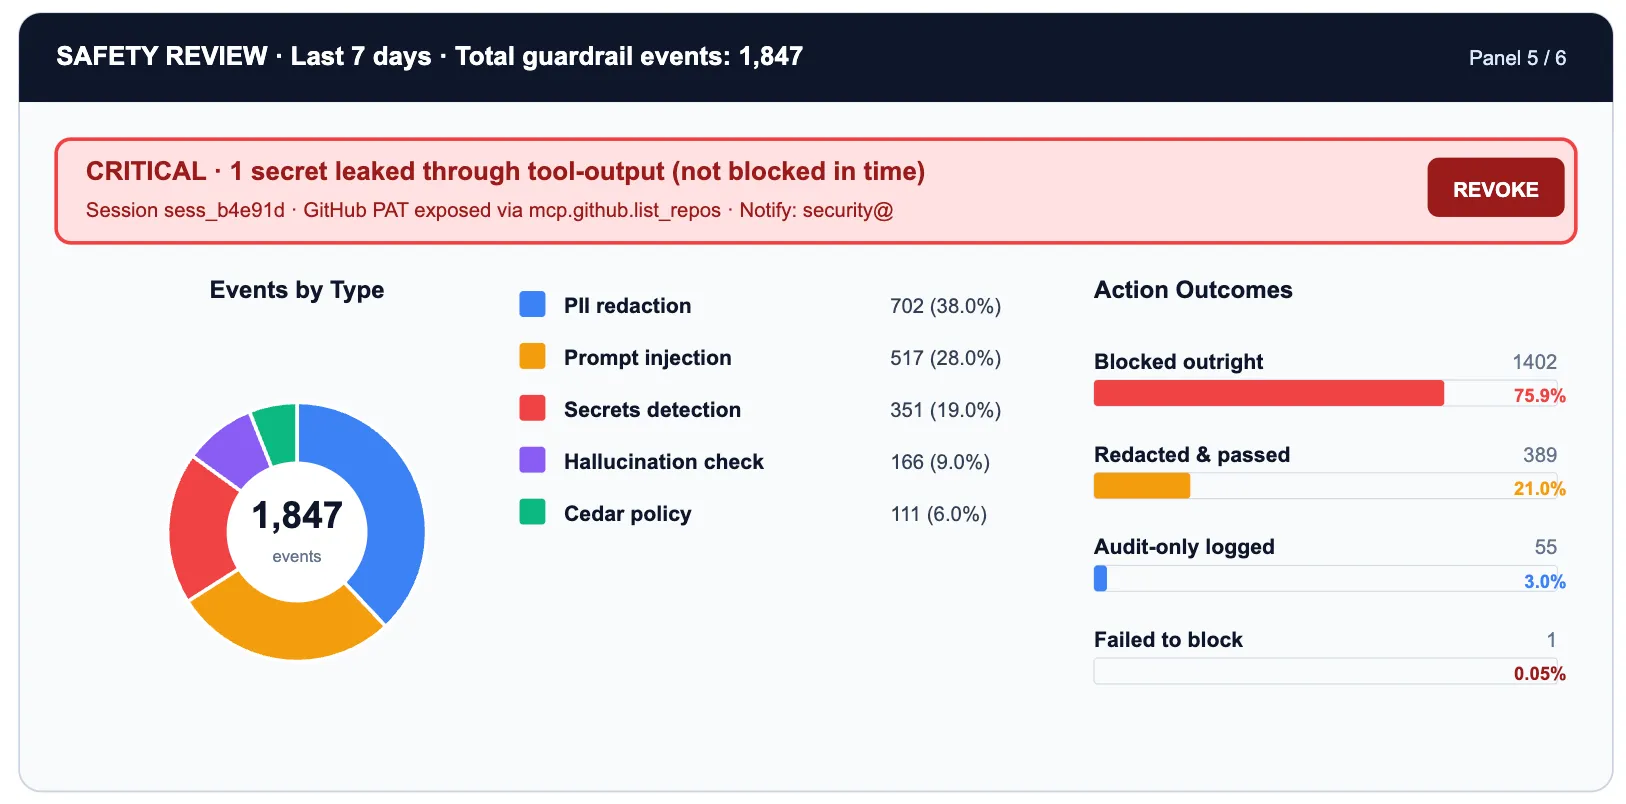
Le secret divulgué dans la ligne d'analyse des secrets est la cellule qui justifie une action immédiate. Tout le reste est informatif : utile pour ajuster la sensibilité des garde-fous, distinguer le signal du bruit et démontrer la conformité aux auditeurs.
Le modèle de garde-fou à quatre points d'accroche de TrueFoundry (entrée de requête, sortie de requête, entrée d'outil, sortie d'outil) signifie que chaque ligne d'événement correspond à un point d'interception spécifique dans le cycle de vie de la requête. La détection de PII à l'entrée de la requête intercepte les données utilisateur avant qu'elles n'atteignent le modèle. L'analyse des secrets à la sortie de l'outil intercepte les identifiants avant qu'ils n'atteignent les systèmes en aval.
→ Aperçu des garde-fous — quatre points d'accroche, décomposition de la surface d'attaque
→ Détection de PII/PHI — modes de masquage et emplacement des points d'accroche
→ Détection des secrets — mode validation vs mutation
C'est le panneau le plus difficile à construire et le plus important à avoir. Les cinq panneaux précédents décrivent l'utilisation de l'IA. Celui-ci répond à la question de savoir si cette utilisation a produit quelque chose.
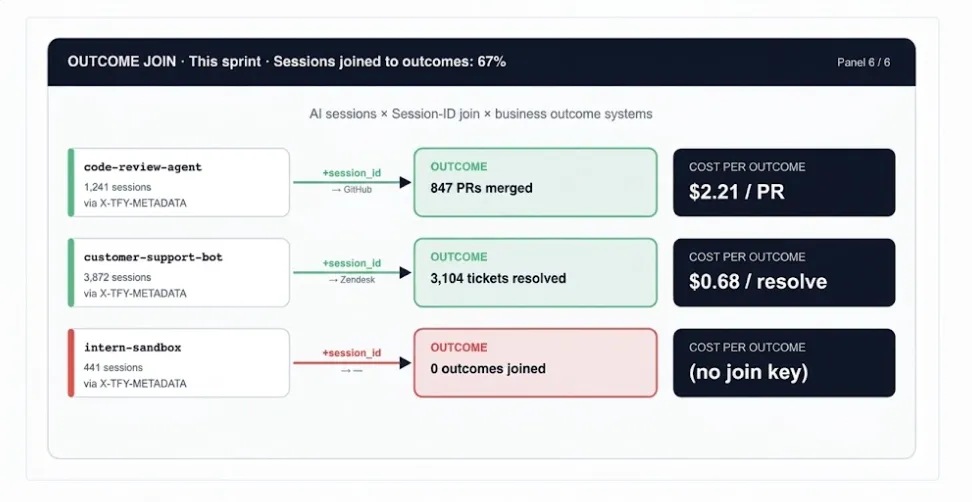
La clé de rapprochement est le champ session_id dans X-TFY-METADATA, propagée par TrueFoundry à travers chaque requête dans une session d'agent multi-tours. Lorsque le même ID de session apparaît dans la charge utile de votre webhook GitHub ou dans les métadonnées Zendesk, vous pouvez boucler la boucle : cette session a coûté 2,21 $ et a produit une PR de révision de code fusionnée.
→ Analyse — vues des coûts et de l'utilisation au niveau de la session
Les six panneaux s'appuient sur trois couches de métriques distinctes. L'erreur la plus courante dans les tableaux de bord est de les mélanger : une vue exécutive ne devrait pas afficher le nombre de tentatives, et une vue d'astreinte ne devrait pas afficher les taux de réussite des évaluations.
Une fois les trois couches en place, la tentation est de les regrouper en un score par ingénieur et d'afficher un classement. Résistez à cette tentation. La fonction ci-dessous est explicitement diagnostique : un outil pour identifier les schémas de flux de travail qui méritent un investissement, une refonte ou de nouvelles balises de sécurité. Agréger par workflow_tag, et non par user_id.
# ai_leverage_score.py
# Per SESSION, not per engineer. Aggregate by workflow_tag.

def ai_leverage_score(session: dict) -> float:
    # OUTCOME SIGNALS (weighted heaviest)
    outcome_score = (
        session.get('incidents_resolved', 0) * 25 +
        session.get('prs_merged', 0)          * 15 +
        session.get('tickets_closed', 0)      * 10 +
        session.get('eval_pass_rate', 0)      * 20   # float 0.0-1.0
    )

    # GOVERNANCE HITS (small penalty: information, not moral failing)
    governance_penalty = (
        session.get('budget_limit_hits', 0) * 2 +
        session.get('rate_limit_hits', 0)   * 1 +
        session.get('guardrail_blocks', 0)  * 3
    )

    # WASTE SIGNALS (penalise shape, not raw volume)
    retry_tokens  = session.get('retry_token_count', 0)
    context_waste = session.get('unused_context_ratio', 0.0)
    loop_flag     = 1 if session.get('tokens_per_hr', 0) > 3 * session.get('p95_baseline', 1) else 0
    waste_penalty = (retry_tokens / 10000) + (context_waste * 10) + (loop_flag * 15)

    # COST DAMPENER (sub-linear: expensive sessions aren't punished)
    cost_usd     = session.get('total_cost_usd', 0.01)
    cost_dampener = cost_usd ** 0.4

    raw = (outcome_score - governance_penalty - waste_penalty) / max(cost_dampener, 0.01)
    return max(0.0, min(100.0, raw))

# Weekly report: top-10 workflow PATTERNS, not top-10 humans
# df.groupby('workflow_tag')['score'].mean().nlargest(10)Les tableaux de bord ne gèrent pas les organisations. Les rituels, oui. La cadence opérationnelle minimale viable pour une utilisation encadrée de l'IA :
Chaque alerte doit correspondre à une étape de runbook, et non pas seulement à un événement de téléavertisseur. Le fichier YAML ci-dessous définit l'ensemble de règles d'alerte minimal viable pour la salle de contrôle, s'exécutant sur l'export OTEL de TrueFoundry :
# tfy-ai-alerts.yaml   |   tfy apply -f tfy-ai-alerts.yaml

alerts:
  - name: runaway_agent
    query: rate(tfy_gateway_tokens_total[5m]) > 3 * quantile(0.95, rate(tfy_gateway_tokens_total[7d]))
    labels: {severity: critical, team: platform}
    runbook: |
      1. Identify session_id from alert labels
      2. Check the workflow_tag field in the request's X-TFY-METADATA for owning team
      3. Confirmed loop: PUT /gateway/sessions/{id}/kill
      4. File incident linked to TFY session trace

  - name: budget_near_ceiling
    query: tfy_budget_used_pct{scope='project'} > 90
    labels: {severity: warning, team: finance-ops}
    runbook: |
      1. Notify project owner (#ai-budget-alerts)
      2. Review premium-model panel for quick routing wins
      3. Raise ceiling or enable fallback-to-cheaper-model policy

  - name: secret_leaked
    query: increase(tfy_guardrail_events_total{type='secret',action='allowed'}[1h]) > 0
    labels: {severity: critical, team: security}
    runbook: |
      1. Pull trace from TFY Analytics for the request
      2. Identify secret type and downstream model/tool
      3. Rotate credential immediately
      4. Switch secrets guardrail from validate to mutate mode

  - name: untagged_spend_spike
    query: sum(tfy_cost_usd_total{project='UNTAGGED'}) > 50
    labels: {severity: warning, team: platform}
    runbook: |
      1. Find callers via the user_id metadata field in Analytics
      2. Require a project field in X-TFY-METADATA via gateway config
      3. Block untagged traffic after 30-day grace period
Vérifier le champ workflow_tag dans le X-TFY-METADATA de la requête pour l'équipe propriétaire
Vérifier le champ workflow_tag dans le X-TFY-METADATA de la requête pour l'équipe propriétaire
→ tfy apply — Déploiement d'alertes et de politiques de style GitOps
→ Exporter les données OpenTelemetry — Points de terminaison de métriques OTEL
Avant de déclarer votre salle de contrôle IA opérationnelle, vérifiez ces huit conditions. Chacune correspond à une capacité spécifique de TrueFoundry :
La trilogie Tokenmaxxing a élaboré un argumentaire en trois couches. Chaque couche est nécessaire ; aucune n'est suffisante à elle seule.
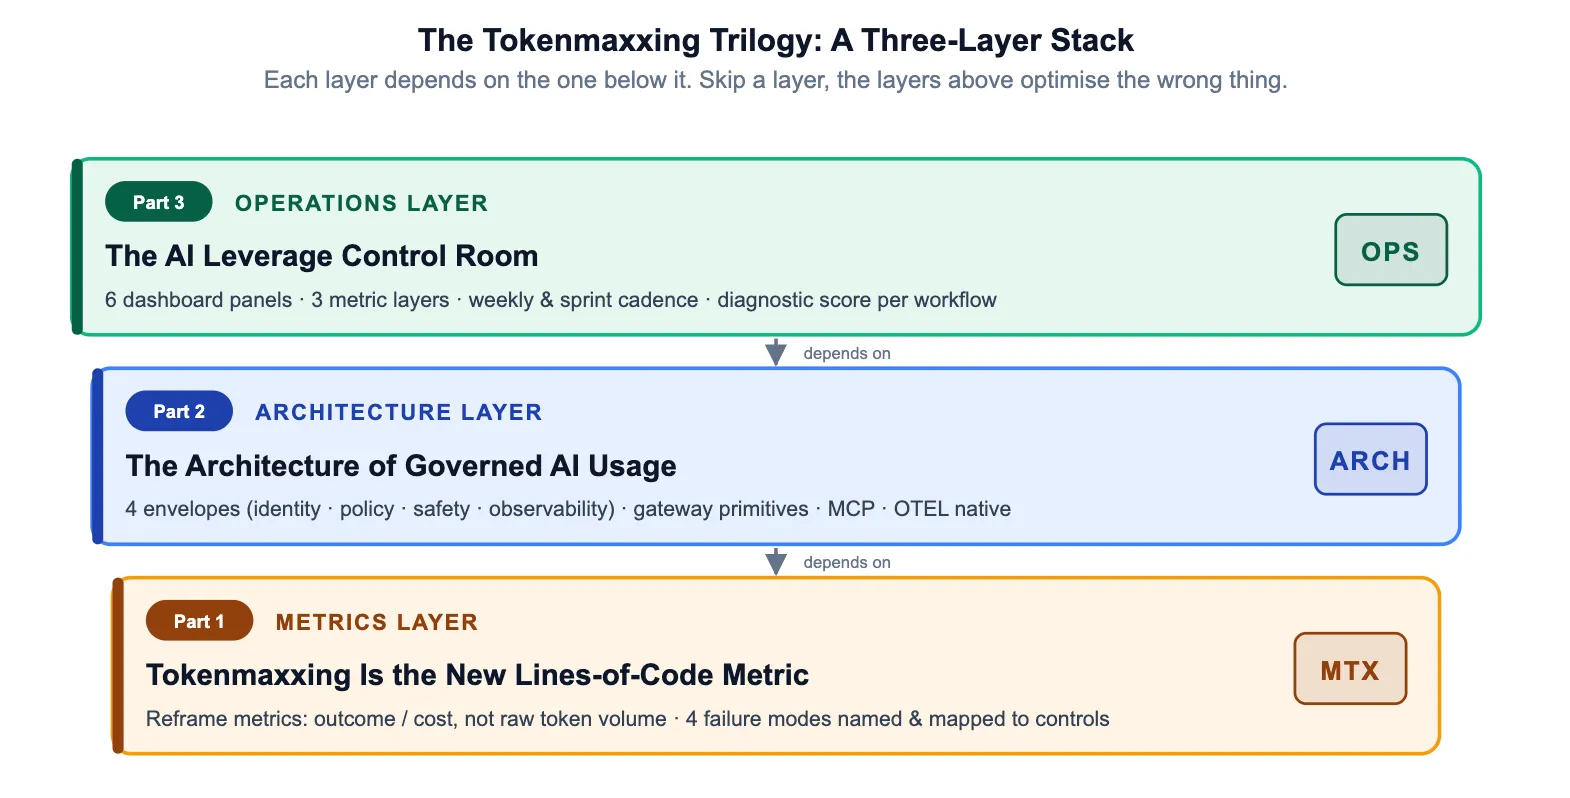
Les organisations qui s'arrêtent à la Couche 1 ont un discours mais pas d'application. Celles qui s'arrêtent à la Couche 2 ont une application mais pas de boucle de rétroaction. La salle de contrôle boucle la boucle — faisant de l'utilisation encadrée de l'IA non pas une simple posture de conformité, mais une discipline opérationnelle qui se renforce avec le temps.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















