



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La réponse finale d'un agent vous indique ce que l'utilisateur a vu. Ses événements indiquent à votre application ce qui s'est passé, ce qui est en cours, ce qui nécessite une intervention humaine et comment récupérer en cas de coupure de connexion.
Un appel de modèle conventionnel a une forme rassurante : envoyer une entrée, recevoir une sortie. Même lorsque la réponse est diffusée en flux, l'application reconstruit généralement une seule réponse. L'exécution d'un agent est différente. Une exécution peut effectuer plusieurs appels de modèle, demander des outils, attendre une approbation, s'authentifier auprès d'un serveur MCP, créer un bac à sable, déléguer à des sous-agents et reprendre lors d'une requête ultérieure.
Si l'environnement d'exécution n'expose que la dernière réponse textuelle, l'application perd la structure nécessaire pour piloter ce flux de travail. Elle ne peut pas répondre de manière fiable à des questions fondamentales :
C'est pourquoi les événements sont essentiels. Ils constituent l'interface entre l'exécution invisible et tout ce qui doit y répondre : l'interface utilisateur, le service d'approbation, la console d'opérations, le débogueur et l'évaluateur.
TrueForge organise l'exécution sous la forme Agent → Session → Tour → Événement → Delta. Chaque niveau répond à une question différente :
L'agent est une définition, pas un processus fonctionnant en continu. Une session conserve le contexte entre les tours. Un tour représente un cycle de requête, et un seul tour s'exécute à la fois au sein d'une session. Les événements sont les enregistrements typés produits au cours de ce tour. Certains événements — plus visiblement les messages du modèle — peuvent être assemblés progressivement via des deltas.
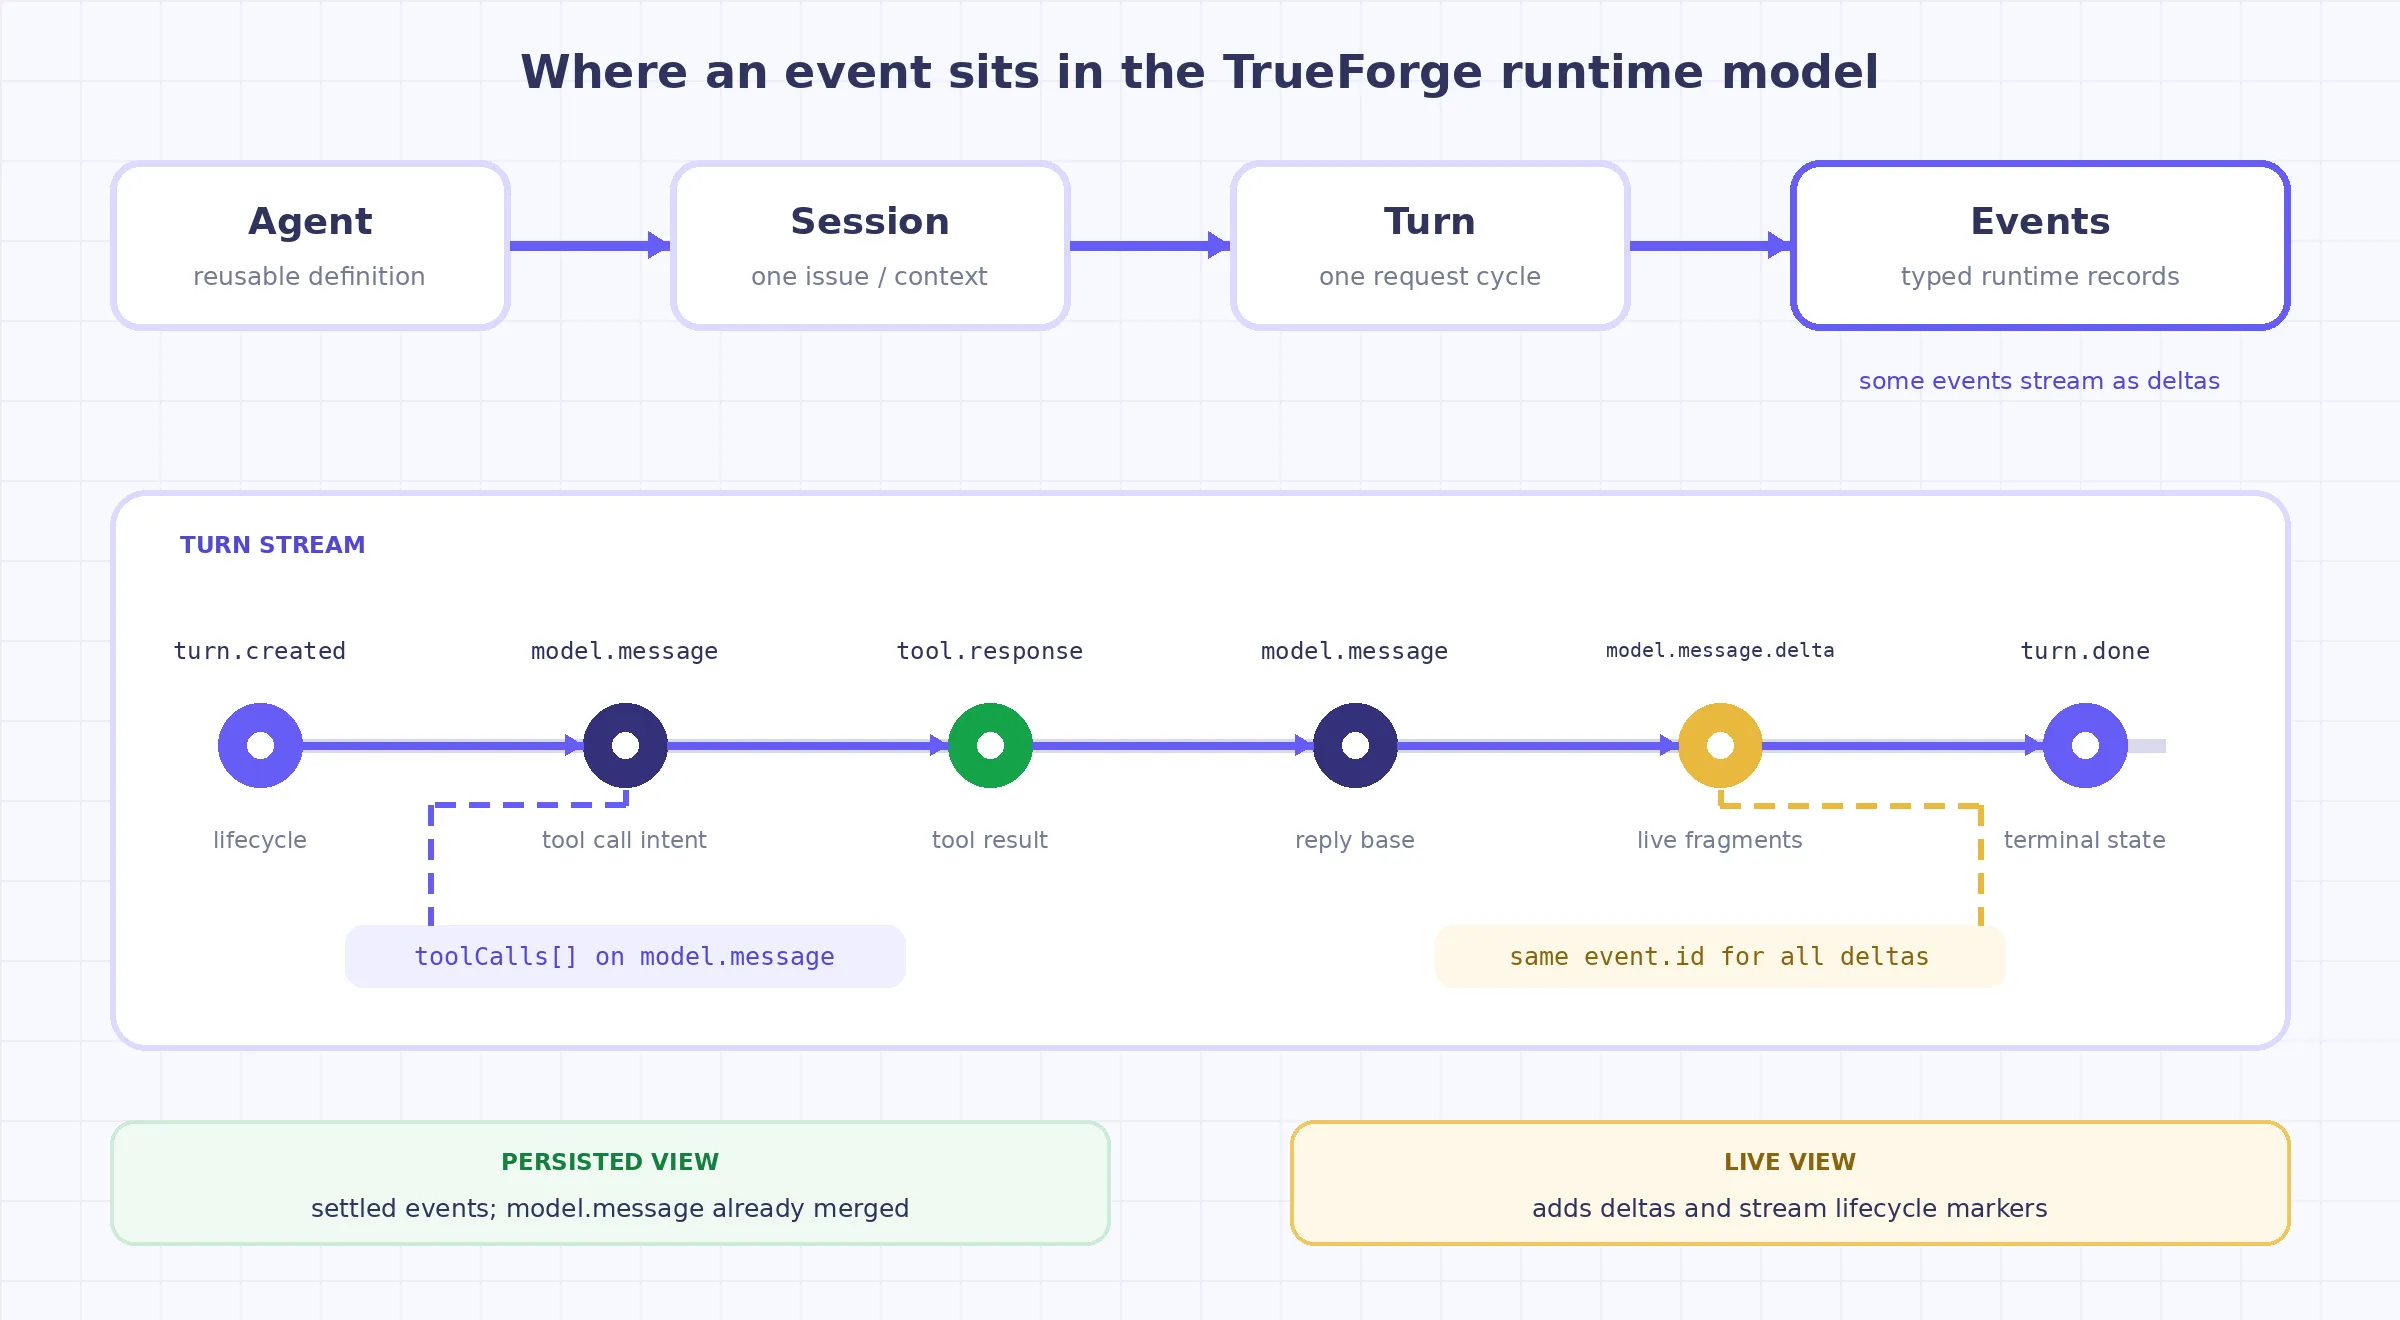
Cette hiérarchie permet d'éviter deux erreurs de conception courantes. Premièrement, l'historique d'une session ne doit pas être traité comme une transcription illimitée : les tours de parole offrent des limites d'exécution naturelles. Deuxièmement, un delta diffusé en continu ne doit pas être stocké ou évalué comme s'il s'agissait de l'événement sémantique final.
L'union d'événements documentée de TrueForge couvre plusieurs catégories. L'essentiel n'est pas le nombre de types d'événements, mais le fait que chaque catégorie implique un comportement applicatif différent.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















