



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 8, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une transition architecturale silencieuse est déjà en cours.
Les entreprises ont commencé par connecter leurs applications à OpenAI, Anthropic, Gemini, ainsi qu'à des modèles open source et internes. Elles ont ajouté des passerelles pour gérer les clés API, les limites de débit, le routage des fournisseurs et le suivi de l'utilisation. Puis, les agents sont arrivés.
Soudain, la pile a également eu besoin de serveurs MCP, de communication A2A, d'autorisation d'outils, de mémoire, de gestion de contexte, d'approbations humaines, de routage d'inférence, de tentatives de répétition, d'évaluation et d'application de politiques. Chaque besoin a engendré un nouveau produit, proxy, bibliothèque ou équipe.
Le résultat est familier : plusieurs bons outils, plusieurs points de contrôle, mais aucun endroit central capable de comprendre l'ensemble du processus.
Un agent peut appeler trois modèles, invoquer cinq outils, déléguer à un sous-agent, faire une pause pour approbation, reprendre à partir de la mémoire et mettre à jour un système de production. Le coût, le risque, la latence et la valeur commerciale évoluent à chaque étape.
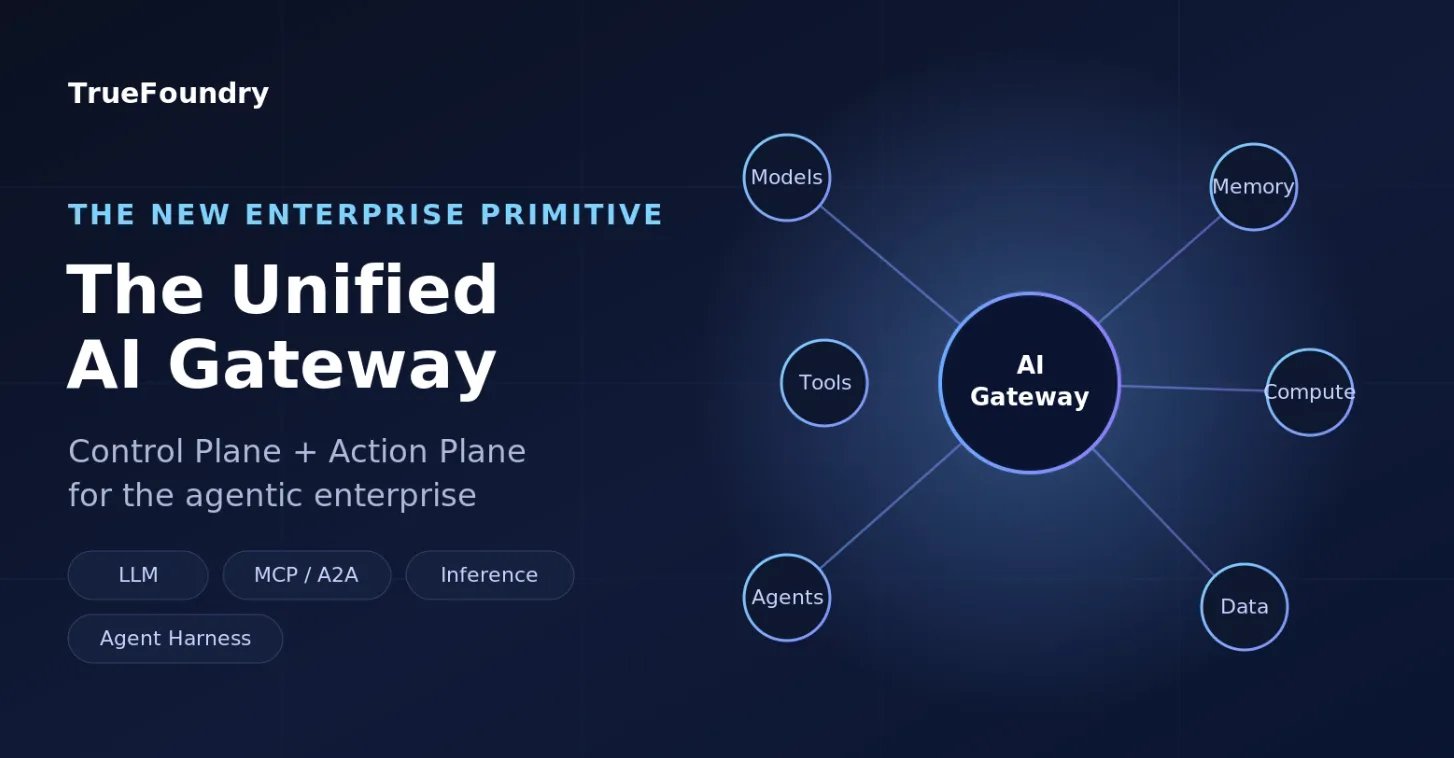
C'est pourquoi la passerelle évolue vers un plan de contrôle et un plan d'action couvrant les modèles, les outils, les agents, les données et le calcul.
Je considère la passerelle IA comme une primitive fondamentale pour les entreprises, tant du point de vue de l'optimisation des jetons que de celui de la valeur.
L'optimisation des jetons consiste à extraire davantage de travail utile de chaque jeton, appel de modèle, cycle GPU et unité de dépense.
L'optimisation de la valeur consiste à faire correspondre chaque tâche au modèle, à l'outil, au flux de travail et à l'ensemble de contrôles qui produisent le meilleur résultat commercial.
Une tâche de classification de documents peut parfaitement s'exécuter sur un petit modèle interne. Une analyse de crédit complexe peut nécessiter un modèle de pointe. Un agent de service client peut utiliser un modèle rapide pour la recherche, un modèle plus puissant pour le raisonnement et un outil déterministe pour la transaction finale. Un flux de travail réglementé peut exiger un modèle souverain, un point de terminaison privé et un point de contrôle humain.
La passerelle devient le lieu où ces choix s'opèrent.
Ma thèse est simple : les passerelles IA vont évoluer au-delà du simple routage pour devenir la couche d'orchestration des systèmes agentiques. Elles sélectionneront et remplaceront dynamiquement les modèles en fonction du coût, de la latence, des garde-fous, de la gouvernance, de la sensibilité des données et des exigences de la tâche.
Chaque tâche comporte un profil économique et de risque différent. La passerelle doit le traiter comme tel.
À mesure que les agents se multiplient, l'adéquation intelligente entre les charges de travail et le modèle approprié devient essentielle pour optimiser les coûts et la valeur métier. Cela représente une opportunité majeure pour les entreprises qui cherchent à équilibrer performance, gouvernance et économie à travers des milliers de flux de travail.
Les passerelles traditionnelles étaient conçues autour des points de terminaison, des requêtes, des réponses et des identités de service.
Les agents introduisent des sessions, des plans, des délégations d'autorité, de la mémoire, des appels d'outils et des états persistants. La passerelle doit désormais identifier l'initiateur de la tâche, l'agent en action, l'autorité déléguée, les données accessibles, les outils invocables, le budget alloué, le modèle adapté à chaque étape et les approbations requises.
Ces questions transforment la passerelle en un moteur de décision.
Une consultation de paiement et une exécution de paiement peuvent utiliser la même application et le même protocole, mais leurs profils de risque diffèrent radicalement. La passerelle doit appliquer des politiques basées sur l'intention et l'action.
C'est là que le plan d'action (Action Plane) prend tout son sens. Il régit ce que l'agent peut faire, comment il peut le faire et ce qui doit se produire avant que l'action n'atteigne un système d'enregistrement.
La passerelle LLM gère déjà l'accès aux fournisseurs, les solutions de repli, les limites de débit, les budgets de jetons et l'observabilité.
Sa prochaine mission est plus approfondie : choisir le meilleur modèle pour chaque étape en fonction des capacités, du prix, de la latence, de la longueur du contexte, de la politique de données et de la criticité métier. Le routage passe de règles statiques à une orchestration consciente de la charge de travail.
Le protocole MCP connecte les agents aux outils, aux données et aux systèmes d'entreprise. L'A2A permet aux agents de communiquer et de déléguer des tâches.
La passerelle doit gérer la chaîne de délégation, appliquer les autorisations au niveau des outils, négocier les jetons OAuth, valider les portées, isoler les locataires et enregistrer chaque action. L'identité de l'agent devient une primitive de sécurité fondamentale.
Les entreprises exécuteront des modèles via des API publiques, des clouds privés, des clusters sur site, des environnements souverains et des infrastructures en périphérie (edge).
La passerelle d'inférence détermine où une charge de travail est exécutée en fonction de la capacité, de la localité, de la résidence des données, de la disponibilité des GPU, du coût et de la performance. Cela crée un pont direct entre l'intention applicative et l'économie de l'infrastructure.
Le harnais d'agent gère l'utilisation des outils, les tentatives, la récupération d'erreurs, la compression du contexte, la persistance de la mémoire, le déchargement d'état, l'état des sous-agents, les hooks de cycle de vie, les autorisations, les approbations humaines, la vérification et la télémétrie.
Une fois que ces capacités côtoient le routage et les politiques, la frontière entre la passerelle et le harnais commence à s'estomper.
Le plan de contrôle définit l'identité, les politiques, le routage, les budgets, l'éligibilité des modèles, la résidence des données, les autorisations d'outils, les seuils de risque et les exigences d'approbation.
Il répond aux questions suivantes : que doit-il se passer, dans quelles conditions et avec quelles ressources ?
Le plan d'action appelle les modèles, invoque les outils, gère les sessions, coordonne les agents, traite les tentatives de répétition, enregistre l'état, demande des approbations, valide les résultats et consigne les preuves.
Il répond à la question : comment le travail passe-t-il en toute sécurité de l'intention au résultat ?
Maintenir ces responsabilités connectées crée un avantage majeur. Une panne de modèle peut déclencher une solution de repli sécurisée. Un seuil budgétaire peut rediriger le travail vers un modèle plus léger. Les données sensibles peuvent orienter l'exécution vers un point de terminaison privé. Une action à haut risque peut déclencher une vérification humaine.
Le flux de travail reste dynamique tandis que la politique de l'entreprise demeure cohérente.
La passerelle doit capturer la trajectoire complète : intention de l'utilisateur, plan de l'agent, choix des modèles, sources de contexte, appels d'outils, décisions politiques, approbations, coûts, latence et résultat final.
Cette traçabilité facilite les audits, les revues d'incidents, les comparaisons de modèles, l'ajustement des politiques et la mesure du coût par tâche accomplie.
La passerelle peut compacter les conversations, décharger l'état, isoler la mémoire des sous-agents et contrôler le contexte renvoyé à un modèle. La vérification boucle la boucle grâce à des contrôles de schéma, des règles métier, des tests de fiabilité, une validation déterministe, une revue par un modèle secondaire et une approbation humaine.
La passerelle devient le lieu où le résultat se transforme en action de confiance.
Les flottes d'agents créent une multiplication massive des appels vers les modèles, les outils et les sous-agents. Une seule requête utilisateur peut déclencher des dizaines d'appels en aval, ce qui signifie que la latence de la passerelle, l'utilisation de la mémoire et le débit deviennent rapidement des enjeux de coût et de fiabilité.
La passerelle d'agents adopte une approche fondée sur les principes premiers avec Rust, un moteur d'exécution léger, un débit élevé et une prise en charge native des protocoles d'agents. Son environnement de référence publié affiche environ 30 Mo de mémoire, 165 000 requêtes par seconde et 0,09 milliseconde de latence.
Les chiffres exacts varieront selon la charge de travail et l'infrastructure, mais le principe est clair : chaque milliseconde, chaque tentative de répétition et chaque allocation mémoire supplémentaire se cumulent à travers des milliers d'agents. À l'échelle de l'entreprise, la performance de la passerelle affecte directement le coût d'inférence, l'expérience utilisateur et la capacité de montée en charge de la plateforme avant que l'infrastructure ne devienne un goulot d'étranglement.
Une passerelle unifiée offre aux entreprises un point central pour contrôler les modèles, les outils, les agents, l'inférence, l'identité, les coûts et les preuves.
Les équipes bénéficient de la portabilité des modèles. Les équipes de sécurité disposent d'une application des règles au niveau des actions. Les équipes financières profitent de contrôles budgétaires intégrés aux flux de travail. Les équipes plateforme bénéficient d'un routage entre les fournisseurs et l'infrastructure privée. Les équipes de gestion des risques assurent la traçabilité, de l'intention de l'utilisateur jusqu'à l'action finale.
Les équipes produit gagnent en rapidité, car la plateforme prend en charge les aspects complexes une fois pour toutes.
Les nouveaux modèles peuvent être intégrés rapidement. Les nouveaux outils héritent des politiques existantes. Les nouveaux agents peuvent utiliser les mêmes modèles d'identité, de mémoire, d'observabilité et d'approbation. Chaque cas d'usage s'appuie sur une base commune.
La prochaine phase de l'IA en entreprise sera définie par la qualité de l'orchestration.
Les modèles continueront d'évoluer. Les protocoles vont arriver à maturité. L'inférence se déploiera à travers les clouds et les infrastructures privées. Les agents deviendront plus autonomes et plus profondément connectés aux systèmes centraux.
Les entreprises ont besoin d'une couche unique capable de visualiser l'ensemble du chemin d'exécution et de le moduler en temps réel.
Cette couche, c'est la passerelle IA.
Elle sert de plan de contrôle pour les politiques, l'identité, le routage, la gouvernance et les aspects économiques.
Elle sert de plan d'action pour l'orchestration, les outils, la mémoire, la vérification et l'exécution.
La passerelle gagnante aidera chaque agent à faire le meilleur choix à chaque étape : le bon modèle, le bon outil, la bonne puissance de calcul, le bon contrôle et le niveau d'intervention humaine approprié.
C'est ainsi que les entreprises transforment l'activité liée à l'IA en valeur commerciale réelle.
Ce qui me frappe, c'est la manière dont TrueFoundry réunit le routage de modèles, l'accès MCP, l'exécution d'agents et la gestion de l'inférence au sein d'une plateforme gouvernée. La passerelle gère l'authentification, les limites de débit, les budgets, les garde-fous, l'observabilité et le basculement entre les modèles hébergés et autogérés. Sa couche MCP ajoute une découverte contrôlée des outils, l'OAuth, l'échange de jetons et des politiques au niveau des outils, tandis qu'Agent Hub étend ces mêmes contrôles à l'orchestration et à l'exécution des sous-agents. Concrètement, les entreprises disposent d'un chemin cohérent, de la sélection du modèle à l'utilisation des outils jusqu'à l'action finale. C'est exactement ce à quoi devrait ressembler un plan de contrôle et d'action opérationnel.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















