



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: October 6, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
De nouveaux fournisseurs d'inférence pour les modèles à poids ouverts semblent voir le jour toutes les quelques semaines, promettant chacun un débit de jetons par seconde plus élevé sur la même poignée de modèles que tout le monde utilise déjà. Pour les équipes d'ingénierie, le problème n'est que rarement de savoir si un fournisseur est assez rapide. C'est ce qui se passe après : une nouvelle URL de base, une nouvelle clé API, une nouvelle configuration d'observabilité et une série de chemins de code applicatif qui doivent désormais être testés par rapport à un énième schéma. L'arrivée de Wafer au sein de la passerelle IA de TrueFoundry élimine ce second problème, ne laissant que la première question : le modèle est-il assez rapide pour la charge de travail ?
La passerelle IA de TrueFoundry se place entre les applications et chaque modèle qu'elles appellent, exposant une interface unique compatible avec OpenAI, quel que soit le fournisseur qui traite réellement la requête en arrière-plan. Au lieu qu'une application doive gérer un client différent, une clé différente et une politique de nouvelle tentative différente pour chaque fournisseur, elle envoie chaque requête vers un point de terminaison unique et laisse la passerelle déterminer où cette requête doit réellement aboutir.
Cette résolution s'effectue via ce que TrueFoundry appelle des modèles virtuels : des identifiants de modèles logiques qui correspondent à un ou plusieurs fournisseurs physiques, avec un routage décidé par priorité, poids ou latence. Les nouveaux fournisseurs ne nécessitent aucun nouveau code d'intégration côté application. Ils sont ajoutés en tant que compte fournisseur avec un ensemble de modèles enregistrés, et chaque application déjà pointée vers la passerelle peut commencer à les utiliser dès leur activation.
Wafer est un fournisseur d'inférence hébergé conçu spécifiquement pour servir rapidement les modèles à poids ouverts. Son argument ne réside pas dans un catalogue de modèles plus large, mais dans une exécution plus rapide des modèles que les équipes souhaitent déjà utiliser, obtenue en optimisant l'intégralité de la pile d'inférence pour un matériel spécifique plutôt qu'en servant les modèles sur une pile générique. Grâce à TrueFoundry, cette vitesse est disponible pour GLM 5.2, proposé sous forme de complétion de chat serverless avec streaming et appel d'outils.
Wafer traite également la gestion des données comme une option native plutôt que comme un module complémentaire pour entreprise. Les requêtes peuvent être marquées pour une rétention de données nulle au cas par cas, et Wafer isole le trafic tout en offrant une disponibilité garantie par SLA pour les charges de travail nécessitant ces assurances, sans exiger de contrat spécifique pour activer cette option.
La connexion entre les deux consiste simplement à enregistrer Wafer en tant que compte fournisseur dans la section Modèles de la passerelle. Le formulaire de compte demande une URL de base, qui utilise par défaut le point de terminaison pass.wafer.ai/v1 de Wafer, une clé API et une option pour la rétention de données nulle, activée par défaut. L'activation de cette option indique à la passerelle d'ajouter un en-tête Wafer-ZDR: required à chaque requête envoyée à Wafer, afin que le comportement de rétention soit appliqué au niveau de la requête plutôt que laissé à une configuration globale du compte.
Une fois le compte créé, les modèles de chat individuels sont enregistrés par leur nom d'affichage et leur identifiant de modèle Wafer exact, tel que glm-5.2. Ce qui rend cette intégration particulièrement légère, c'est que l'API de Wafer utilise déjà nativement le schéma de complétion de chat d'OpenAI. L'adaptateur de fournisseur de la passerelle, qui traduit normalement les requêtes dans le format propre à chaque partenaire, n'a ici rien à traduire. Il transmet la requête pratiquement inchangée, ce qui explique également pourquoi les clients existants compatibles avec OpenAI peuvent pointer directement vers Wafer en changeant simplement l'URL de base et la clé.
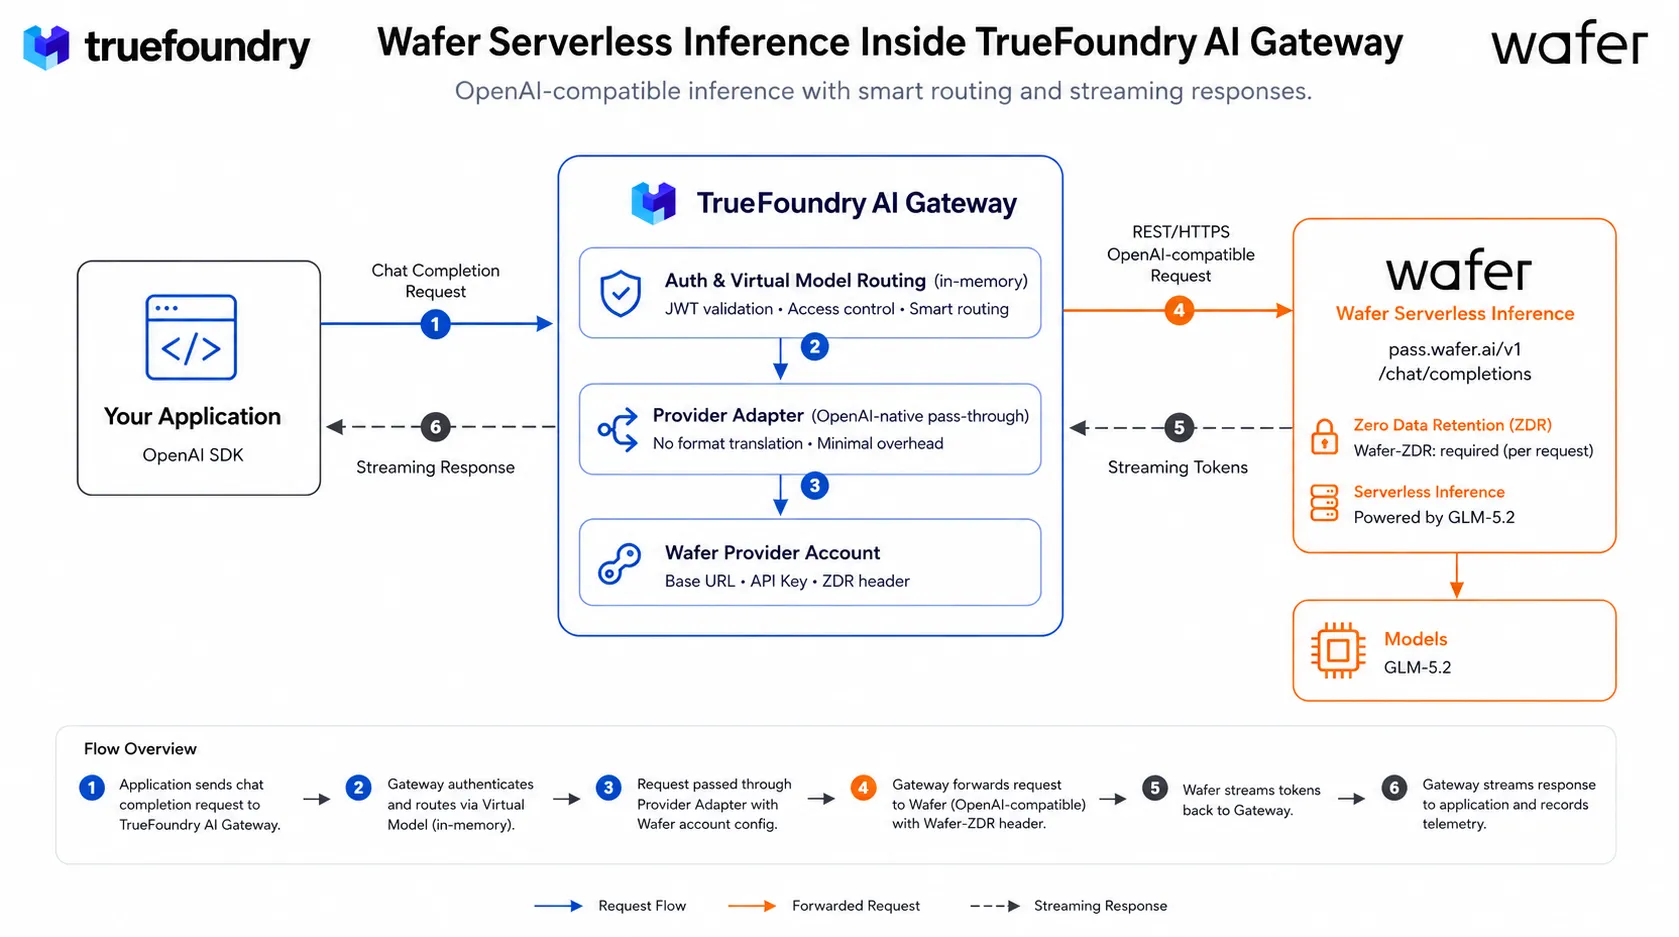
Une requête ciblant un modèle pris en charge par Wafer suit le même chemin que n'importe quel autre modèle sur la passerelle :
1. Une application appelle le point de terminaison de complétion de chat de la passerelle avec un identifiant de modèle sous la forme your-wafer-account/glm-5.2, en utilisant le SDK standard d'OpenAI.
2. La passerelle valide le JWT de la requête par rapport aux clés publiques mises en cache et vérifie l'accès de l'appelant via une carte en mémoire associant les utilisateurs aux modèles, le tout sans appel externe.
3. L'identifiant du modèle virtuel est résolu vers le compte fournisseur Wafer enregistré, incluant son URL de base, sa clé API et son paramètre de rétention de données nulle.
4. La requête est transmise à pass.wafer.ai/v1/chat/completions via HTTPS. Comme Wafer utilise déjà le schéma OpenAI, l'adaptateur de fournisseur de la passerelle n'effectue aucune modification de format, se contentant d'ajouter l'en-tête Wafer-ZDR lorsque la rétention est définie sur required.
5. Wafer exécute l'inférence sur le modèle GLM 5.2 demandé et diffuse les jetons au fur et à mesure de leur génération.
6. La passerelle diffuse la réponse vers l'application et publie de manière asynchrone le nombre de jetons, la latence et le coût vers son pipeline de télémétrie, exactement comme elle le ferait pour n'importe quel autre fournisseur.
Aucune de ces étapes n'est spécifique à Wafer. C'est là tout l'intérêt : un nouveau fournisseur d'inférence rapide devient une cible de routage plutôt qu'une nouvelle surface d'intégration, ce qui permet à un compte Gateway d'adopter de nouveaux fournisseurs dès qu'ils ont fait leurs preuves, sans que chaque application n'ait besoin d'une modification de code.
Depuis le tableau de bord TrueFoundry, ouvrez AI Gateway, puis Models, et sélectionnez Wafer pour ajouter un compte et enregistrer vos modèles de chat. Appelez-les via le Playground ou directement via le client compatible OpenAI, en définissant le modèle sur votre nom de compte et votre identifiant de modèle. Les étapes de configuration complètes et des exemples de code sont disponibles dans la documentation TrueFoundry AI Gateway pour Wafer, ainsi que dans le guide de configuration du routeur de Wafer.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















